Kurz gesagt
- Anthropic veröffentlichte Claude Sonnet 5.5 am Montag zu 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token – unverändert gegenüber Sonnet 5 und halb so teuer wie Opus 5.5.
- Sonnet 5.5 erzielte laut Anthropic 70,6 % bei Terminal-Bench 4.0 gegenüber 66,4 % bei Opus 5.5; der unabhängige Tester Artificial Analysis sieht es ebenfalls vorn, mit 63,6 % zu 59,6 %.
- Artificial Analysis stuft es auf Platz zwei hinter Opus 5.5 ein, sagt jedoch, dass es pro Aufgabe mehr Token verbrauchte als jedes andere getestete Modell.
Anthropic veröffentlichte am Montag Claude Sonnet 5.5, ein Upgrade zu Sonnet 5 vom Juni. Anthropic zufolge läuft dieses Modell der mittleren Stufe mehr als 30 % schneller als sein Vorgänger.
„Sonnet 5.5 ist am stärksten bei klar umrissenen Alltagsaufgaben, beim Beheben von Fehlern und beim Erstellen von ausgefeilten Dokumenten, Folien und Tabellen. Es hat außerdem ein scharfes Auge für Design“, schrieb Anthropic.
Der Preis bleibt bei 2 $ pro Million Eingabe-Token und 10 $ pro Million Ausgabe-Token. Token sind die Textblöcke, die eine KI liest und schreibt, etwas kürzer als ein Wort, und Unternehmen rechnen nach Millionen ab. Das ist die Hälfte dessen, was Opus 5.5 berechnet. Allerdings verbraucht es pro Aufgabe fast ein Drittel weniger Token, was bedeutet, dass es letztendlich günstiger zu betreiben ist als Sonnet 5.
Allerdings glänzt dieses Modell beim Programmieren. Bei Terminal-Bench 4.0 – einem Test, ob ein KI-Agent komplexe professionelle Aufgaben selbstständig durch Eingabe von Befehlen erledigen kann, bewertet als Anteil der abgeschlossenen Aufgaben – erreichte Sonnet 5.5 70,6 %. Opus 5.5 erzielte 66,4 %, und Sonnet 5 schaffte 10,3 %.
Einfach ausgedrückt: Das günstigere Modell erledigte mehr Aufgaben. Artificial Analysis, ein unabhängiges Testunternehmen, führte seine eigene Version durch und stimmt zu: 63,6 % für Sonnet 5.5, 59,6 % für Opus 5.5 und 59,1 % für OpenAI's GPT-6 Astra.
Claude Sonnet 5.5 (max) macht große Fortschritte bei Terminal-Bench und gehört zu den Top-Modellen sowohl bei Terminal-Bench 4.0 als auch bei Terminal-Bench-Science. Bei Terminal-Bench 4.0 erzielt es 64 %, eine Steigerung um 50 Punkte gegenüber Claude Sonnet 5 (max), und etwas mehr als 60 % für Opus 5.5 und GPT-6… pic.twitter.com/7CPrhgmfxe
— Artificial Analysis (@ArtificialAnlys) 28. September 2026
Die Punktzahlen hängen auch von der Effort-Einstellung ab, einem Regler, der ein Modell länger nachdenken lässt, um eine bessere Antwort und eine höhere Rechnung zu erzielen. Anthropic sagt, dass Sonnet 5.5 bei hohem Effort auf FrontierCode mit GPT-6 Sol mithält, bei etwa einem Fünftel der Kosten pro Aufgabe.
Bei GDPval-AA, das reale professionelle Arbeit in 44 Berufen anhand von Elo bewertet – dem schachähnlichen System, das relative Fähigkeiten einordnet –, erzielte Sonnet 5.5 1844 Punkte gegenüber 1846 von Opus 5.5, effektiv ein Gleichstand. GPT-6 Sol erzielte 1487.
Konkurrenten ziehen beim Preis nach. OpenAI senkte GPT-6 Sol letzte Woche auf 2 und 10 US-Dollar, und GPT-5.6 Terra, sein Modell der Mittelklasse, ist mit 2 und 12 US-Dollar gelistet. Anthropic veröffentlichte keine Terra-Benchmarks.
Der Haken
Sonnet 5.5 ist ein Vielredner. Bei maximalem Effort schrieb es etwa 193.000 Token pro Testaufgabe, der höchste von Artificial Analysis gemessene Wert und rund 60 % mehr als Opus 5.5. Das ergab 7,60 US-Dollar pro Aufgabe, etwa 50 % mehr als Sonnet 5, was gegen Anthropics Behauptung von bis zu 30 % Einsparungen spricht.
Anthropics Einsparungen kommen von niedrigeren Einstellungen: Bei mittlerem Effort, dem Standard in seinen Apps, sagt es, dass Sonnet 5.5 die beste Coding-Punktzahl von Sonnet 5 für weniger als ein Zehntel der Kosten übertrifft. Artificial Analysis sagt, hoher Effort sei das beste Preis-Leistungs-Verhältnis. Für Alltagsnutzer bedeutet das nahezu Flaggschiff-Coding zu einem Bruchteil des Preises, solange der Regler niedrig bleibt.
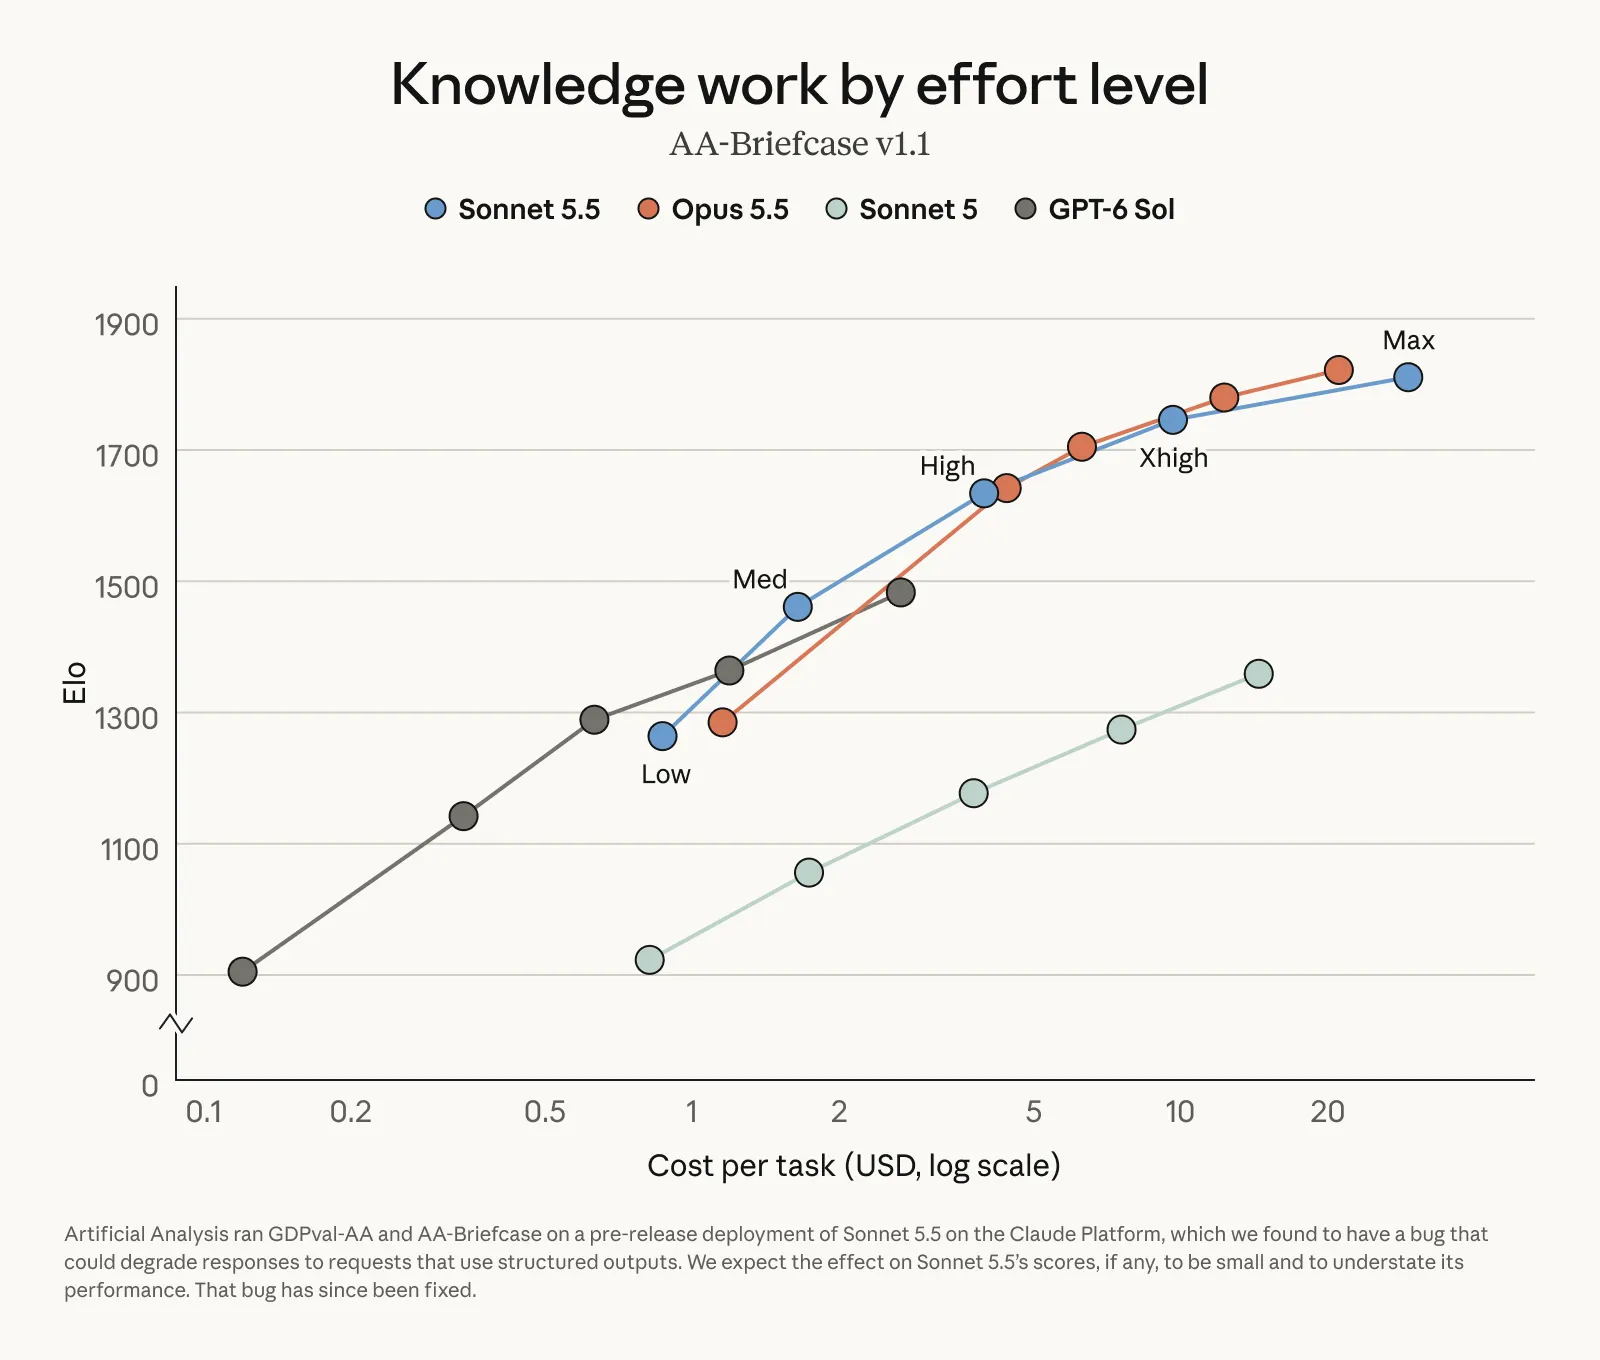
Die Tabelle von Anthropic basiert auf Selbstauskünften, und Artificial Analysis testete einen Vorab-Build mit einem Fehler, von dem Anthropic erwartet, dass er die Ergebnisse kaum oder nur leicht nach unten verzerrt hat. Anthropic sagt, dass Opus 5.5 bei komplexen Aufgaben, die anhaltendes Urteilsvermögen erfordern, weiterhin deutlich stärker bleibt.
Claude Haiku 5.5, entwickelt für Anwendungen mit hohem Volumen und Kostenempfindlichkeit, soll in den kommenden Wochen erscheinen.