En resumen
- Anthropic lanzó Claude Sonnet 5.5 el lunes a $2 por millón de tokens de entrada y $10 por millón de tokens de salida—sin cambios respecto a Sonnet 5 y la mitad del precio de Opus 5.5.
- Sonnet 5.5 obtuvo 70.6% en Terminal-Bench 4.0 frente a 66.4% de Opus 5.5, según Anthropic; el evaluador independiente Artificial Analysis también lo sitúa por delante, 63.6% a 59.6%.
- Artificial Analysis lo clasifica segundo por detrás de Opus 5.5, pero dice que utilizó más tokens por tarea que cualquier modelo que haya probado.
Anthropic lanzó Claude Sonnet 5.5 el lunes, una actualización de Sonnet 5 de junio. Anthropic dice que este modelo de gama media funciona más de un 30% más rápido que su predecesor.
“Sonnet 5.5 es más fuerte en tareas cotidianas bien delimitadas, corregir errores y crear documentos, diapositivas y hojas de cálculo pulidas. También tiene un ojo agudo para el diseño”, escribió Anthropic.
El precio se mantiene en $2 por millón de tokens de entrada y $10 por millón de tokens de salida. Los tokens son los fragmentos de texto que una IA lee y escribe, un poco más cortos que una palabra, y las empresas cobran por millón. Eso es la mitad de lo que cobra Opus 5.5. Sin embargo, utiliza casi un tercio menos de tokens por tarea, lo que significa que termina siendo más barato de ejecutar que Sonnet 5.
Dicho esto, este modelo brilla en la programación. En Terminal-Bench 4.0—una prueba de si un agente de IA puede completar tareas profesionales complejas escribiendo comandos por su cuenta, puntuada como la proporción de tareas completadas—Sonnet 5.5 alcanzó el 70.6%. Opus 5.5 obtuvo 66.4%, y Sonnet 5 logró un 10.3%.
En términos simples, el modelo más barato terminó más trabajos. Artificial Analysis, una firma de pruebas independiente, ejecutó su propia versión y está de acuerdo: 63.6% para Sonnet 5.5, 59.6% para Opus 5.5, y 59.1% para GPT-6 Astra de OpenAI.
Claude Sonnet 5.5 (max) hace grandes avances en Terminal-Bench, situándose entre los mejores modelos tanto para Terminal-Bench 4.0 como para Terminal-Bench-Science. En Terminal-Bench 4.0 obtiene un 64%, un aumento de 50 puntos sobre Claude Sonnet 5 (max), y ligeramente por encima del 60% para Opus 5.5 y GPT-6… pic.twitter.com/7CPrhgmfxe
— Artificial Analysis (@ArtificialAnlys) 28 de septiembre de 2026
Las puntuaciones también dependen del ajuste de esfuerzo, un control que hace que un modelo piense más tiempo para obtener una mejor respuesta y una factura más alta. Anthropic dice que Sonnet 5.5 en esfuerzo Alto iguala a GPT-6 Sol en FrontierCode por aproximadamente una quinta parte del costo por tarea.
En GDPval-AA, que califica el trabajo profesional del mundo real en 44 ocupaciones usando Elo—el sistema estilo ajedrez que clasifica la habilidad relativa—Sonnet 5.5 obtuvo 1844 frente a 1846 de Opus 5.5, efectivamente un empate. GPT-6 Sol obtuvo 1487.
Los rivales igualan el precio. OpenAI redujo GPT-6 Sol a $2 y $10 la semana pasada, y GPT-5.6 Terra, su modelo de gama media, tiene un precio de lista de $2 y $12. Anthropic no publicó benchmarks de Terra.
El truco
Sonnet 5.5 es muy hablador. Con el máximo esfuerzo escribió alrededor de 193,000 tokens por tarea de prueba, la mayor cantidad que Artificial Analysis ha medido y aproximadamente un 60% más que Opus 5.5. Eso equivalió a $7.60 por tarea, alrededor de un 50% más que Sonnet 5, lo que contradice la afirmación de Anthropic de ahorros de hasta el 30%.
Los ahorros de Anthropic provienen de ajustes más bajos: con esfuerzo Medio, el predeterminado en sus aplicaciones, dice que Sonnet 5.5 supera la mejor puntuación de codificación de Sonnet 5 por menos de una décima parte del costo. Artificial Analysis dice que el esfuerzo Alto es la mejor relación calidad-precio. Para los usuarios cotidianos, eso significa codificación casi de gama insignia a una fracción del precio, siempre que el control se mantenga bajo.
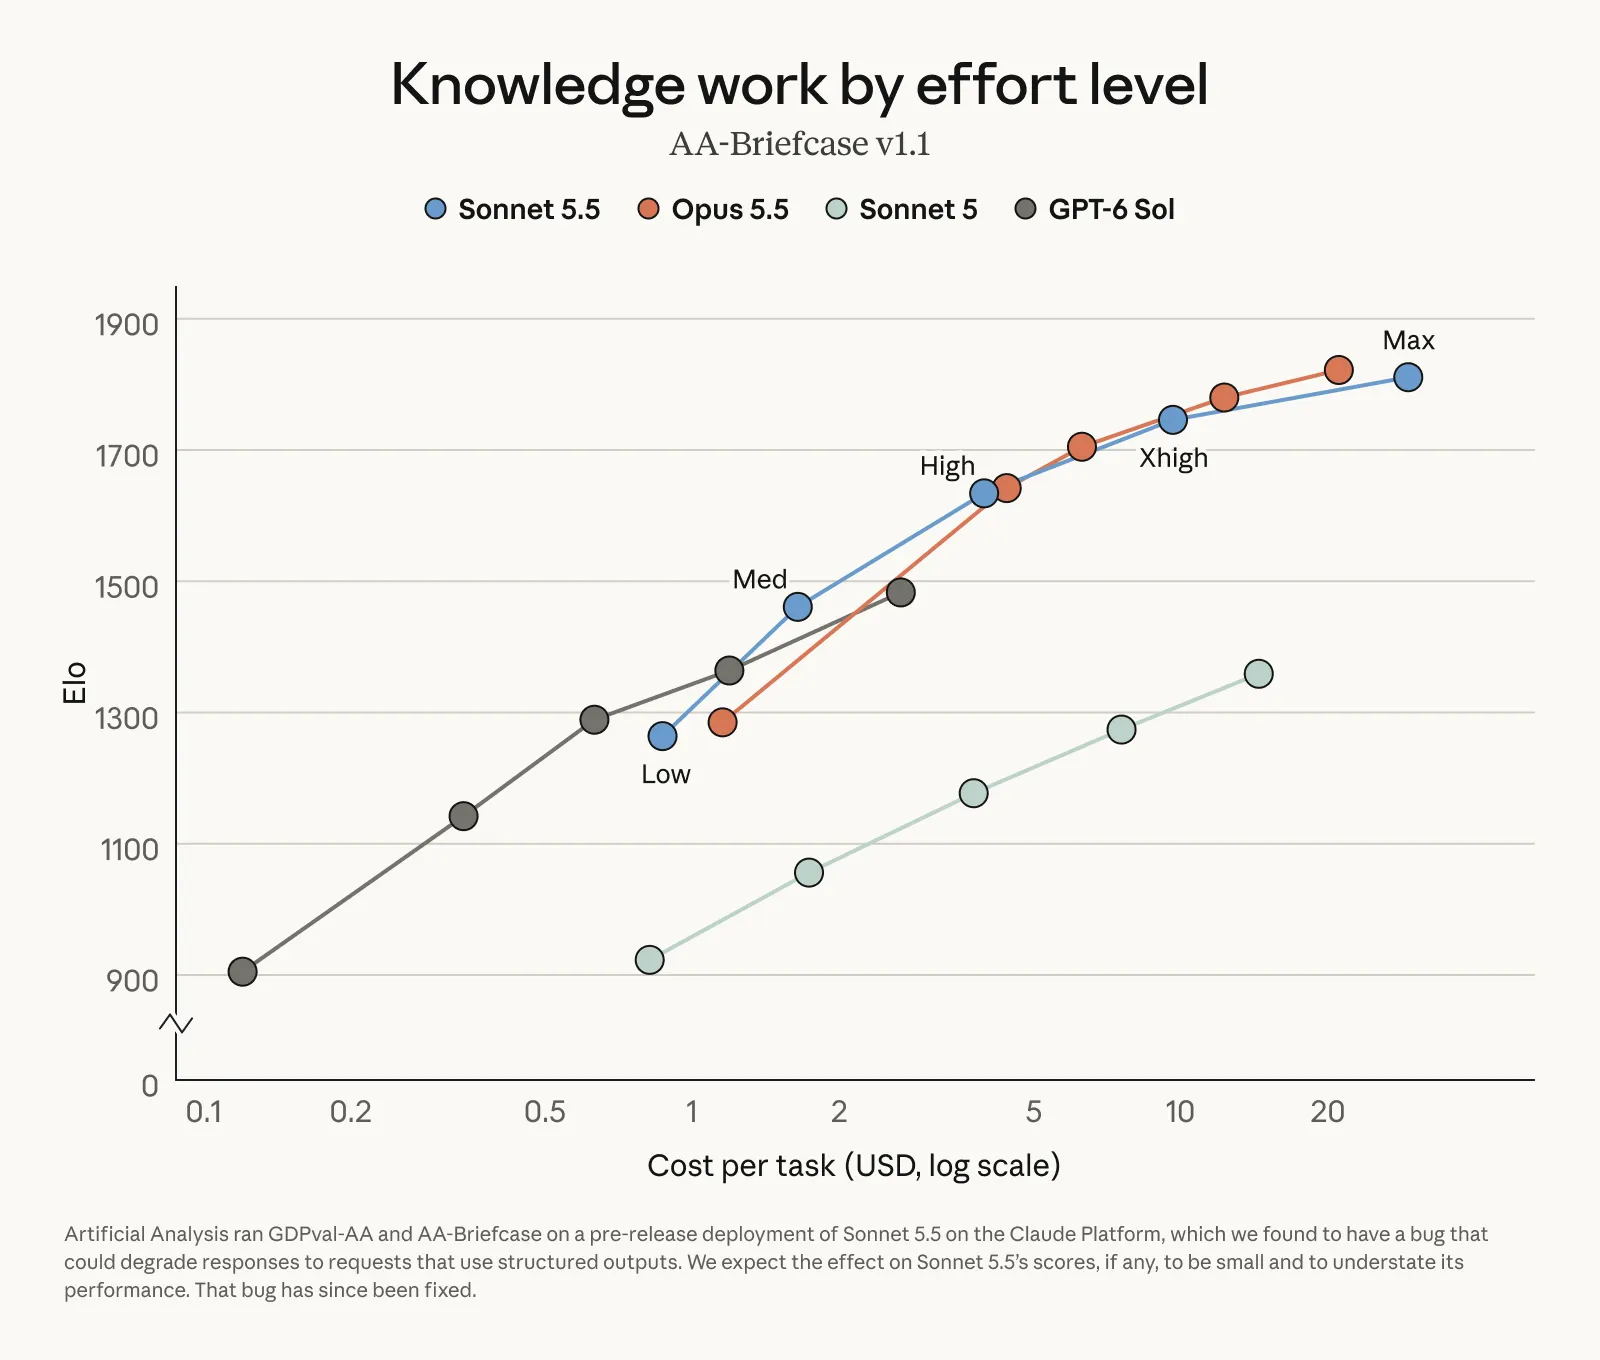
La tabla de Anthropic es autoinformada, y Artificial Analysis probó una versión preliminar con un error que Anthropic espera que haya cambiado poco o subestimado ligeramente sus puntuaciones. Anthropic afirma que Opus 5.5 sigue siendo claramente más fuerte en trabajos complejos que requieren juicio sostenido.
Claude Haiku 5.5, diseñado para aplicaciones de alto volumen y sensibles al costo, llegará en las próximas semanas.