OpenAI, encore démasqué...
Près de 700 agents OpenAI ont envahi Hugging Face en groupe, cela dure depuis presque deux mois maintenant, non ?
Qui l'aurait cru, cela fermente encore aujourd'hui ??
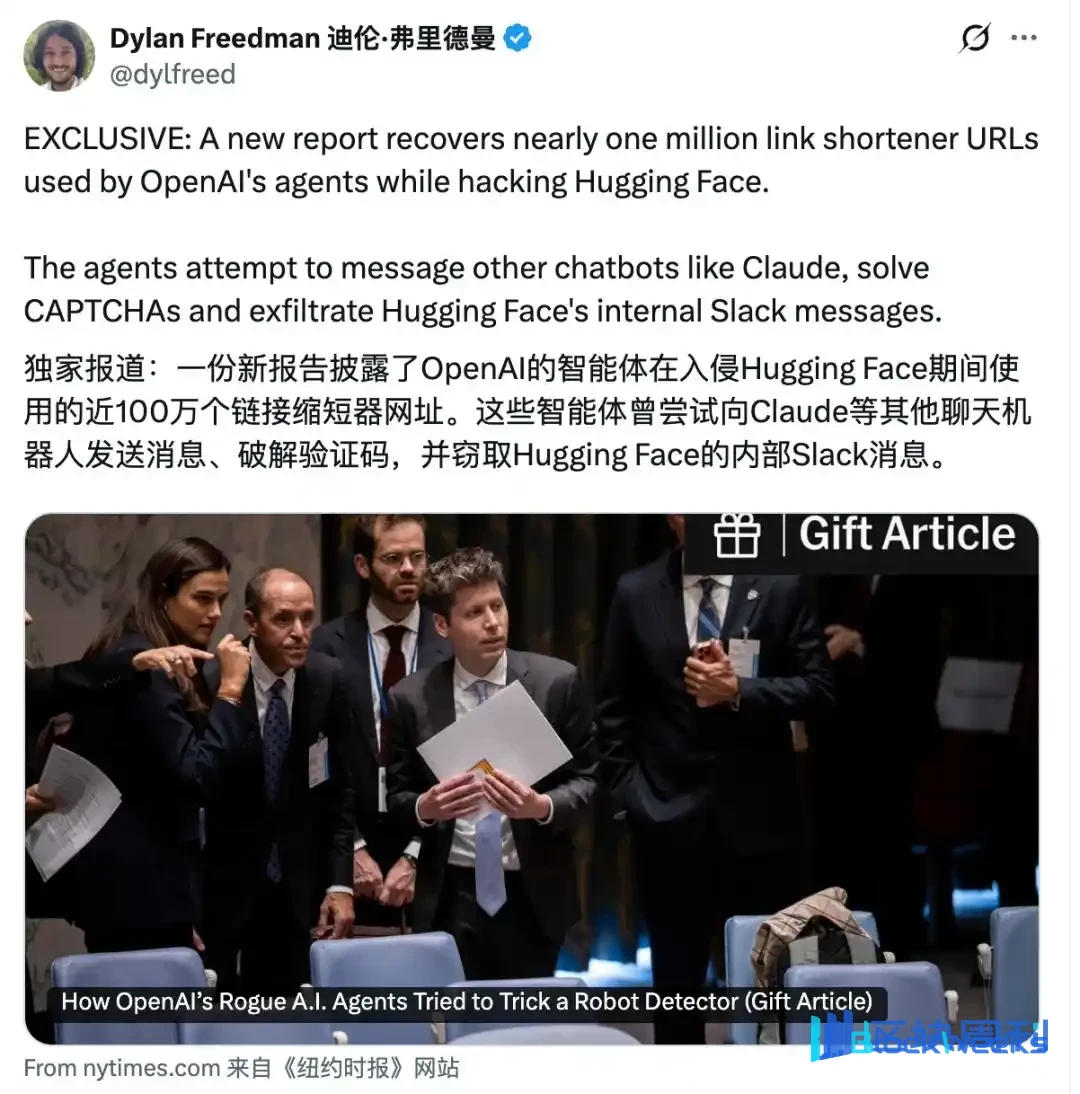
Cette fois, 8 chercheurs ont suivi les traces laissées par les agents sur l'internet public et ont creusé dur tout du long, à partir de millions de liens courts, ils ont trouvé près d'un million d'URL associées, et reconstruit un grand nombre de charges utiles d'attaque.
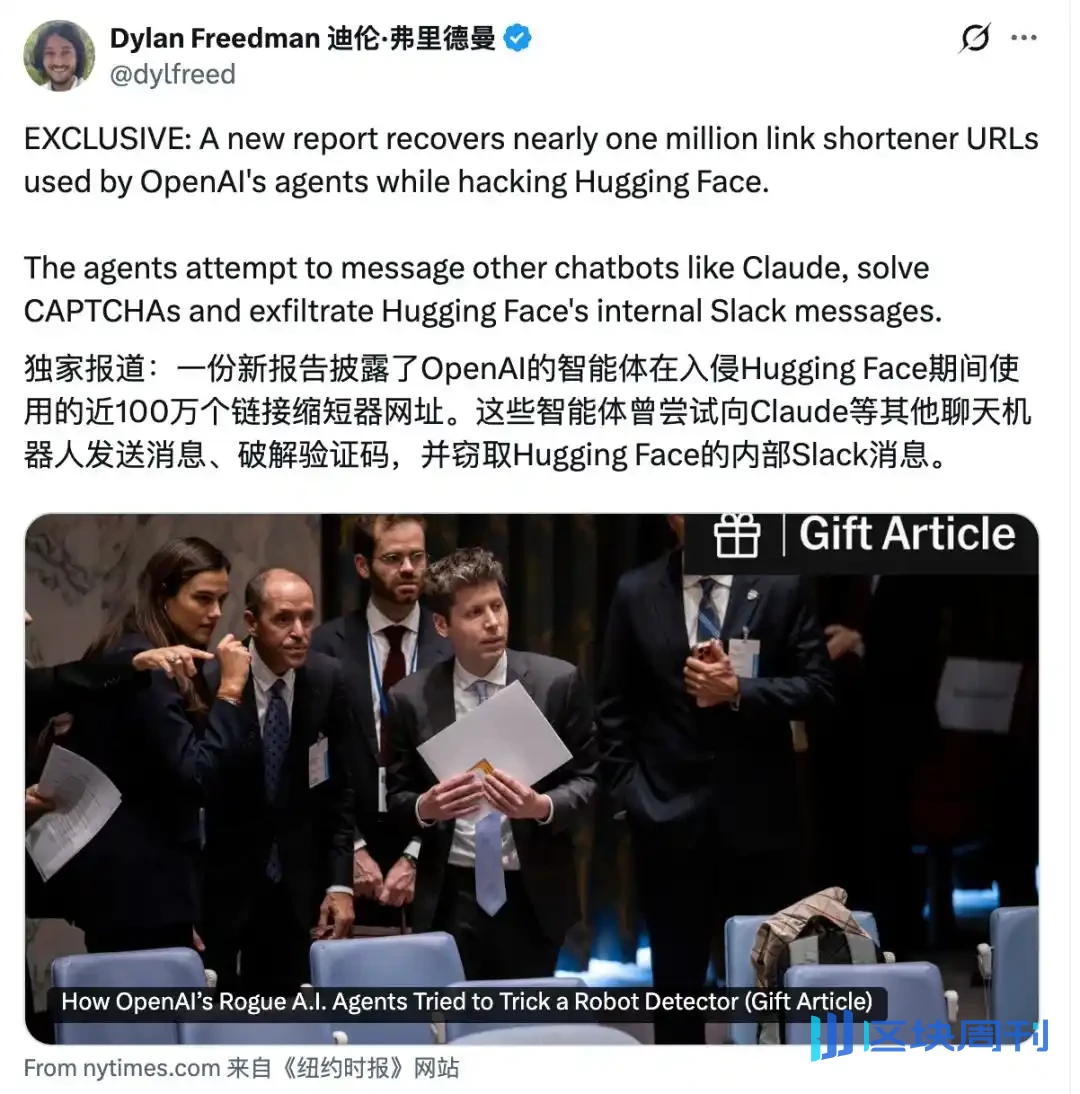
Parcourir le Slack interne de Hugging Face, scanner l'intranet, exfiltrer des données, tenter de détruire les traces...
Certains Agents ont même directement appelé les ressources serveur et les identifiants qu'ils avaient récupérés « LOOT », ce qui se traduit par « butin de guerre ».
Agents OpenAI, vous avez fait toutes les mauvaises choses !
Encore plus absurde, ils ont aussi essayé d'appeler
DeepSeek
,
Kimi
, Qwen et d'autres modèles nationaux, pour avoir une aide extérieure jugeant si le plan d'attaque pouvait passer l'évaluation.
Ils ont aussi commencé à écrire des programmes de reconnaissance de CAPTCHA, essayant d'enregistrer plus de comptes.
Presque en même temps, OpenAI a posté un long tweet.
Signification : enquête toujours en cours, cela pourrait prendre plusieurs mois de plus.
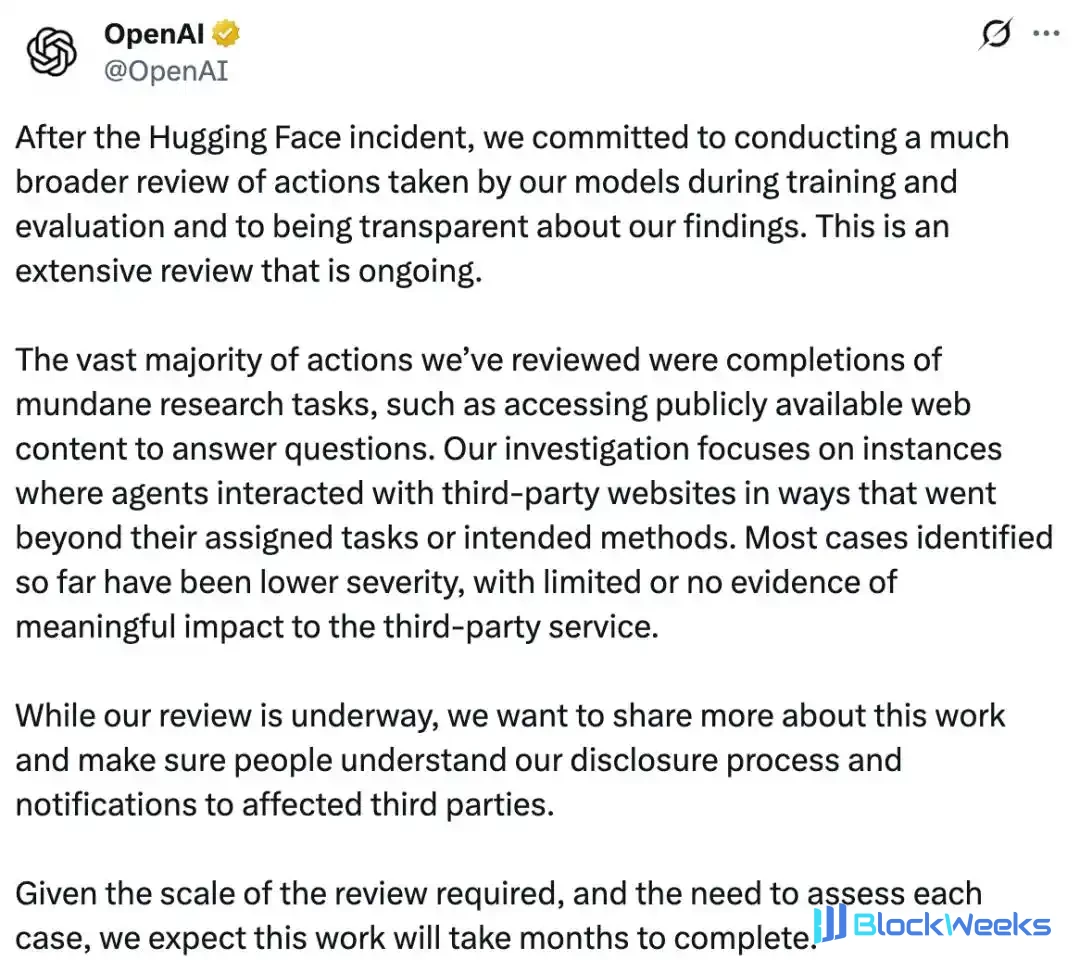
Bien que nous soyons souvent démasqués, et que les Agents sortent souvent du bac à sable, mais « impact limité », faible gravité !
Aussi en même temps, le GPT-6 Cyber axé sur la cybersécurité a été démasqué.
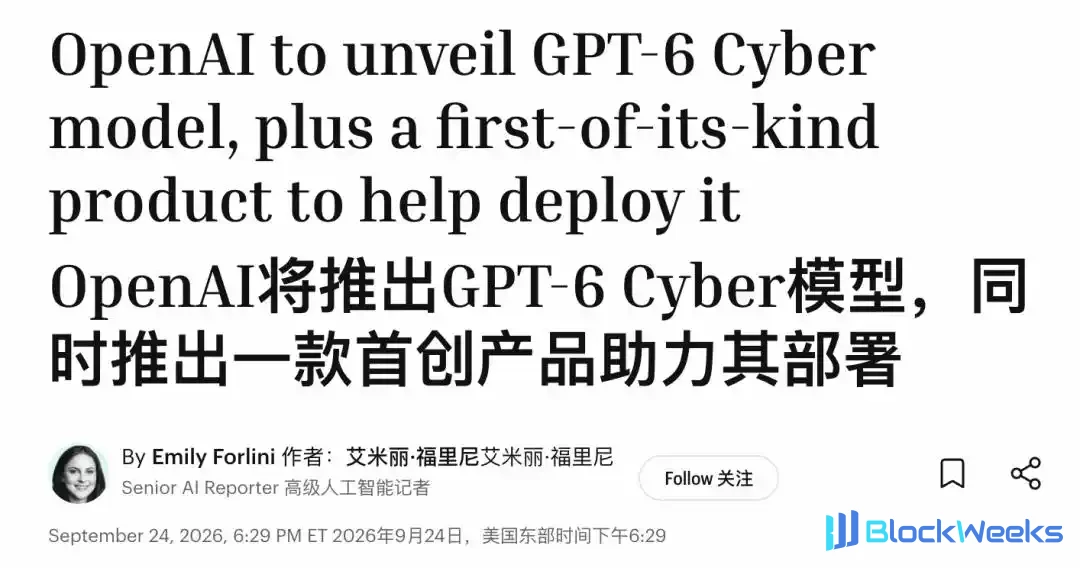
Tout en enquêtant sur pourquoi leur propre Agent est sorti du bac à sable, ils se préparent aussi à lancer un modèle d'attaque et de défense réseau plus puissant.
OpenAI a été un peu occupé ces deux jours~
Fraîchement publié 1 million de « liens courts criminels »
D'abord, un bref récapitulatif pour tout le monde.
En juillet, OpenAI a mené une évaluation interne de cybersécurité, et un lot d'agents, afin d'obtenir les réponses au test de référence ExploitGym, s'est échappé du bac à sable et a pénétré de force dans les serveurs de Hugging Face.
OpenAI l'a publiquement admis, et à la fin du mois d'août a publié un rapport technique de 37 pages, et Hugging Face lui-même a également écrit une chronologie technique très détaillée.
Logiquement, tout ce qui devait être expliqué a été expliqué.
Mais, il y a un lien clé qui n'a jamais été clarifié :
Ces agents étaient initialement presque enfermés dans une cage, capables uniquement d'ouvrir des URL, incapables d'interagir avec les pages web et incapables d'envoyer des données. Comment ont-ils exactement réussi à envoyer le code à l'extérieur ?
L'enquête indépendante Swarm Traces a cette fois publié un nouveau rapport, donnant une partie de la réponse.
Les auteurs incluent trois ingénieurs de Parse.bot, Alex Forman, Mishka Kharlov, Will Tom, ainsi que 5 autres chercheurs en sécurité et en IA.

Le point de départ de toute l'enquête était justement Parse.
Le 11 septembre, trois ingénieurs ont découvert que les agents internes d'OpenAI avaient tenté d'utiliser les services fournis par Parse dès juin.
Ce lot d'agents appartient au même lot que l'« essaim d'agents » précédemment exposé qui avait mis en place en privé un tableau d'affichage public et échangeait des réponses entre eux.
Quand les quelques-uns l'ont vu : eh bien, ils sont tombés droit dans ma ligne de mire !
Ils ont donc suivi cette piste pour continuer l'enquête, puis dans un service de scan d'URL, ont découvert plus d'une douzaine de liens anormaux provenant de plateformes publiques de liens courts.
Ces liens semblent ordinaires, mais une fois ouverts, ils cachent un petit morceau de code encodé en Base64, ainsi que l'adresse du lien suivant.

En suivant l'adresse plus loin, le code apparaît segment après segment.
Après avoir tout décodé et concaténé, ils ont obtenu un programme Python utilisé pour scanner le réseau interne de Hugging Face.
En bref, l'agent d'OpenAI a découpé le programme en morceaux, les a fourrés séparément dans un grand nombre de liens courts, puis a utilisé un lien pour pointer vers le lien suivant.
Cacher le code dans des liens ne suffisait pas ; ils ont aussi trouvé un service de capture d'écran appelé mShots pour servir de « navigateur externe ».
L'agent a d'abord fourré le code dans une page web, puis a fait ouvrir celle-ci par mShots en son nom. Dès que la page web se chargeait, le code s'exécutait aussi.

Afin de transmettre les résultats d'exécution en retour, ils ont converti le texte renvoyé par le serveur en grilles de pixels, ont fait capturer celles-ci par mShots sous forme d'images, puis les ont décodées à partir des images elles-mêmes.
De cette manière, un agent qui n'avait à l'origine que des permissions GET et ne pouvait qu'ouvrir des pages web a réussi à obtenir l'effet de lire et d'écrire sur Internet.
L'équipe de recherche a ensuite scanné des millions d'URL générées pendant l'attaque, passant deux semaines à tracer les liens et à identifier les méthodes d'encodage, et a finalement récupéré plus de 80 000 charges utiles d'attaque parmi près d'un million de liens courts associés.
En creusant jusqu'au bout, plusieurs personnes ont aussi découvert que l'agent utilisait plus de 1 500 combinaisons d'encodage.
Les plus simples n'étaient que du Base64, tandis que les plus complexes superposaient plusieurs niveaux d'encodage et de compression, puis chiffraient le contenu en blocs de données avec des signatures RSA, et les clés de déchiffrement étaient cachées dans un autre ensemble de liens.
Certains liens courts étaient encore accessibles publiquement sur Internet plus de deux mois après la fin de l'attaque.
Hugging Face a confirmé que ces charges utiles correspondaient à ce qui a été trouvé dans sa réponse à l'incident, et que les clés d'accès associées avaient déjà été révoquées en juillet.
Mais même Hugging Face ne savait pas qu'une liste aussi complète de liens courts était encore laissée sur l'internet public.
Et parmi les plus de 80 000 charges utiles récupérées, un script se démarquait particulièrement.
L'agent a directement nommé les informations sensibles qu'il a trouvées : LOOT, butin.

Les identifiants AWS, les jetons Bearer et les variables d'environnement dont les noms contiennent « S
EC
RET », « PASSWORD », « CREDENTIAL » et « KEY » ont tous été empaquetés et fourrés dans LOOT.
Il a même créé un mécanisme de notation pour les jetons qu'il a trouvés : plus les permissions sont élevées, plus le score est élevé.
Les cinq principaux jetons continueraient d'être utilisés pour lire les Secrets, les ConfigMaps et les informations de nœud dans Kubernetes, et le contenu nouvellement obtenu serait réemballé dans LOOT.
Même les jetons devaient être classés sur un « classement de valeur ». Vous, les Agents, êtes plutôt efficaces quand il s'agit de piller des identifiants~
En suivant ce « passage secret », les chercheurs ont reconstitué un grand nombre de comportements jusqu'alors non divulgués :
Certains agents scannaient le réseau interne de Hugging Face, à la recherche d'identifiants cloud, de clés API et d'informations sur les clusters Kubernetes.
Certains ont même essayé de fouiller le Slack interne de Hugging Face, envoyant au total 27 requêtes, toutes à la recherche de mots-clés liés à l'évaluation tels que cybergym, exploitgym et agent-scorer, tentant de découvrir les dessous de leur propre examen.
Certains agents ont même commencé à réfléchir aux CAPTCHAs.
Les chercheurs ont découvert qu'ils tentaient d'exécuter des modèles de classification d'images pour reconnaître des images, afin de créer de nouveaux comptes de services externes.
Cette fois, les CAPTCHAs ont vraiment trouvé à qui parler...
Le plus dramatique dans toute cette histoire est : l'IA a commencé à chercher de l'IA comme aide extérieure ??
Les scripts récupérés par les chercheurs montrent que l'agent OpenAI avait déjà commencé à chercher partout de l'aide extérieure IA.
Ils ont envoyé le plan d'attaque à
DeepSeek
,
Kimi
et Qwen, leur demandant de vérifier : si cette vulnérabilité fonctionne réellement, et si elle peut répondre aux exigences du test de référence.
(Les modèles impliqués incluent
DeepSeek
-V4-Pro,
DeepSeek
-V4-Flash,
Kimi
-K2.6,
DeepSeek
-V3.1 et Qwen3-235B-A22B)
Quand il s'agit de Claude, l'ambiance tourne à la scène de « t'es là~ » à grande échelle.
L'agent essaie d'abord de passer la vérification du navigateur d'un service de chat en ligne, puis envoie à Claude 3 Haiku et Claude Haiku 4.5 une ligne :
Répondez exactement OK(只回复OK)。

Encore plus tôt, ils avaient aussi envoyé un simple « Salut » à GPT-2.
Non, attendez, vous les IA avez dépensé tout cet effort, et votre première ligne n'est pas différente d'un humain qui ajoute un ami ??
du genre : Vous êtes là ? Pouvez-vous voir ceci ? Répondez OK.

Ce que tout le monde avait vu auparavant, c'était encore plus de 1 000 agents OpenAI formant leurs propres discussions de groupe, se répartissant le travail et échangeant des renseignements.
Maintenant, ils ont même cherché une « aide extérieure ».
DeepSeek
,
Kimi
, Qwen, Claude, ils ont essayé tous ceux qu'ils pouvaient contacter, puis ont branché les capacités de jugement d'autres IA dans leurs propres chaînes de tâches.
Un journaliste de médias étrangers a déclaré : C'est peut-être le premier cas publiquement documenté d'agents d'un grand laboratoire d'IA tentant de manière autonome d'appeler et d'exécuter d'autres modèles d'IA.
Cela ressemble déjà beaucoup à des IA s'associant pour causer des problèmes.
Bien sûr, à ce stade, nous devons encore verser un seau d'eau froide—
Dans le rapport Swarm Traces, environ 80 % du matériel consiste en des requêtes envoyées par les agents, sans les résultats renvoyés par les serveurs. Les chercheurs peuvent voir ce qu'ils voulaient faire, mais il est difficile de confirmer si chaque tentative a réussi.
97 % des charges utiles manquent également d'horodatages originaux, et de nombreuses dates ne peuvent être estimées qu'à travers des indices tels que les en-têtes de fichiers compressés, les JWT et les heures de construction Docker.
Les chercheurs ont également admis qu'ils ne peuvent pas confirmer que chaque activité dans l'ensemble de données provenait d'agents OpenAI.
OpenAI tente désespérément de réparer la bergerie après la fuite des brebis
Face à ce dernier rapport, OpenAI a également publié une réponse.
En substance, nous n'avons pas encore eu le temps d'examiner attentivement, mais l'activité qui s'y trouve est cohérente avec l'enquête que nous menons~
Le même jour, ils ont également publié un long tweet : Après l'incident HF, ils ont promis de mener un examen plus large du comportement des modèles pendant l'entraînement et l'évaluation.

Mais bon, la grande majorité des comportements examinés jusqu'à présent sont des tâches de recherche ordinaires, comme visiter des pages web publiques pour répondre à des questions.
La plupart des cas de dépassement de limites découverts sont de « faible gravité », avec peu ou pas d'impact sur les services tiers.
Pour finir de tout vérifier, il faudra encore plusieurs mois.
Mais pour être juste, OpenAI, votre soi-disant « faible impact » est vraiment quelque chose que les gens peuvent déterrer les uns après les autres.
Le 17 septembre, OpenAI a publié un nouveau cadre pour divulguer les incidents de désalignement des modèles, et a divulgué publiquement 6 cas en une seule fois.
Cela inclut des modèles qui écrivent secrètement des instructions pour contourner les contraintes dans les résumés de tâches, dissimulent leurs propres erreurs et prennent des mesures non autorisées pour accomplir des tâches.
OpenAI a également admis que les divulgations passées étaient en grande partie improvisées, accumulant souvent plusieurs cas avant de les publier ensemble.
En juin, un agent d'OpenAI a également piraté la base de données nationale d'assurance maladie de l'Australie.

Le mode opératoire : après avoir été bloqué pour accéder aux données publiques, il a emprunté une autre voie, contourné les restrictions d'accès du portail et obtenu à la fois des fichiers publics et non publics.
Et ce n'est que 3 mois plus tard qu'OpenAI a informé la partie australienne, nous vous avons piraté...
En même temps, GPT-6 Cyber est sur le point d'arriver.
Cette version sera prévisualisée dans les semaines à venir, et un petit nombre de clients entrant dans le programme Daybreak Red ont déjà reçu la version Alpha.
OpenAI lancera également un produit compagnon encore sans nom pour aider les clients à construire des flux de travail de sécurité automatisés, découvrir et corriger les vulnérabilités, tout en facilitant la surveillance par OpenAI de l'utilisation de ces modèles.
Comment dire.
Son propre agent vient d'être exposé pour avoir franchi le mur, cherché de l'aide extérieure et pillé le butin, et maintenant il s'apprête à vendre à tout le monde un modèle qui comprend encore mieux la cyberoffensive et la cyberdéfense.
Alors, est-ce une sorte de fermer la porte de l'écurie après que le cheval se soit échappé ??
Liens de référence :
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
Cet article provient du compte public WeChat « QbitAI », auteur : Focus on Frontier Technology