
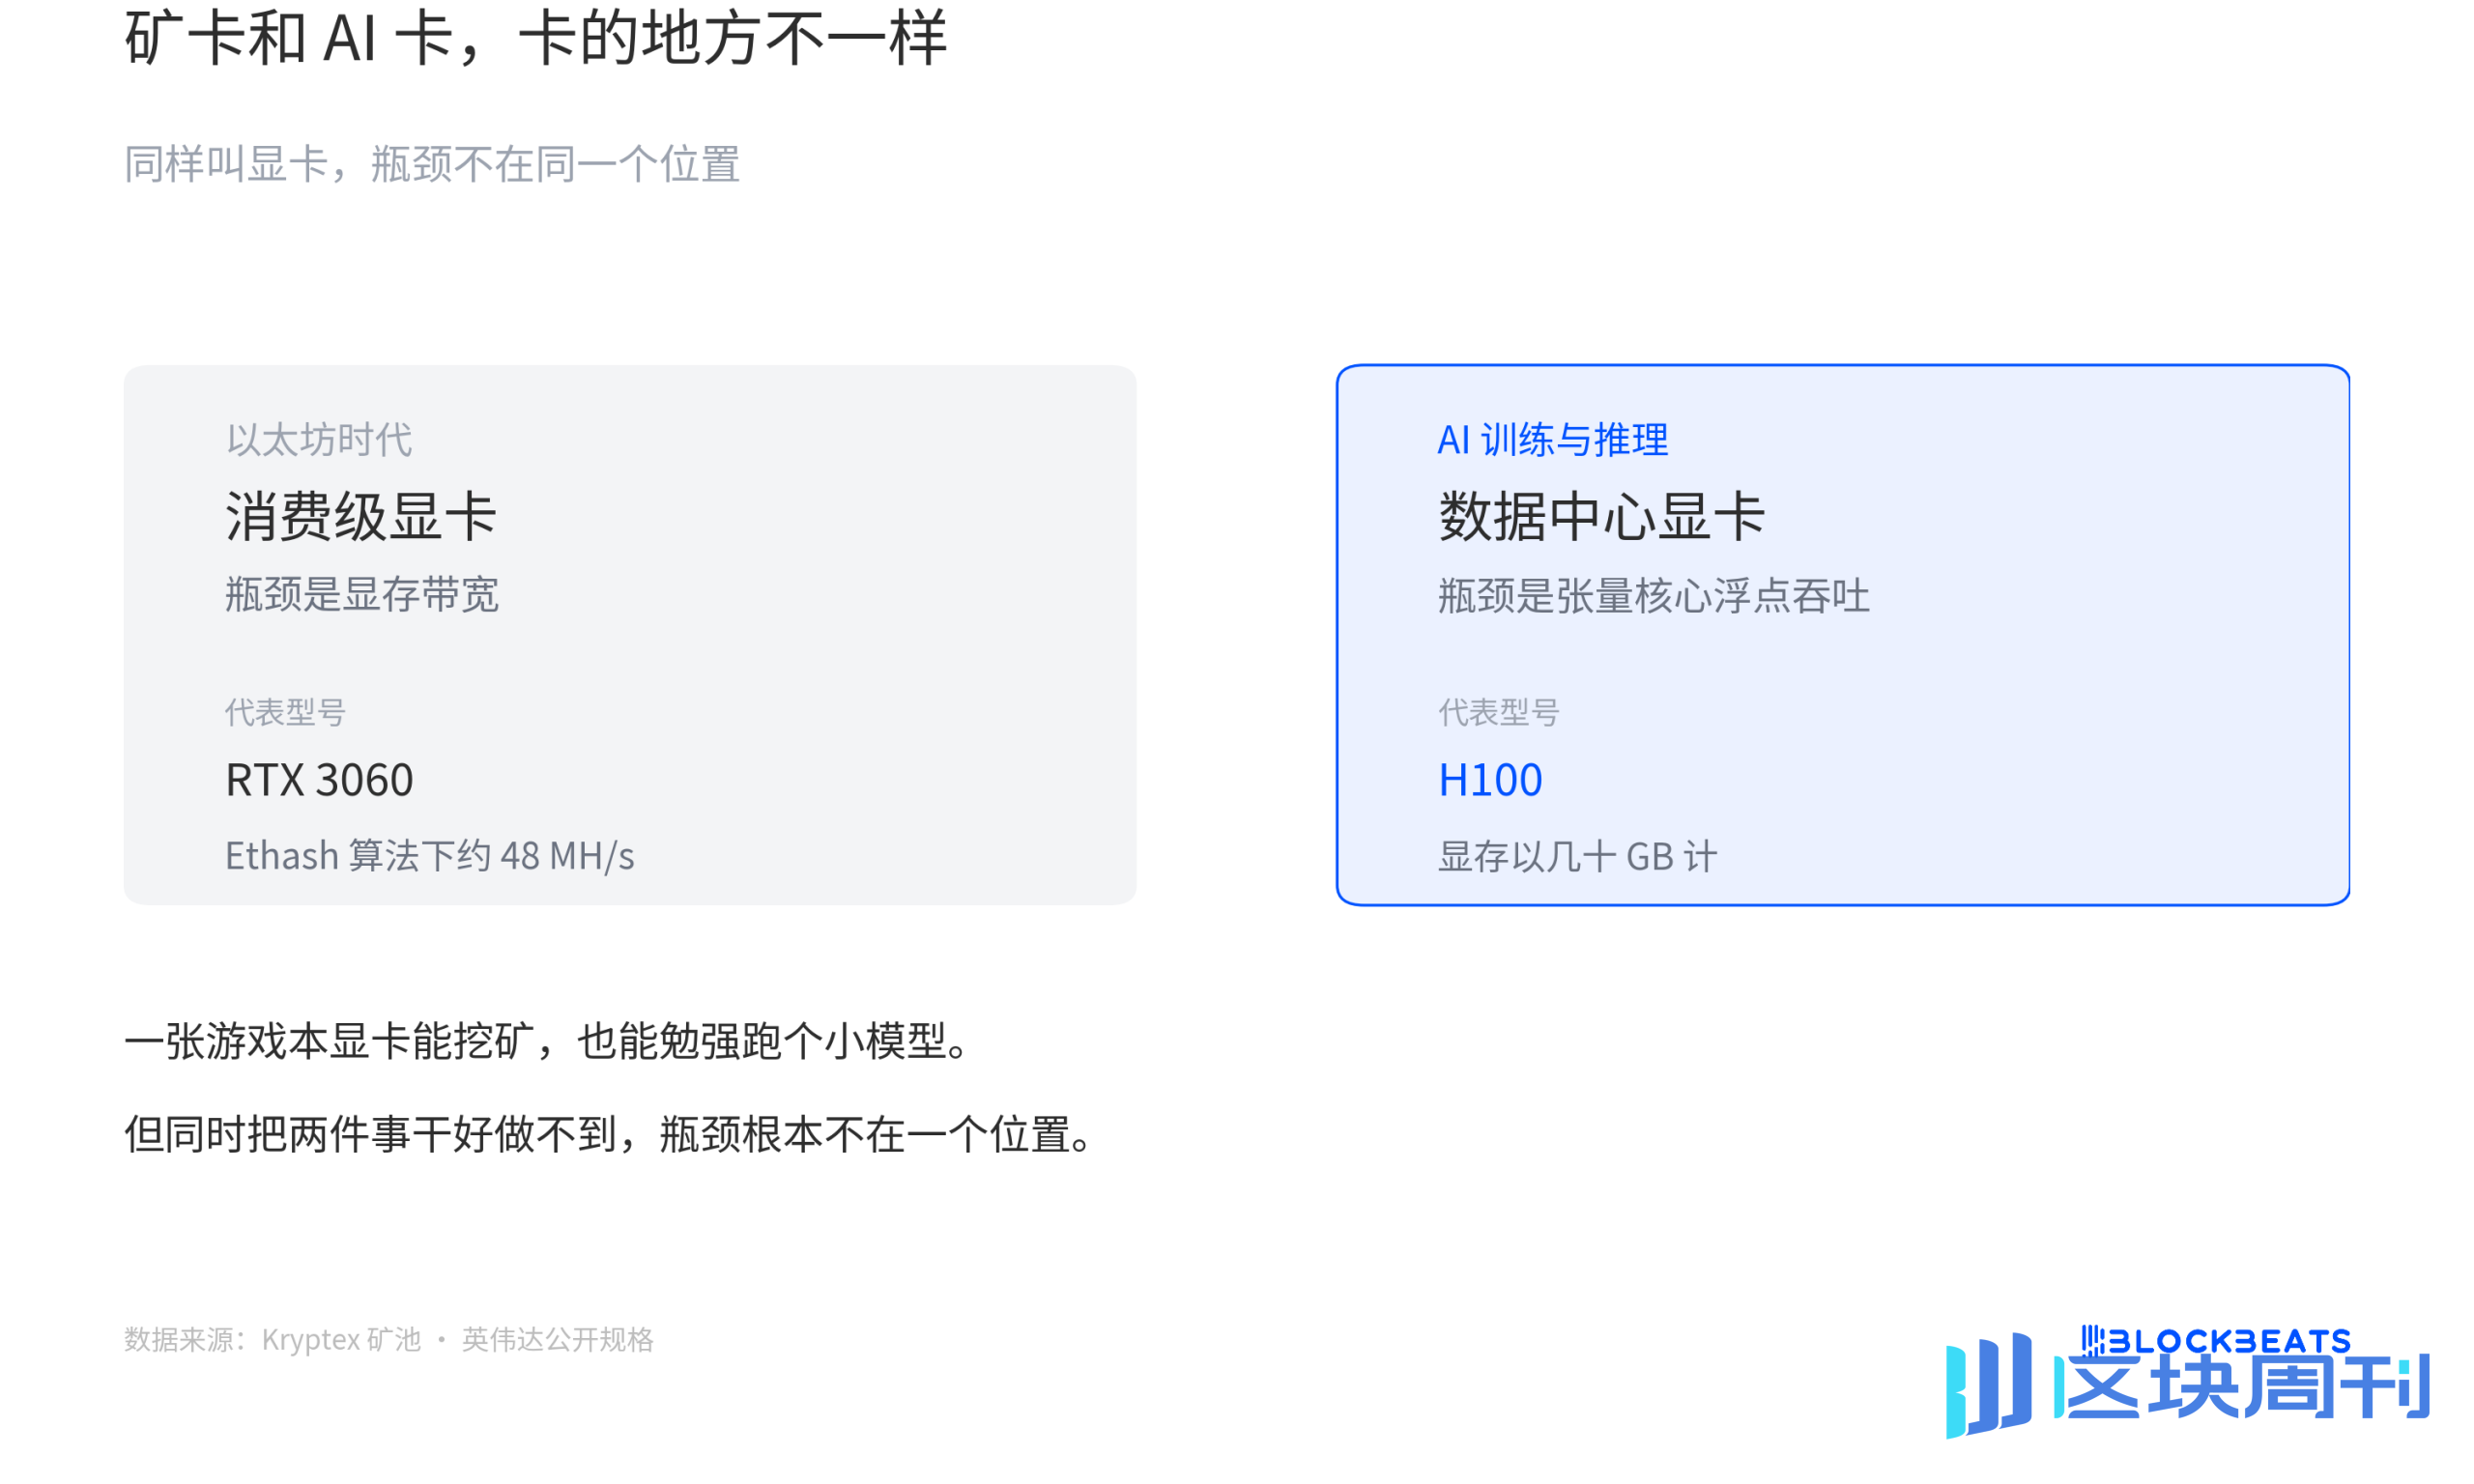
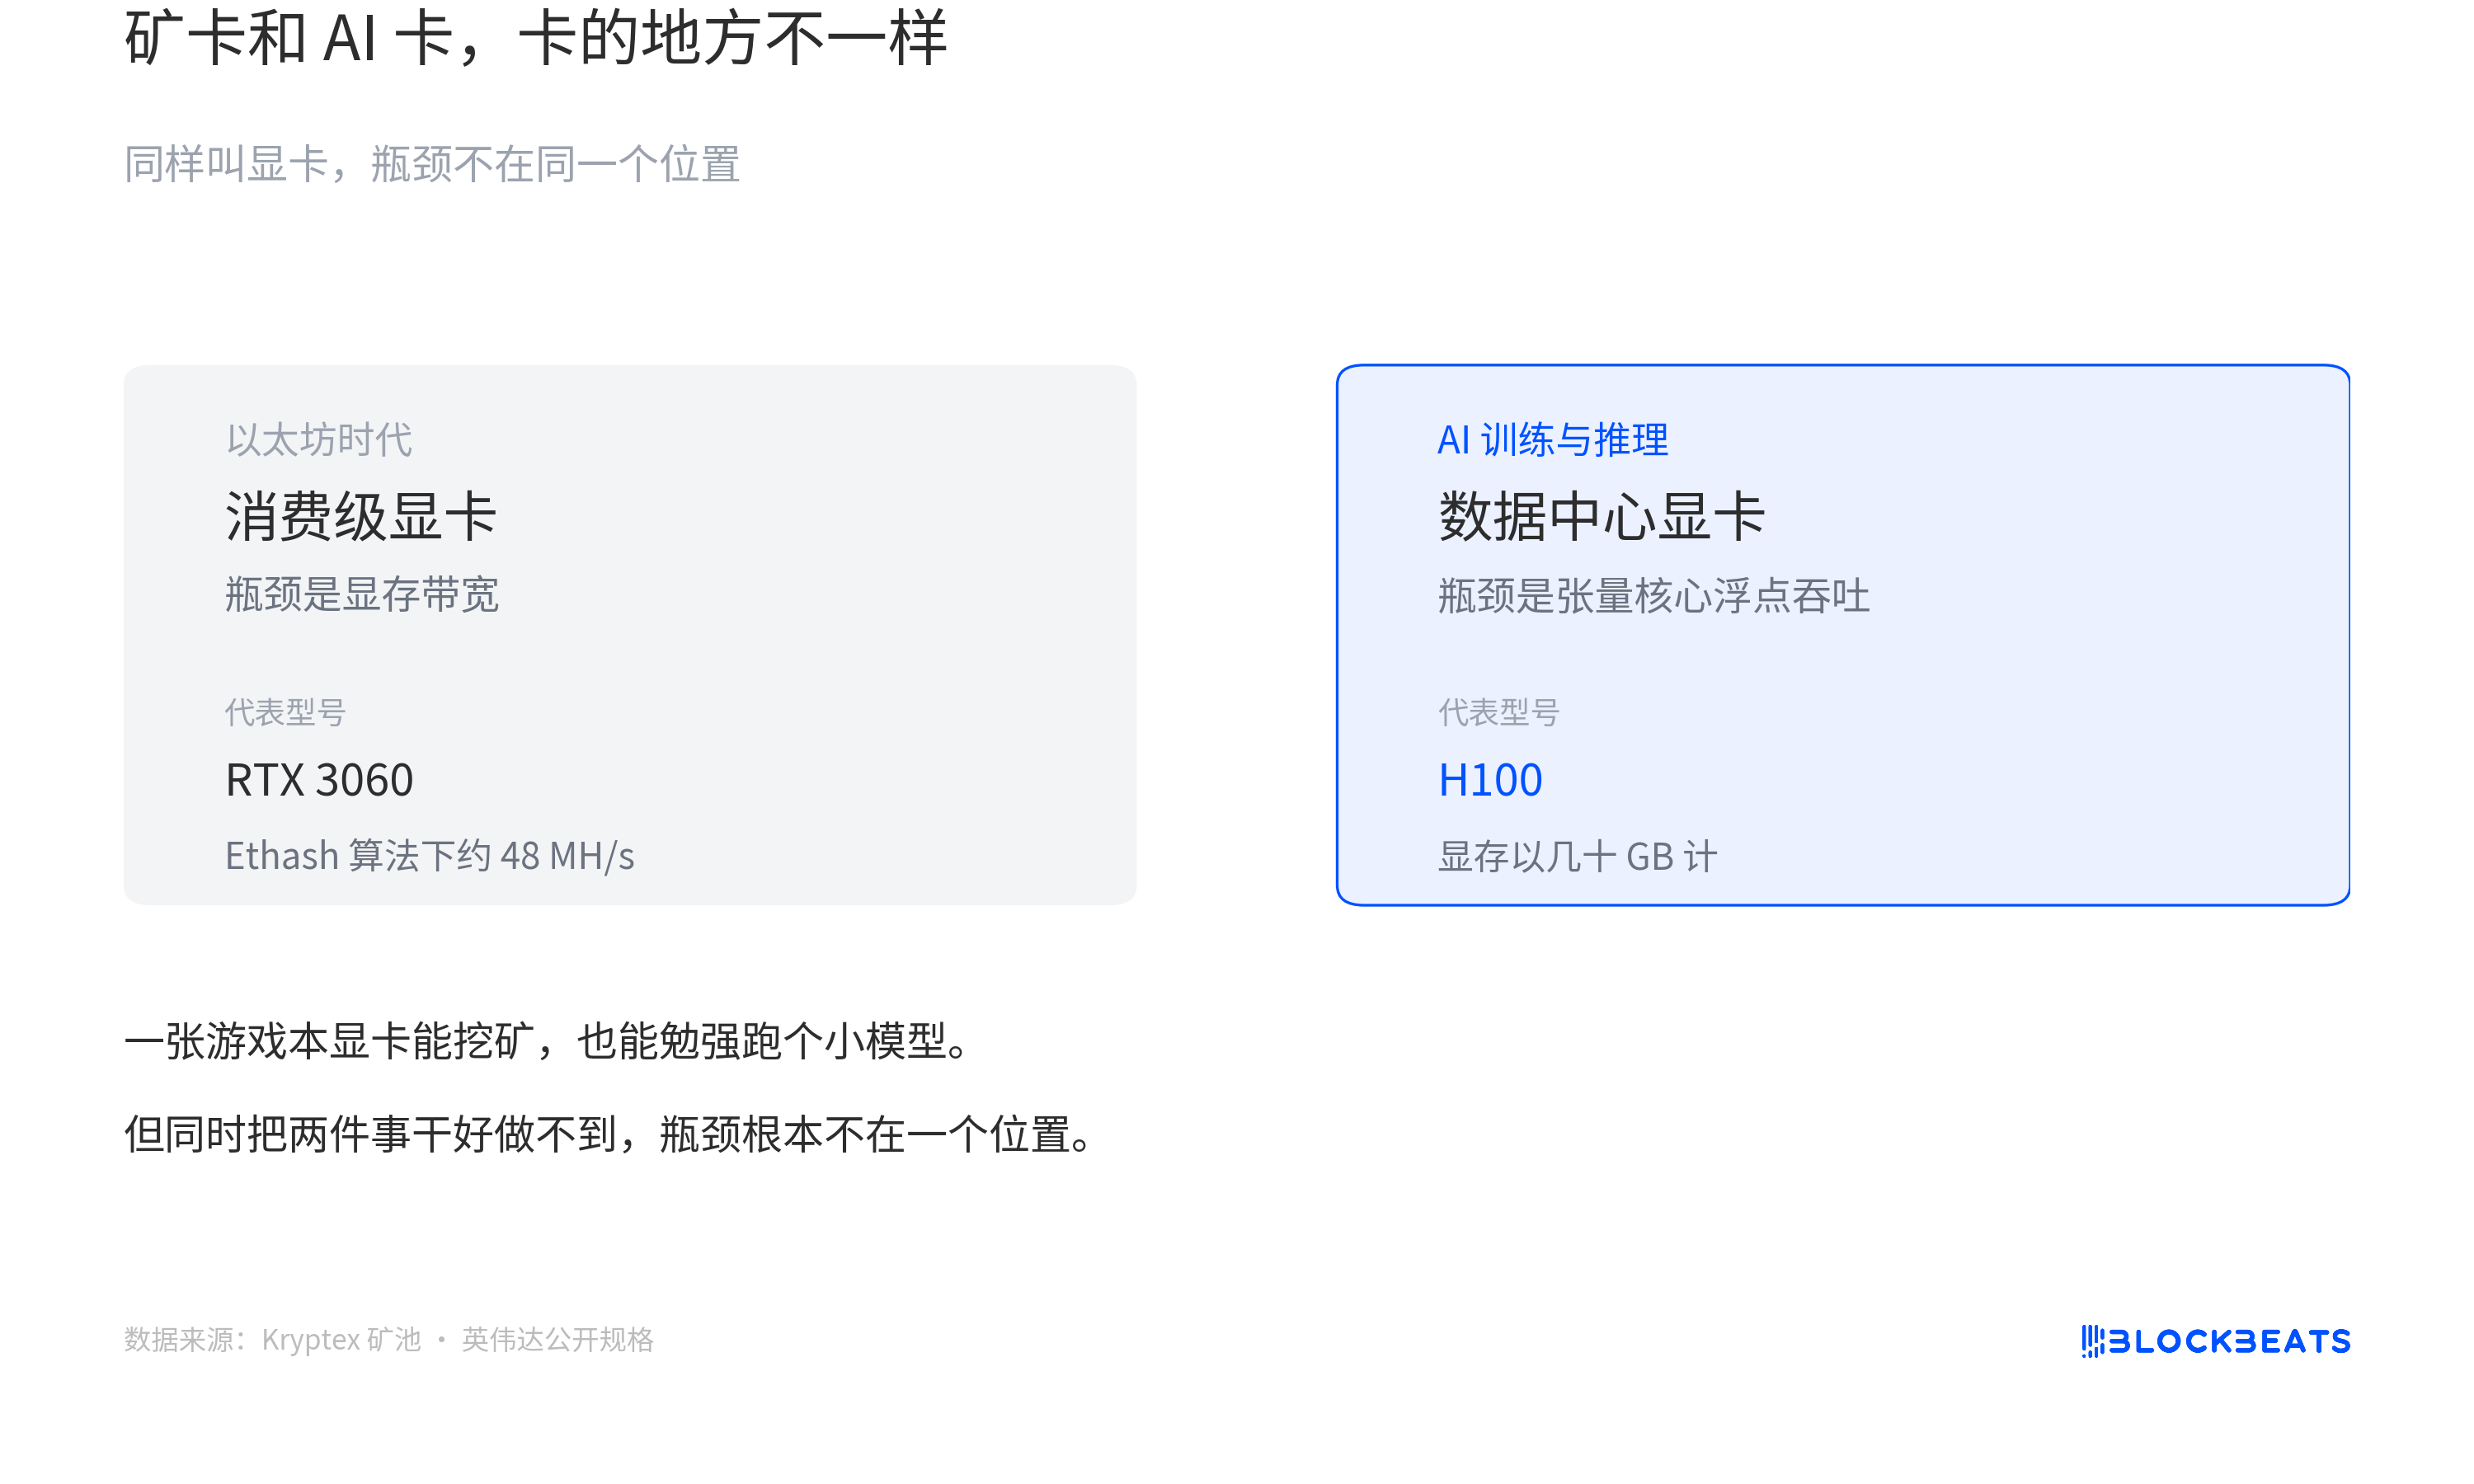
W latach, gdy Ethereum było jeszcze oparte na mechanizmie POW, górnicy używali kart graficznych klasy konsumenckiej, a algorytm nazywał się Ethash. RTX 3060 osiąga około 48 MH/s na Ethash. W tamtym czasie niektórzy myśleli, że skoro zarówno kopanie, jak i AI opierają się na kartach graficznych, to czy ta sama karta może jednocześnie kopać i uruchamiać modele.
Ten pomysł nie wypalił, ponieważ obie czynności mają wąskie gardła w różnych miejscach. Ethash jest ograniczony przepustowością pamięci i oblicza hashe o stałej trudności. AI potrzebuje przepustowości obliczeń zmiennoprzecinkowych tensor cores i kilkudziesięciu GB VRAM, a głównymi końmi roboczymi są karty dla centrów danych, takie jak H100. Karta graficzna w laptopie do gier może kopać i ledwo uruchomić mały model, ale nie może dobrze robić obu rzeczy jednocześnie.
W 2019 roku Vitalik Buterin wydał osąd w tej sprawie. Jego oryginalne słowa były takie, że gdyby można było znaleźć jakiś użyteczny i łatwy do zweryfikowania rodzaj obliczeń, kopanie kryptowalut stałoby się ogromnym bogactwem dla społeczeństwa, ale to jest prawdopodobnie niemożliwe.
Pearl twierdzi, że tego dokonał. Osąd Vitalika sprzed kilku lat jest wyeksponowany na oficjalnej stronie Pearl.
Pearl to niezależny publiczny łańcuch proof-of-work, a jego token nazywa się PRL. Górnicy nie obliczają już wielokrotnie hashy; zamiast tego wykonują mnożenie macierzy, czyli ten rodzaj mnożenia i dodawania, który wykonuje każda warstwa sieci neuronowej. Z założenia te same obliczenia GPU zarówno produkują bloki i emitują monety, jak i generują weryfikowalne obliczenia AI.
Oficjalny opis tego brzmi: „energia, dane i pieniądze w jednej operacji”. Bitcoin wiąże energię i pieniądze razem, AI wiąże energię i dane razem, a monetyzacja wiąże dane i pieniądze razem. Te trzy rzeczy kiedyś spotykały się po dwie naraz; Pearl chce, aby wszystkie trzy działy się jednocześnie w jednym mnożeniu macierzy.
Linia PoW była cicha przez długi czas. Ostatnia partia nowych publicznych łańcuchów, które mogłyby skłonić ludzi do poważnej dyskusji, zasadniczo zakończyła się lata temu. Potem emocje przeniosły się na L2, modularność i restaking. Nowy łańcuch PoW sam w sobie jest rzadkością. Teraz PRL, z kapitalizacją rynkową w obiegu wynoszącą 430 milionów USD, chce opowiedzieć jaką historię?
Jaki problem chce rozwiązać
Proof of work Bitcoina ma pewną cechę: to, co obliczają górnicy, nie ma nic wspólnego z rzeczywistym światem. Ta sama kilowatogodzina, gdyby została użyta do uruchamiania modeli, może produkować tokeny, generować obrazy i wykonywać pracę. Wielu ludzi uważa, że wykorzystywanie jej do kopania jest trochę marnotrawstwem.
Prawdziwa trudność nie polega na „użyteczności”, ale na braku pozwoleń. Brak pozwoleń oznacza, że każdy może przyjść kopać, bez rejestracji, i nikt nie sprawdza kwalifikacji. Model bezpieczeństwa Bitcoina jest zbudowany na tym: niezależnie od tego, co obliczasz, koszt jest taki sam. Gdy praca zostanie zastąpiona czymś o rzeczywistej wartości, górnicy mają zachętę do oszukiwania lub wyboru taniego wkładu. Więc pytanie nie brzmi, czy kopanie można uczynić użytecznym, ale czy można je uczynić użytecznym, gdy nikt nie może oszukiwać.
Własne twierdzenie Pearl jest takie, że zastępuje losowe hashowanie Bitcoina mnożeniem macierzy, pozwalając GPU traktować proof of work jako produkt uboczny obciążeń AI. Biała księga bezpośrednio używa terminu „2 za 1”. Mówiąc prosto, wcześniej partia GPU miała tylko dwa przeznaczenia: albo kopać, paląc prąd i emitując monety, albo uruchamiać modele, paląc prąd i produkując tokeny. Pearl chce połączyć te dwa przeznaczenia w jedno.
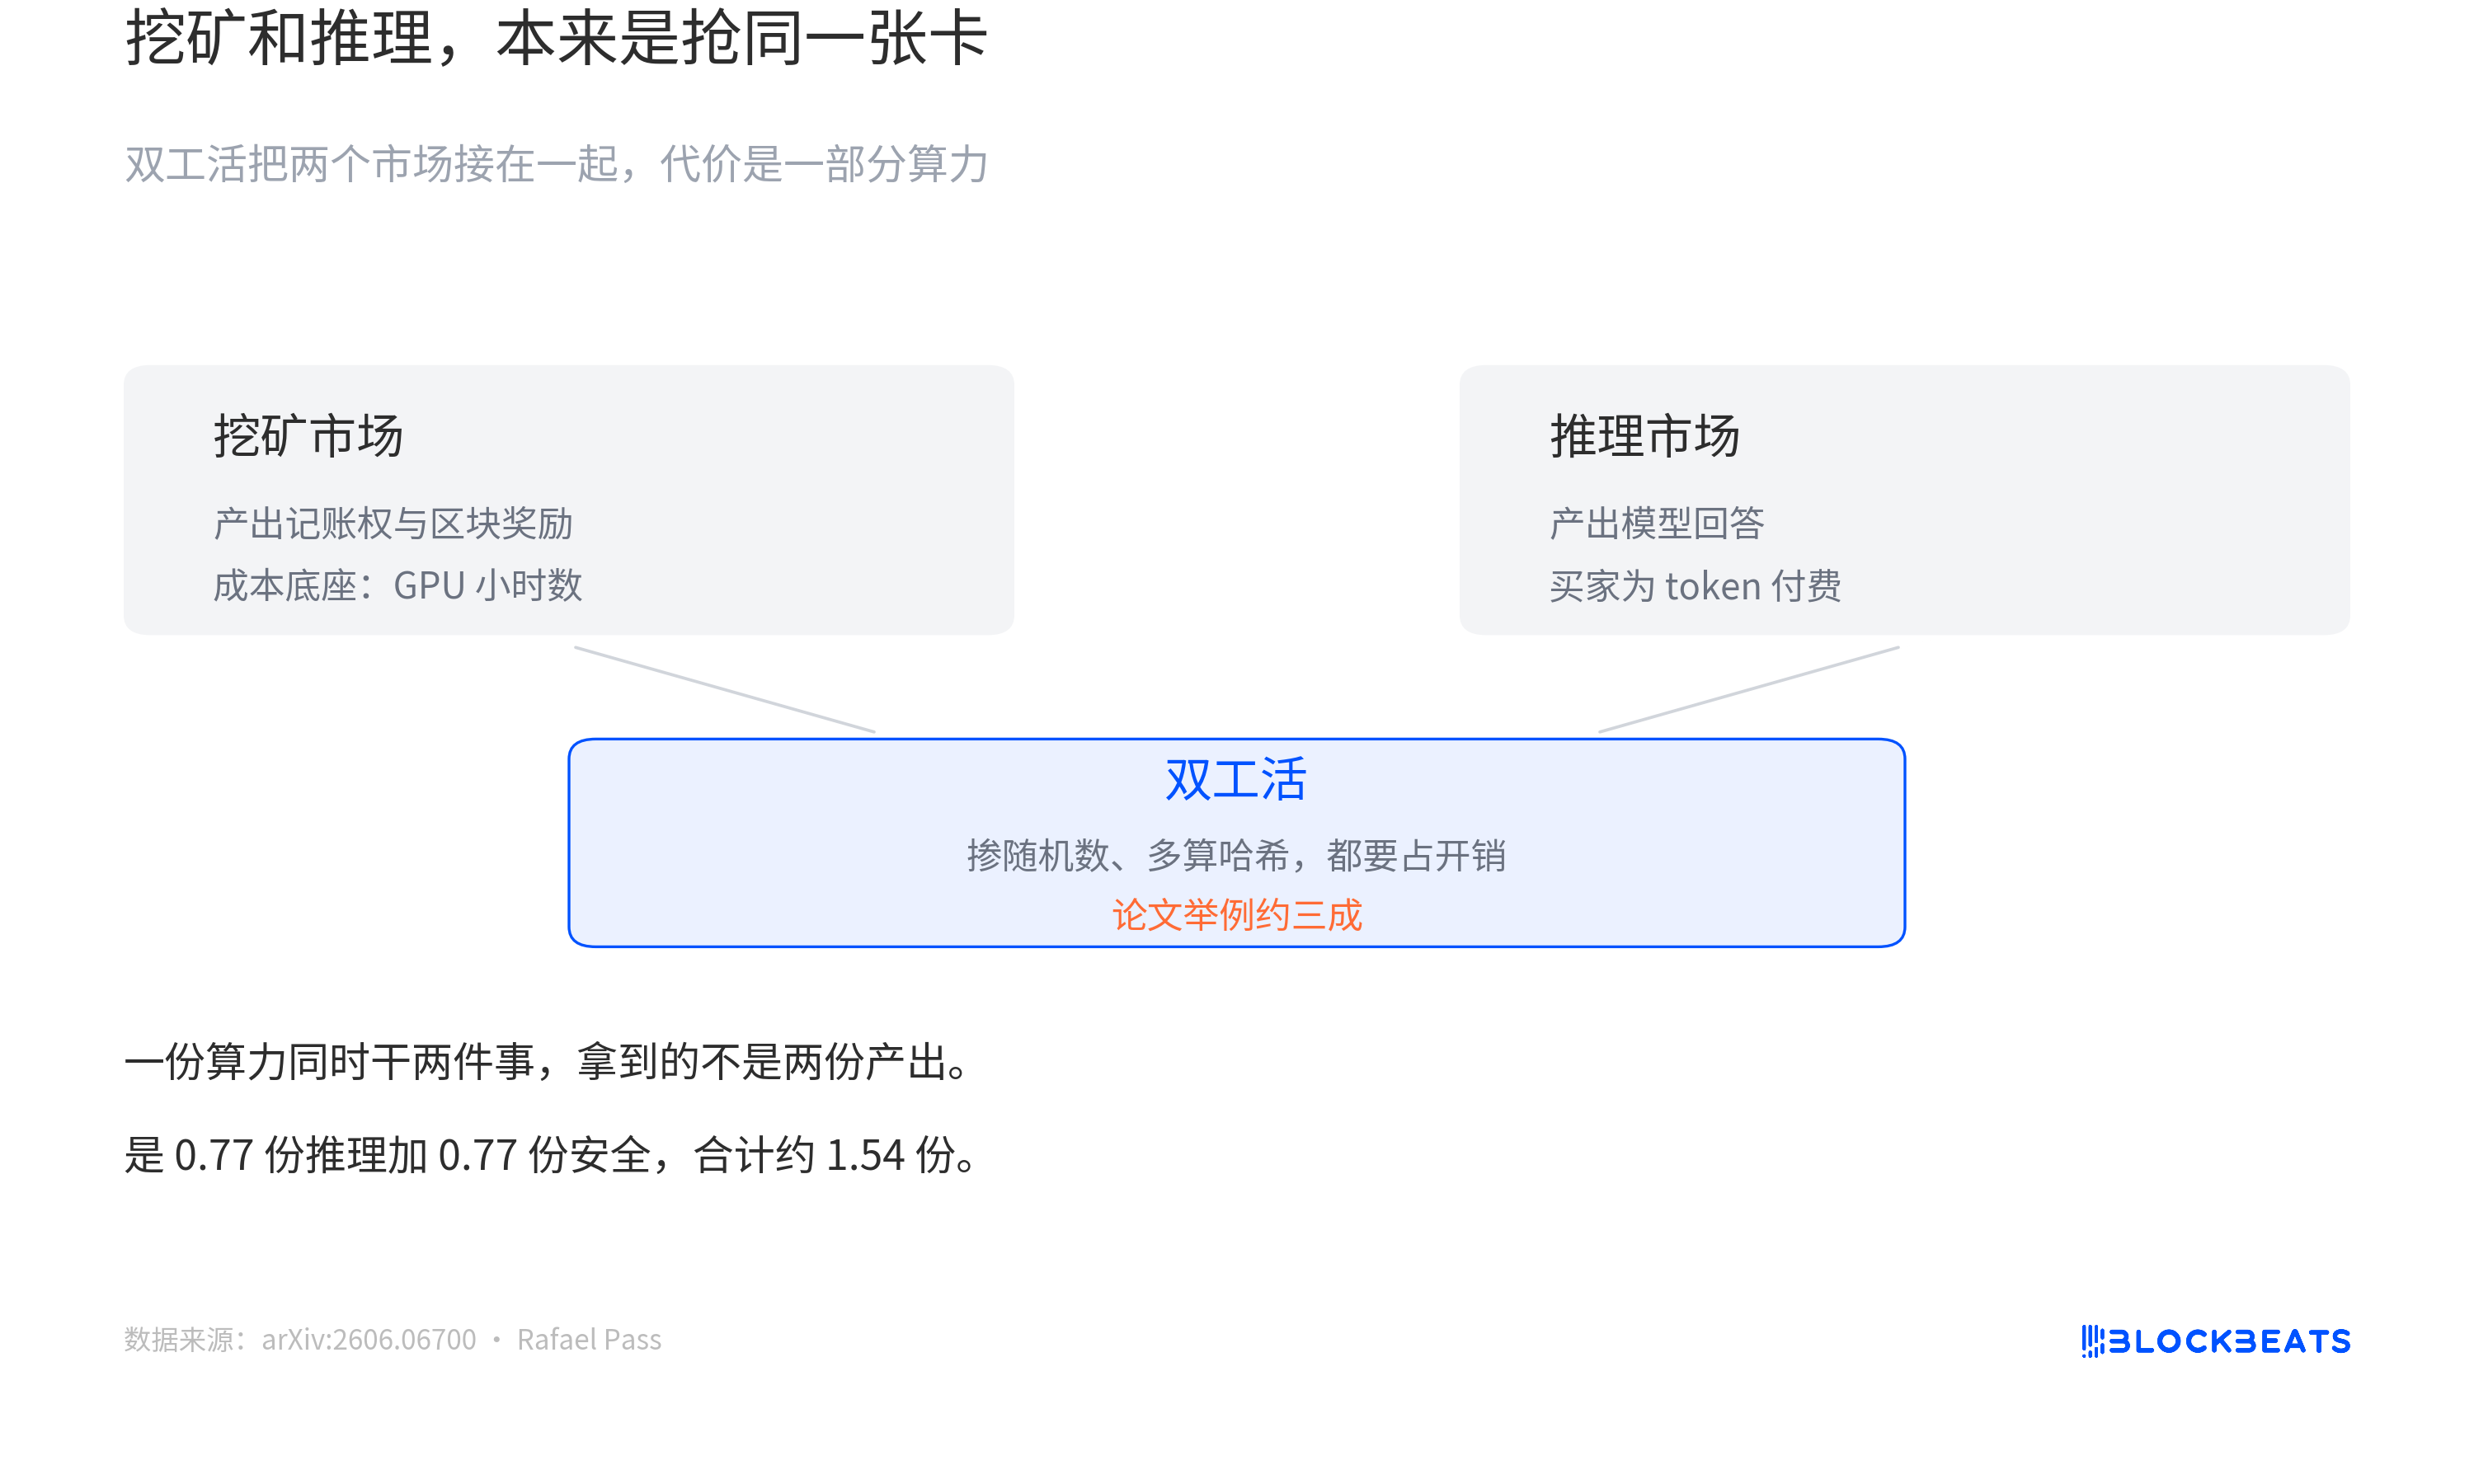
Ktoś szczegółowo obliczył ten pomysł. Praca badacza kryptografii Rafaela Passa „The Economics of Proof-of-Useful-Work” dzieli pracę maszyny na trzy typy: czyste kopanie, czysta inferencja i podwójna praca, która produkuje obie jednocześnie. Podwójna praca nie jest darmowa. Praca podaje przykład: jednostka mocy obliczeniowej wykonująca dwie rzeczy naraz nie otrzymuje dwóch wyników, ale około półtora. Jeśli narzut jest wystarczająco mały, a skala, w jakiej token jest akceptowany przez rynek, wystarczająco duża, nagroda za blok jest równoważna udzieleniu rabatu na cenę inferencji, przyciągając moc obliczeniową do inferencji, która w przeciwnym razie nie zostałaby wykonana. To rozumowanie jest matematycznie nienaganne, ale kłopot polega na tym, że jego trzy zmienne — narzut, cena tokena i popyt na inferencję — nie są czymś, co Pearl może ustalić samodzielnie. Przypis w pracy ujawnia, że autor ukończył tę pracę, konsultując się dla Pearl Research Labs.
Logika działania Pearl
Aby wyjaśnić, jak działa ten system, najpierw musimy rozłożyć termin mnożenie macierzy. Nie został on wynaleziony przez Pearl; to bardzo stara operacja i niemal każda warstwa w sieci neuronowej ją wykorzystuje.
Macierz to tabela liczb ułożonych w wiersze i kolumny. Dwie tabele można pomnożyć, jeśli liczba kolumn w pierwszej równa się liczbie wierszy w drugiej. Każda komórka w tabeli wynikowej to suma iloczynów jednego wiersza z pierwszej tabeli i jednej kolumny z drugiej tabeli, pomnożonych jeden do jednego, a następnie wszystkich dodanych. Weźmy najmniejszy przykład: pierwszy wiersz A to 1 i 2, pierwsza kolumna B to 5 i 7, wtedy lewy górny róg tabeli wynikowej to 1 razy 5 plus 2 razy 7, co równa się 19. Pozostałe komórki są wypełniane jedna po drugiej zgodnie z tą zasadą.
W modelu AI obliczenia jednej warstwy można zapisać jako „wejście razy wagi”. Zdanie użytkownika jest cięte na wektory, mnożone przez tabelę wag tej warstwy, aby uzyskać wynik, następnie przechodzi przez funkcję nieliniową i jest przekazywane do następnej warstwy. Im większy model, tym większe tabele, a liczba mnożeń i dodawań w jednym przebiegu może wynosić biliony. GPU są zbudowane do tego rodzaju schludnego mnożenia i dodawania, co jest również powodem, dla którego karty do kopania i karty AI to ten sam typ chipa.
Idealnie rzeczy działają tak. Ktoś zadaje chatbotowi pytanie online, a karta graficzna na serwerze zaczyna uruchamiać model, wykonując mnożenie macierzy warstwa po warstwie. Jeśli ta maszyna ma zainstalowaną wtyczkę Pearl i uruchamia jej certyfikowany model open source, to te mnożenia, produkując odpowiedź, są również wykorzystywane do spróbowania szczęścia. Po obliczeniu każdego małego bloku odcisk jest raz przecierany. Jeśli odcisk jest wystarczająco mały, wygrywa się los na loterii, a wygrana daje nagrodę za blok. Użytkownik nie widzi różnicy, nadal otrzymuje odpowiedź, a cena może być nawet nieco tańsza. Ta sama partia mnożeń i dodawań zamienia się z jednej strony w tokeny, a z drugiej w monety.

Aby ten system działał, musi najpierw rozwiązać problem oszukiwania. Górnik ma właśnie dwie tabele w ręku i musi najpierw przetrzeć tabele w odcisk i go przesłać. Tak zwane przecieranie odcisku oznacza wzięcie wszystkich liczb w tej tabeli i obliczenie razem hasha, kompresując go do bardzo krótkiego segmentu. Dopiero gdy łańcuch zobaczy ten odcisk, powie mu, jakie losowe liczby wymieszać do tabel. Kolejność jest zablokowana i jest za późno, aby zmienić tabele. Oficjalny termin na tę czynność to dodawanie szumu. Mówiąc prosto, oznacza to mieszanie kilku losowych liczb do obu tabel. Ile jest mieszane i gdzie, jest określane przez ten odcisk, a górnik nie może sam wybierać.
Bez mieszania istnieje skrót. Między czystym A razy B a iloczynem po wymieszaniu losowych liczb jest tylko różnica trzech wyrazów korekcyjnych. Te trzy wyrazy nie są małe pod względem wielkości, ale są tanie w obliczeniu. Górnik ma już czyste A i B w ręku, więc mógłby całkowicie najpierw obliczyć czystą odpowiedź, a następnie dodać te tanie wyrazy korekcyjne, aby uzyskać odpowiedź z wymieszanymi losowymi liczbami, bez wykonywania tego dużego mnożenia. To jak pytanie egzaminacyjne o 3987 razy 2913, ale uczeń już zapamiętał odpowiedź i składa kilka małych liczb, aby wyglądało, że poważnie obliczał.
Więc protokół nie wymaga, aby górnik przekazał obliczony wynik, tylko wiersze wejścia, których użył, plus dowód. Weryfikator bierze tę część, miesza te same losowe liczby, ponownie oblicza tylko ten mały blok i sprawdza, czy odcisk jest poprawny. Ponowne obliczenie małego bloku jest tanie i wystarczające, aby potwierdzić, że nie oszukiwał. Jeśli te tabele dotyczą wag firmowych lub danych użytkownika, można dodać dodatkową warstwę dowodu zerowej wiedzy, aby udowodnić, że obliczenia rzeczywiście zostały wykonane, bez ujawniania, które dwie tabele zostały użyte.

Do jakiego etapu już dotarł
Wejdź na Hugging Face i spójrz; w organizacji pearl-ai znajdują się cztery certyfikowane modele: Llama 3.3 70B, Llama 3.1 8B, Qwen3 30B i Gemma 4 31B. Oficjalnie nazywa się je „certyfikowanymi wariantami”; podejście nie polega na ponownym trenowaniu, lecz na ponownej kompresji tego samego zestawu wag w formacie kwantyzacji Pearl, aby mogły wykonywać wnioskowanie podczas kopania wewnątrz wtyczki. Utrata precyzji jest bardzo mała; MMLU modelu Gemma 4 31B spadło z 90,93 do 90,56. Na dzień 9 października 2026 r. liczba pobrań tych czterech modeli w ciągu ostatnich trzydziestu dni wahała się od 195 do 6424, a ich polubienia wynosiły odpowiednio 0, 3, 5 i 6.
Istnieje również komercyjne wyjście. W maju 2026 r. Pearl nawiązał współpracę z Together AI, aby uruchomić interfejs obsługujący model Gemma. Zgodnie z ogłoszeniem Together, cena wywołania jest o 25% tańsza niż zwykłych interfejsów, a różnica jest kompensowana przyszłą wartością tokenów.
Modele są opublikowane, kod jest otwartoźródłowy, a potem nie ma już nic więcej. W czerwcu 2026 r. badacz Abhinaba Basu w „The Usefulness Gap in Proof-of-Useful-Work” przetestował to. Zgodnie z mocą obliczeniową sieci w tamtym czasie wynoszącą około 24 EH/s, co odpowiada około 320 000 kartom klasy RTX 3090, szacowanym zużyciem energii 112 megawatów, użyteczna moc obliczeniowa AI wynosiła zero.
Autor pobrał próbkę 8012 jednostek pracy górników; cały sprzęt miał zdolność wnioskowania, ale w głównym oprogramowaniu koparki znajdowały się 4803 ciągi związane z mnożeniem macierzy i 0 związanych z frameworkami uczenia maszynowego. Napisał także własny program do kopania, wypełniając tabele liczbami losowymi, i uruchomił go pomyślnie na układach Nvidia, AMD, CPU i Apple, uzyskując udziały uznane przez pulę wydobywczą, w sumie 44. Jedna osoba dostarczająca dane i pozwalająca modelowi obliczyć wynik, oraz używanie tej samej karty do kopania monet, mogą być połączone w projekcie, ale w rzeczywistym działaniu są one rozdzielone.
Więc co faktycznie działa w sieci. Zgodnie ze stroną puli wydobywczej Kryptex, moc obliczeniowa sieci wzrosła do 46,37 EH/s, trudność 2,26 TH, czas bloku około 203 sekund, nagroda za blok 2271,03 PRL, dzienna produkcja około 966 000 monet, a cena monety około 1,30 dolara. W ciągu sześciu miesięcy moc obliczeniowa prawie się podwoiła, a zdecydowana większość tego wzrostu to nadal wypełnianie liczbami losowymi. To, co jest teraz robione na rynku, to głównie tylko ta jedna rzecz: kup karty, podłącz je, wypełnij liczbami losowymi, czekaj na rozliczenie.
Jakie są problemy
Wyobraźmy sobie, że stołówka wywiesza ogłoszenie: kto posieka wystarczająco sto jin warzyw, może otrzymać wynagrodzenie. Sam akt siekania warzyw jest prawdziwy; umiejętności nożowe, siła i czas muszą zostać poświęcone. Ale ogłoszenie sprawdza tylko, czy posiekałeś wystarczająco sto jin, a nie jakie warzywa posiekałeś. Więc ktoś przynosi wózek zgniłych liści warzyw, sieka wystarczająco sto jin i bierze wynagrodzenie. On naprawdę siekał warzywa i naprawdę zużył siłę, tylko że kuchnia nie może użyć tej sterty liści.
Pearl utknął teraz tutaj. Protokół sprawdza, czy odcisk palca tabeli się zgadza, czy wynik naprawdę równa się mnożeniu dwóch tabel, czy obciążenie pracą jest wystarczające dla trudności; w formalnym projekcie istnieje również brama statystyczna specjalnie do blokowania danych wejściowych, które na pierwszy rzut oka widać, że zostały zmanipulowane. Sprawdza to wszystko. To, czego nie sprawdza, to skąd pochodzą te dwie tabele. Więc górnicy mogą całkowicie sami stworzyć dwie tabele liczb losowych; mnożenie jest równie trudne, odcisk palca spełnia standard tak samo, i mogą wygrać tak samo, z tą różnicą, że nikt nie chce użyć obliczonego wyniku. Protokół rozpoznaje tylko relację mnożenia, a nie semantykę; „użyteczne” tutaj to kwestia komercyjna, a nie gwarancja kryptograficzna.
To nie jest przypuszczenie. Zgodnie z wcześniej wspomnianym raportem, wszystkie próbkowane maszyny mogły uruchamiać modele, a jednak w oprogramowaniu koparki nie było ani jednej linii kodu wnioskowania, a tabele, które autor sam wypełnił liczbami losowymi, również uzyskały udziały uznane przez pulę wydobywczą. Obecnie moc obliczeniowa sieci wynosi około 45 EH/s, a zdecydowana większość to nadal wypełnianie liczbami losowymi.
Lukę w skali można również zobaczyć w ten sposób. Artykuł podał kontrfaktyczny scenariusz: gdyby ten projekt naprawdę działał zgodnie z reklamą, to w tamtym czasie sieć o mocy 24 EH/s powinna wyprodukować około 7,7 miliona godzin GPU użytecznej mocy obliczeniowej AI dziennie. Artykuł wspomniał również o wskaźniku zwanym współczynnikiem niszczenia wartości; zmierzona wartość Pearl wynosi 1,0, na równi z Bitcoinem, podczas gdy Filecoin wynosi około 0,64.
Górnicy nie przyjmują zleceń wnioskowania, nie dlatego, że nie rozumieją, ale dlatego, że policzyli sobie. Artykuł szacuje, że połączenie silnika wnioskowania z kopaniem spowodowałoby utratę około 10% do 30% efektywnej mocy obliczeniowej. Oznacza to, że przyjęcie prawdziwego wnioskowania wymaga nie tylko zmiany oprogramowania i dostosowania się do rytmu żądań, ale także najpierw utraty tej części mocy obliczeniowej. W latach, gdy cena monety nie jest wysoka, ten rachunek łatwo wychodzi na minus.
Jak więc można by to rozwiązać. Artykuł wymienił kilka ścieżek. Jedna to zarządzanie źródłem tabel, wymagające od górników korzystania z tabel przesłanych przez zewnętrznych klientów. Wtyczka i certyfikowane modele, które oficjalnie robi Pearl, zmierzają w tym kierunku: przekaż model i wtyczkę górnikom; używasz prawdziwego modelu do uruchomienia wnioskowania, a to mnożenie wygodnie kopie również monetę. Trudność polega na tym, że jest to dobrowolne; czy to przyjąć, wciąż zależy od górników, którzy sami obliczają swój własny rachunek ekonomiczny.
Inna to sprawdzenie, czy tabele wyglądają jak prawdziwe. Wagi prawdziwych modeli i przypadkowo wypełnionych liczb losowych różnią się pod względem cech statystycznych. Ale sam artykuł odrzucił tę ścieżkę: górnicy muszą tylko dostosować rozkład, aby oszukać sprawdzenie, przy niemal zerowym koszcie. Istnieje również kilka bardziej odległych ścieżek, które jeszcze nie zostały wdrożone. Uczynienie źródła modelu weryfikowalnym podpisem wymaga najpierw posiadania systemu klucza publicznego po stronie modelu. Użycie zaufanego sprzętu do udowodnienia pochodzenia danych wymaga dodatkowo zaufania producentom chipów i również spowolni to działanie. Zróżnicowanie nagród, dawanie nieco więcej za korzystanie z prawdziwych danych, wymaga najpierw posiadania grupy klientów naprawdę gotowych zapłacić.
Deweloperem Pearl jest Pearl Research Labs. Omri Weinstein jest współzałożycielem i CEO; ten tytuł pochodzi z ogłoszenia o partnerstwie Together AI. Jest badaczem w dziedzinie teorii złożoności, zajmuje stanowisko wykładowcy na Uniwersytecie Hebrajskim i jest jednym z autorów tego fundamentalnego artykułu.
Inny autor, Ilan Komargodski, również znajduje się na liście członków organizacji Hugging Face; czy jego konkretna tożsamość to pracownik czy konsultant, nie można udowodnić na podstawie publicznych źródeł. Inne nazwisko, które można dopasować, to Erez Badash, pierwszy autor artykułu Hawkeye o bitowym odtwarzaniu GPU.
Bittensor ma walidatorów oceniających wyniki modeli przesłane przez górników, przy czym ocena jest określana przez konsensus zwany Yuma. io wynajmuje GPU na żądanie do zadań uczenia maszynowego. Pearl stawia na węższe założenie: samo mnożenie używane do generowania bloków może być przez kogoś pożądane.
Obstawia, że popyt na wnioskowanie wzrośnie na tyle, by pochłonąć moc obliczeniową generowania bloków. W tym momencie sami górnicy jasno obliczą, że przyjmowanie prawdziwych zleceń jest bardziej opłacalne niż wypełnianie losowymi liczbami. Jeśli nie uda się osiągnąć tego punktu, to jest to po prostu łańcuch kopania kart graficznych ze zmienioną matematyką; to, co jest obliczane, jest homologiczne z AI i niezwiązane z oczekiwaniami jakiegokolwiek konkretnego użytkownika.