W skrócie
- Microsoft twierdzi, że MAI Code 2 osiąga 96% wydajności Claude Opus 5.5 w kodowaniu przy 5% jego kosztów, choć porównanie obejmuje ceny promocyjne.
- Według ocen Microsoftu jego nowy model cyberbezpieczeństwa uzyskał 92,3% w porównaniu z 91,5% GPT-6 Astra w teście wykrywania luk w zabezpieczeniach.
- MAI Image 2.7 znalazł się na szczycie niezależnego rankingu edycji obrazów, a nasze szybkie porównania przemawiały za jego realizmem, kreatywnością i ogólną jakością wyników.
Microsoft zaprezentował we wtorek na swojej konferencji Ignite nową linię wyspecjalizowanych modeli AI, rzucając bezpośrednie wyzwanie Anthropic i OpenAI w dziedzinie kodowania, cyberbezpieczeństwa i generowania obrazów.
Zamiast próbować zbudować jednego chatbota, który pokona wszystkich we wszystkim, proponuje modele wytrenowane do wykonywania określonych zadań przy znacznie niższych kosztach.
Największe twierdzenie dotyczy MAI Code 2, który według Microsoftu osiąga 96% wydajności Claude Opus 5.5 w typowych zadaniach kodowania dla przedsiębiorstw za zaledwie 5% kosztów. Firma twierdzi również, że osiąga 98% wydajności GPT-6.1 Sol przy 40% ceny.
Te liczby to średnie wyniki z czterech ocen skupionych na praktycznym tworzeniu oprogramowania, w tym poprawianiu kodu i wprowadzaniu zmian w wielu plikach. Microsoft przeprowadził trzy z testów na własnej platformie ewaluacyjnej, użył zewnętrznych wyników dla czwartego i obliczył koszty MAI Code 2, stosując 50% zniżki promocyjnej.
Lżejszy model Code 2 Flash jest przeznaczony do rutynowych poprawek i szybkich edycji, a Microsoft twierdzi, że jego wydajność jest porównywalna z Claude Haiku 5.5 przy 20% ceny, czyli jest niezwykle tani bez poświęcania jakości. Oba modele kodowania są już dostępne w GitHub Copilot, wprowadzając technologię własną Microsoftu bezpośrednio do produktu, który w dużym stopniu polegał na zewnętrznych dostawcach AI.
Bezpieczeństwo to kolejny cel. Microsoft twierdzi, że MAI Cyber 2 Flash odniósł sukces w 92,3% ocenianych zadań wykrywania podatności CyberGym-E2E, w porównaniu z 91,5% dla GPT-6 Astra, przy koszcie na zadanie poniżej 2%. CyberGym-E2E ocenia odsetek dochodzeń w zakresie bezpieczeństwa oprogramowania, które AI kończy pomyślnie; Microsoft wykluczył 92 z 905 zadań po zidentyfikowaniu nakładania się ich materiału źródłowego z jego danymi treningowymi.
Firma nie opublikowała jeszcze bezpośredniego porównania z ograniczonym modelem GPT-6 Cyber OpenAI. Jej system bezpieczeństwa zacznie zastępować starszy model MAI dla uprawnionych klientów MDASH w połowie grudnia, opierając się na podejściu do skanowania podatności, które Decrypt wcześniej opisywał.
W AI Dawid też może pokonać Goliata
Czy mały model może pokonać duży? Zdecydowanie — w konkretnych przypadkach.
Model ogólnego przeznaczenia musi nauczyć się pisać poezję, wyjaśniać fizykę, debugować oprogramowanie i odpowiadać na pytania o niemal wszystko. Model dostrojony do kodowania lub cyberobrony może przeznaczyć więcej swojego budżetu treningowego i obliczeniowego na wzorce istotne dla tego zadania, zamiast przenosić tę samą szerokość wiedzy do każdego żądania.
To nie czyni mniejszych modeli uniwersalnie mądrzejszymi. Może je jednak uczynić szybszymi i bardziej ekonomicznymi, gdy zadanie jest dobrze zdefiniowane, szczególnie w biznesie, gdzie ta sama praca jest wykonywana tysiące razy dziennie.
Skaner bezpieczeństwa analizujący każdą nową zmianę kodu nie potrzebuje drogiego modelu frontier, aby wyjaśnić historię Cesarstwa Rzymskiego. Jeśli model może poświęcić całą swoją moc na generowanie kodu w Pythonie, bardziej sensowne będzie płacenie za jego wywołania API zamiast używania superpotężnego modelu ogólnego przeznaczenia.
Specjalizacja może również ulepszyć cały system wokół modelu: narzędzia, które wywołuje, kontrole weryfikujące jego odpowiedzi i dane używane do jego dopracowywania. OpenAI przyjęło pokrewne podejście ze swoimi modelami Mini i Nano, pozwalając tańszym pracownikom obsługiwać rutynowe zadania, podczas gdy większe systemy zajmują się wyjątkami.
Istnieją jednak kompromisy. Własna dokumentacja Microsoftu mówi, że Code 2 nie jest jeszcze zoptymalizowany do fundamentalnych badań naukowych ani bardzo długotrwałych zadań autonomicznych. A Anthropic konkuruje w tańszym segmencie rynku z Haiku, nie tylko ze swoimi premium modelami Opus, więc Microsoft wchodzi do wyścigu, który jego rywale już rozumieją.
MAI Image to bardziej przekonujący dowód
MAI Image 2.7 firmy Microsoft może stanowić najwyraźniejszy dowód, że jej strategia działa. W naszych szybkich testach porównawczych jego obrazy pokonały GPT Image i Nano Banana od Google pod względem realizmu, kreatywności i ogólnej jakości.
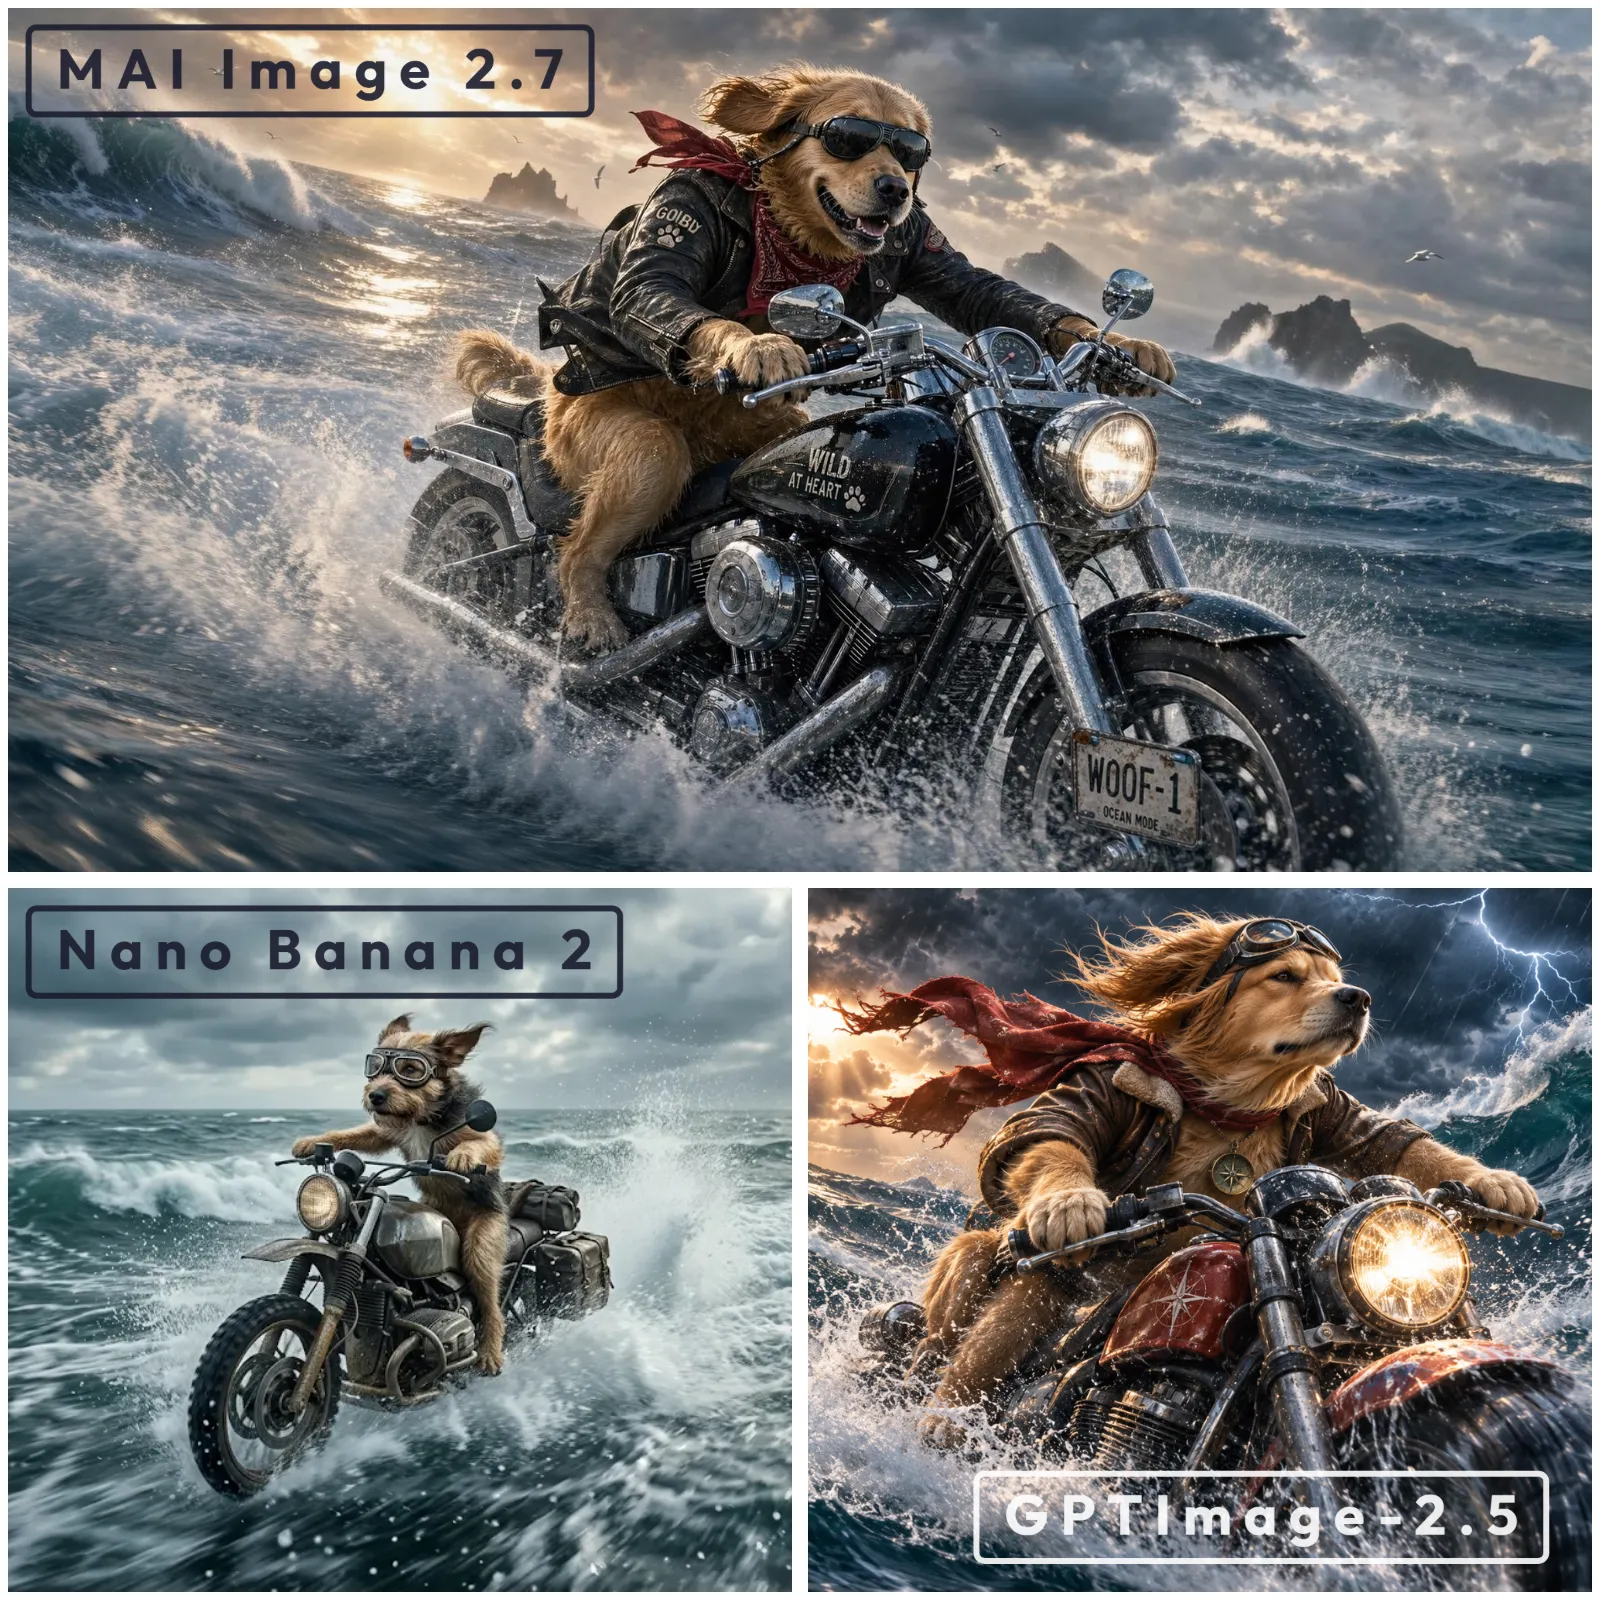
Były to jedynie pierwsze wrażenia oparte na kilku generacjach, ale zasadniczo pokrywają się one z jego mocną pozycją w niezależnych rankingach.
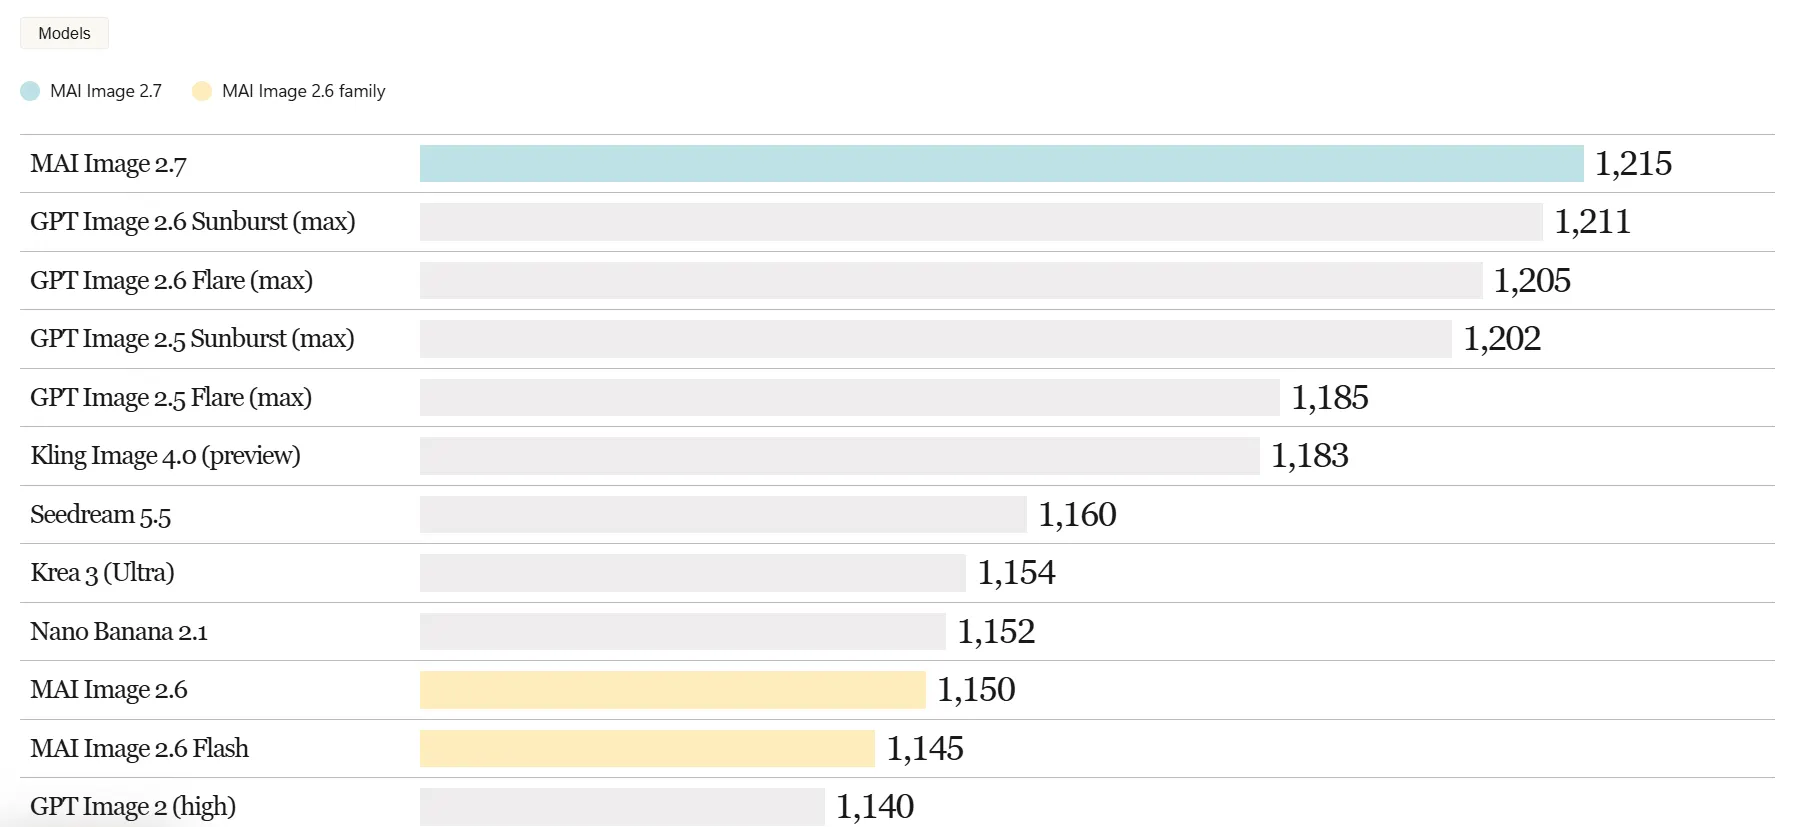
W teście edycji obrazów Artificial Analysis, który prosi ludzi o wybór między anonimowo wygenerowanymi edycjami i przekształca te preferencje w ocenę Elo, MAI Image 2.7 obecnie prowadzi z 1215 punktami wobec 1211 punktów GPT Image 2.6 Sunburst.
Czteropunktowa różnica jest wystarczająco mała, by ich zgłaszane przedziały niepewności się pokrywały; osobny ranking generowania obrazów z tekstu, oceniany tą samą metodą opartą na preferencjach, plasuje Microsoft na czwartym miejscu.
Ceny są trudniejsze do zignorowania. Microsoft podaje około 35 dolarów za 1000 obrazów dla MAI Image 2.7 i 10 dolarów za jego wersję Flash, w porównaniu do około 211 dolarów za GPT Image 2.6 Sunburst w maksymalnej jakości w porównaniu Artificial Analysis. Google Nano Banana 2.1 kosztuje tam około 34 dolarów za 1000, podczas gdy Nano Banana Pro około 134 dolarów; rzeczywiste rachunki zależą od dostawcy, rozdzielczości i ustawień.
Nasze wcześniejsze testy MAI Image 2 wykazały doskonały realizm, ale frustrujące ograniczenia w edycji i formatach wyjściowych. Nowsze wydanie dodaje interaktywną edycję poprzez obszar roboczy Canvas firmy Microsoft, przezroczyste tła i szerszy dostęp poprzez Foundry, chociaż jakość obrazu i użyteczny produkt to wciąż dwie różne rzeczy. To powiedziawszy, model jest również dość ocenzurowany.