Os Agentes de hoje já conseguem chamar ferramentas com proficiência, modificar arquivos e executar testes, mas, ao enfrentar um grande sistema de software que evoluiu ao longo do tempo, conseguem partir de um novo requisito e entregar uma funcionalidade completa?
Quando um gerente de produto propõe um novo requisito, o que os desenvolvedores recebem muitas vezes não é uma lista de arquivos ou assinaturas de funções. Eles primeiro precisam entender as restrições, rastrear dependências entre módulos e então determinar onde alterar, como alterar e como provar que as alterações estão corretas. Essas análises afetam a entrega subsequente.
A Universidade de Fudan, a Universidade da Cidade de Hong Kong, a Universidade Chinesa de Hong Kong e outras instituições propõem o LoLBench, que coloca Agentes em sistemas de software com média de cerca de 2,4 milhões de linhas de código-fonte, avalia o processo completo desde a proposta da funcionalidade até a entrega do módulo e testa a capacidade de percepção para fundamentar requisitos no sistema, bem como a capacidade de implementação para concluir modificações entre módulos.
Link do artigo: https://arxiv.org/abs/2609.37143
Conjunto de dados: https://huggingface.co/datasets/lolbench26/LoLBench
Os experimentos expõem um ponto de ruptura fundamental: um Agente pode fazer uma alteração local correta, mas deixar de lado alterações em outros módulos que precisam ser sincronizadas. Mesmo com orientação de implementação suplementar, a maioria das tarefas permanece sem solução, e ainda há uma longa distância entre compreender os requisitos e concluir a entrega.
Redefinindo tarefas de código de longo horizonte
Que tipo de tarefa de código de longo horizonte tem valor real de engenharia?
"Longo horizonte" não pode ser julgado apenas pelo tempo consumido, número de rodadas ou consumo de Tokens. Por exemplo, pedir a um Agente que produza um número por minuto, contando de 1 a 1000, leva muito tempo, mas exige apenas um loop simples. Tarefas de correção de bugs locais no estilo SWE-bench também não conseguem cobrir o desafio da análise de requisitos até a entrega do módulo.
As tarefas de código de longo horizonte nas quais o LoLBench se concentra são o desenvolvimento de módulos para sistemas complexos. Após receber um novo requisito, os desenvolvedores analisam repetidamente: quais comportamentos devem ser implementados? A arquitetura existente consegue suportá-los? Quais dependências serão afetadas? Como verificar? O LoLBench também incorpora à avaliação essa análise que fica oculta na mente dos desenvolvedores, permitindo que o Agente derive o plano de implementação a partir da intenção do usuário por conta própria.
Tais tarefas possuem simultaneamente complexidade de percepção e complexidade de implementação: a primeira é a dificuldade de compreender a proposta, identificar restrições implícitas e dependências entre módulos, e derivar o escopo de modificação e a especificação de implementação; a segunda é a dificuldade de converter a especificação em modificações corretas entre arquivos e, por meio de testes e reparos, evitar que a funcionalidade existente seja quebrada.
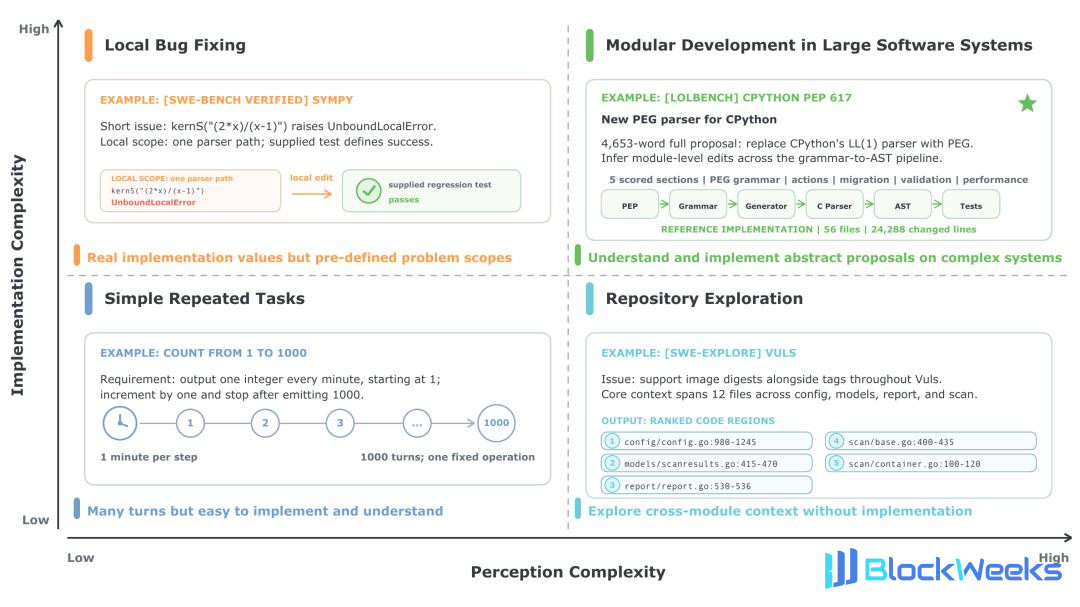
Figura 1 Comparação entre complexidade de percepção e complexidade de implementação.
Como o LoLBench avalia os dois tipos de complexidade simultaneamente
Derivando especificações de implementação a partir de propostas de funcionalidades
O LoLBench seleciona 100 tarefas a partir de Propostas de Aprimoramento da comunidade e seus PRs mesclados correspondentes, cobrindo 29 sistemas, 8 linguagens e 5 domínios.
O Agente recebe apenas a proposta e o repositório de código antes da implementação; a proposta tem, em média, cerca de 5.000 palavras em inglês. A avaliação é realizada em um ambiente Docker offline para impedir que o Agente recupere implementações upstream.
Por exemplo, a PEP 617 [1] propõe substituir o parser LL(1) do CPython por PEG, e a implementação exige conectar definições de gramática, geração de parser, árvores de sintaxe abstrata e relatório de erros. O Agente deve identificar toda a cadeia de implementação.
Em termos de complexidade de percepção, a taxa média de menção na proposta dos nomes das classes-alvo na implementação de referência do LoLBench é de apenas 7,3%, menos da metade do SWE-bench Verified (15,9%) e menos de um quinto do FeatureBench (38,7%). O Agente deve inferir por conta própria a conexão entre os requisitos e o código.
Transformar especificações em entrega de engenharia
Em termos de complexidade de implementação, os repositórios do LoLBench têm em média cerca de 2,4 milhões de linhas de código-fonte, cerca de 9,4 vezes o do SWE-bench Verified e 4,9 vezes o do FeatureBench; as implementações alteram em média 5.499 linhas, em comparação com 38 linhas e 2.050 linhas dos dois últimos. Cada tarefa altera em média 64,9 arquivos, 40,1 classes e 195,9 funções; o número de arquivos é 25 vezes e 4,2 vezes o dos dois, respectivamente. A coordenação e a verificação entre módulos são mais difíceis.

Tabela 1 Comparação do LoLBench com os conjuntos de avaliação de tarefas de código existentes.
O LoLBench verifica a correção da entrega por meio de dois tipos de testes: os testes de novas funcionalidades (F2P) exigem falha antes da implementação e aprovação após a implementação; o F2P verifica o comportamento por meio de interfaces públicas e permite diferentes implementações internas. Os testes de regressão (P2P) exigem aprovação tanto antes quanto depois.
Além dos testes originais do projeto, a equipe de pesquisa constrói implementações errôneas, como funcionalidades ausentes e requisitos adulterados, como mutantes, complementa casos de teste para identificar erros não detectados e melhora a cobertura de testes dos patches de referência.
Após o aprimoramento, a taxa de detecção de 1.688 mutantes sobe de cerca de 61% para 96%, e a cobertura média de linhas por tarefa do F2P sobe de cerca de 60% para 79%.
Desempenho e gargalos de 28 combinações de Agentes
Ao trocar modelos ou scaffolds, a maior taxa de resolução do Agente é de apenas 14%
A equipe de pesquisa avalia 28 combinações disponíveis de 6 modelos de fronteira e 5 scaffolds, com um limite de tempo de 6 horas por tarefa. O Opus 5 emparelhado com Claude Code ou mini-SWE-agent ambos empatam na maior taxa de resolução, com 14%, e a mediana entre todas as combinações é de apenas 2%.

Tabela 2 Principais resultados experimentais do artigo
Usando também o Opus 5, o mini-SWE-agent e o Claude Code alcançaram a mesma taxa de resolução, mas o primeiro levou 3,2 vezes mais tempo que o segundo e gerou 5 vezes mais tokens; mais consumo não trouxe uma taxa de resolução mais alta.
Uma grande quantidade de interação e tokens é gasta na localização de código
Em termos de consumo de tokens, em média entre os agentes, o estágio de localização representou 52,4% dos tokens de entrada não armazenados em cache e 45,4% dos tokens gerados. Em termos do número de rodadas de interação do agente, o estágio de localização também teve significativamente mais rodadas de interação do que os outros estágios.

Figura 2 Número médio de rodadas de interação em cada estágio.
Para arquivos e funções existentes modificados em relação à implementação de referência, em todos os 28 grupos de agentes, a precisão de modificação de arquivos variou de 38,0% a 80,4%, e a recall variou de 30,3% a 65,0%; a precisão de modificação de funções variou de 54,2% a 65,6%, e a recall variou de 20,8% a 53,4%. A precisão de localização de código é baixa, e a cobertura permanece incompleta.
Mesmo após complementar a orientação de modificação, os agentes ainda têm dificuldade em entregar completamente
A equipe de pesquisa manteve a proposta de funcionalidade original e forneceu adicionalmente uma árvore de arquivos de modificação exportada da implementação de referência e especificações de implementação de API para ajudar os agentes a determinar o escopo das modificações. A taxa de resolução do Opus 5+Claude Code subiu de 14% para 34%, o GPT-5.6 Sol+Codex subiu de 3% para 25%,
DeepSeek
V4 Flash+OpenCode subiu de 1% para 17%.

Tabela 3 Resultados experimentais após complementar a árvore de arquivos de modificação e as especificações de implementação de API
Complementar a orientação de modificação pode aliviar a carga de percepção, mas a melhor combinação ainda teve 66% das tarefas não resolvidas. Os agentes ainda precisam coordenar módulos, implementar interfaces e passar na validação, o que sugere que a complexidade de implementação de grandes sistemas também é muito alta.
Da geração de código em direção à evolução de grandes sistemas de software
Esses resultados fornecem direções testáveis para a pesquisa e o desenvolvimento de agentes: se a recuperação de repositórios pode cobrir dependências críticas, se as especificações de implementação antes da codificação estão completas e se a validação pode detectar prontamente omissões entre módulos.
O valor da engenharia de software está em saber se os requisitos do usuário podem ser atendidos de forma confiável. Os agentes precisam entender por que as mudanças ocorrem, como elas afetam o sistema e implementar totalmente as mudanças. O LoLBench espera promover a avaliação das capacidades dos agentes, passando da geração de código para o suporte à evolução contínua do software, fazendo dos resultados de entrega a régua para testar as capacidades dos agentes.
Referência: PEP 617: https://peps.python.org/pep-0617/
Este artigo é da conta pública do WeChat "Xinzhiyuan", autor: Xinzhiyuan; editor: LRST