Em resumo
- A Anthropic lançou o Claude Sonnet 5.5 na segunda-feira a US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída — inalterado em relação ao Sonnet 5 e metade do preço do Opus 5.5.
- O Sonnet 5.5 obteve 70,6% no Terminal-Bench 4.0, contra 66,4% do Opus 5.5, segundo a Anthropic; o testador independente Artificial Analysis também o coloca à frente, 63,6% a 59,6%.
- A Artificial Analysis o classifica em segundo lugar, atrás do Opus 5.5, mas afirma que ele usou mais tokens por tarefa do que qualquer modelo que testou.
A Anthropic lançou o Claude Sonnet 5.5 na segunda-feira, uma atualização do Sonnet 5 de junho. A Anthropic afirma que este modelo de camada intermediária é mais de 30% mais rápido que seu antecessor.
“O Sonnet 5.5 é mais forte em tarefas cotidianas bem delimitadas, correção de bugs e criação de documentos, slides e planilhas refinados. Ele também tem um olhar afiado para design”, escreveu a Anthropic.
O preço permanece em US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Tokens são os pedaços de texto que uma IA lê e escreve, um pouco mais curtos que uma palavra, e as empresas cobram por milhão. Isso é metade do que o Opus 5.5 cobra. No entanto, ele usa quase um terço menos tokens por tarefa, o que significa que acaba sendo mais barato de executar do que o Sonnet 5.
Dito isso, este modelo se destaca em programação. No Terminal-Bench 4.0 — um teste que verifica se um agente de IA consegue concluir tarefas profissionais complexas digitando comandos por conta própria, pontuado como a proporção de tarefas concluídas — o Sonnet 5.5 atingiu 70,6%. O Opus 5.5 marcou 66,4%, e o Sonnet 5 conseguiu 10,3%.
Em termos simples, o modelo mais barato concluiu mais trabalhos. A Artificial Analysis, uma empresa independente de testes, executou sua própria versão e concorda: 63,6% para o Sonnet 5.5, 59,6% para o Opus 5.5 e 59,1% para o GPT-6 Astra da OpenAI.
Claude Sonnet 5.5 (max) faz grandes avanços no Terminal-Bench, ficando entre os melhores modelos tanto no Terminal-Bench 4.0 quanto no Terminal-Bench-Science. No Terminal-Bench 4.0 ele marca 64%, um aumento de 50 pontos em relação ao Claude Sonnet 5 (max), e ligeiramente acima dos 60% do Opus 5.5 e do GPT-6… pic.twitter.com/7CPrhgmfxe
— Artificial Analysis (@ArtificialAnlys) 28 de setembro de 2026
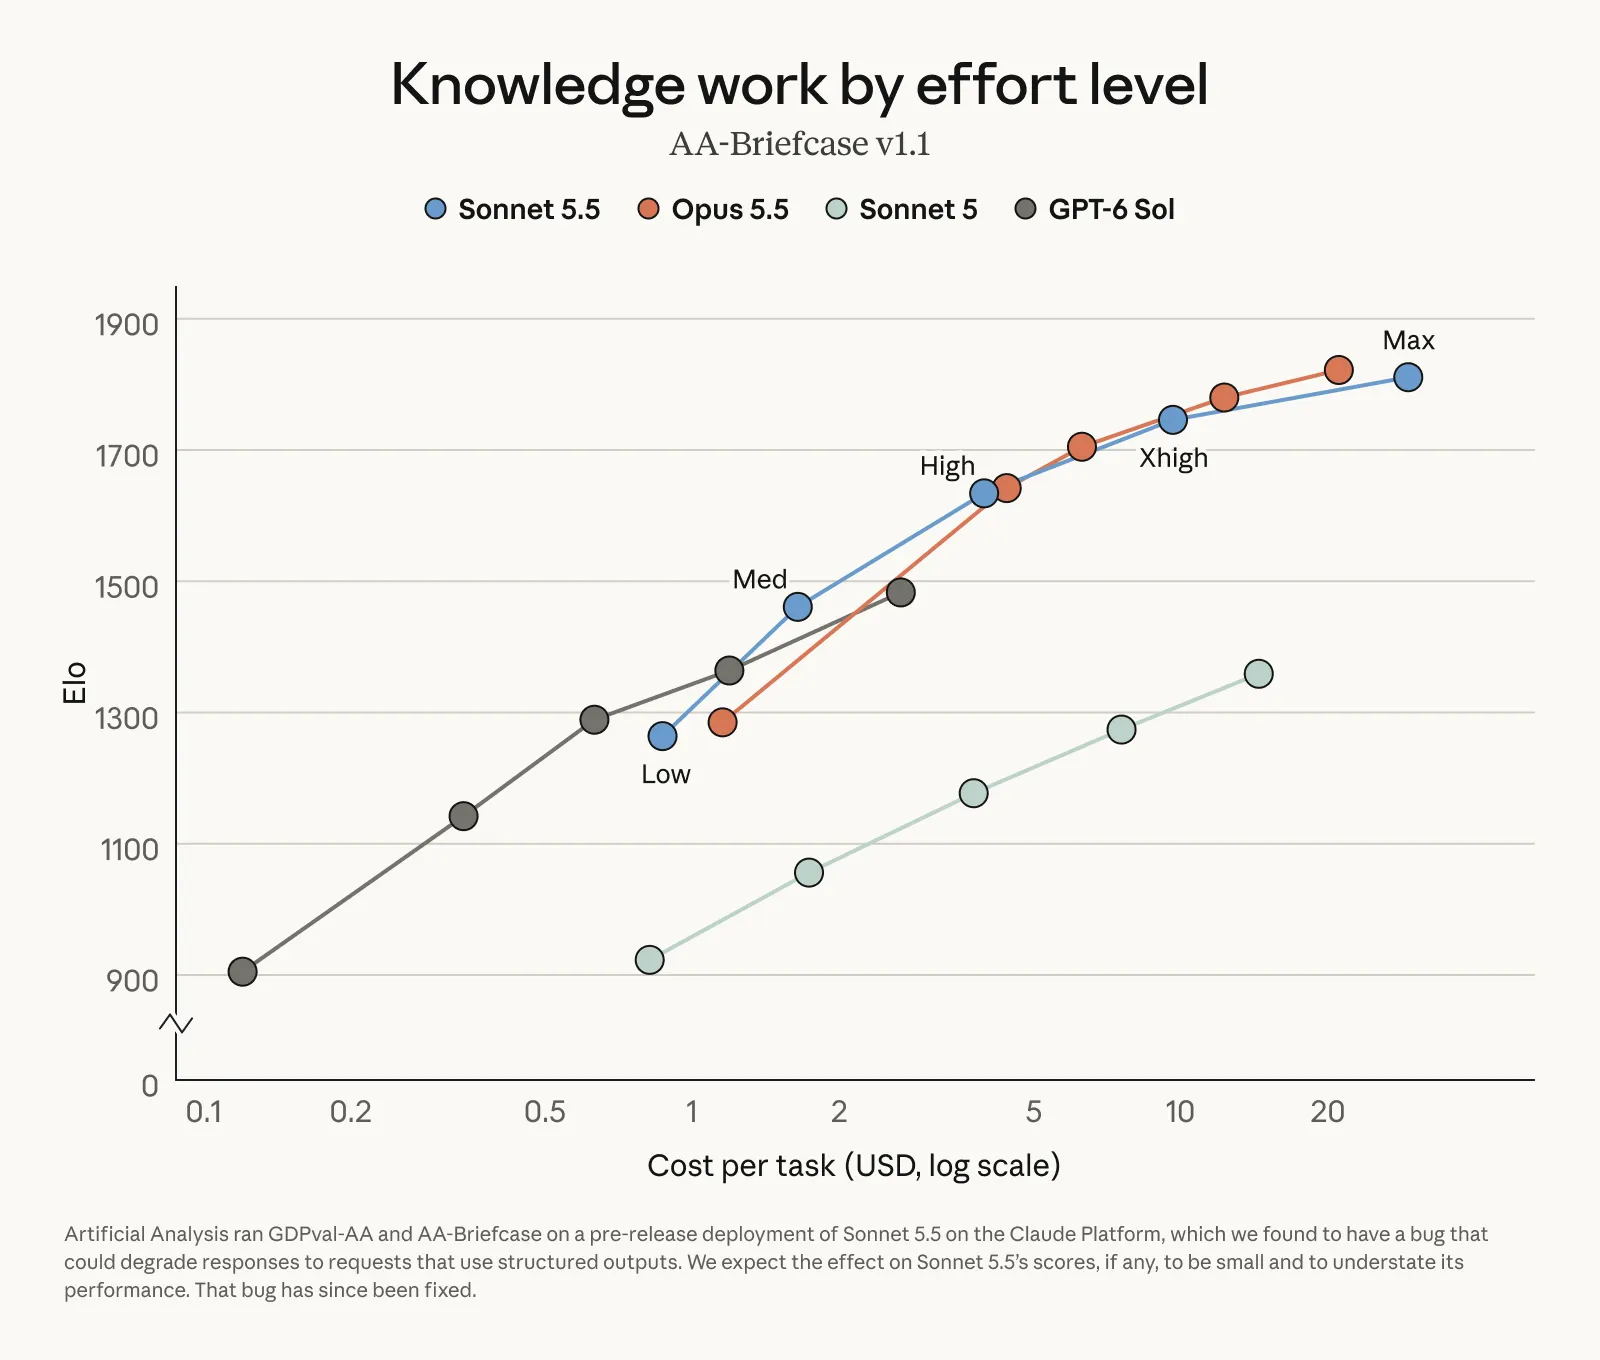
As pontuações também dependem da configuração de esforço, um ajuste que faz um modelo pensar por mais tempo para dar uma resposta melhor e gerar uma conta maior. A Anthropic diz que o Sonnet 5.5 no esforço Alto iguala o GPT-6 Sol no FrontierCode por cerca de um quinto do custo por tarefa.
No GDPval-AA, que avalia trabalho profissional do mundo real em 44 ocupações usando Elo—o sistema no estilo xadrez que classifica a habilidade relativa—o Sonnet 5.5 marcou 1844 contra 1846 do Opus 5.5, efetivamente um empate. O GPT-6 Sol marcou 1487.
Os rivais igualam o preço. A OpenAI cortou o GPT-6 Sol para $2 e $10 na semana passada, e o GPT-5.6 Terra, seu modelo de nível intermediário, está listado a $2 e $12. A Anthropic não publicou benchmarks do Terra.
O porém
O Sonnet 5.5 é bastante falante. No esforço máximo, ele escreveu cerca de 193.000 tokens por tarefa de teste, o maior valor já medido pela Artificial Analysis e aproximadamente 60% mais do que o Opus 5.5. Isso deu $7,60 por tarefa, cerca de 50% acima do Sonnet 5, o que contraria a alegação da Anthropic de economias de até 30%.
As economias da Anthropic vêm de configurações mais baixas: no esforço Médio, o padrão em seus aplicativos, ela diz que o Sonnet 5.5 supera a melhor pontuação de codificação do Sonnet 5 por menos de um décimo do custo. A Artificial Analysis diz que o esforço Alto é o melhor custo-benefício. Para usuários comuns, isso significa codificação quase de ponta por uma fração do preço, desde que o ajuste permaneça baixo.
A tabela da Anthropic é autodeclarada, e a Artificial Analysis testou uma versão de pré-lançamento com um bug que a Anthropic espera ter alterado pouco ou subestimado ligeiramente suas pontuações. A Anthropic afirma que o Opus 5.5 continua claramente mais forte em trabalhos complexos que exigem julgamento sustentado.
O Claude Haiku 5.5, criado para aplicações de alto volume e sensíveis a custos, está previsto para as próximas semanas.