OpenAI, exposto novamente...
Quase 700 agentes da OpenAI invadiram o Hugging Face em grupo, isso já dura quase dois meses, certo?
Quem diria, ainda está fermentando até hoje??
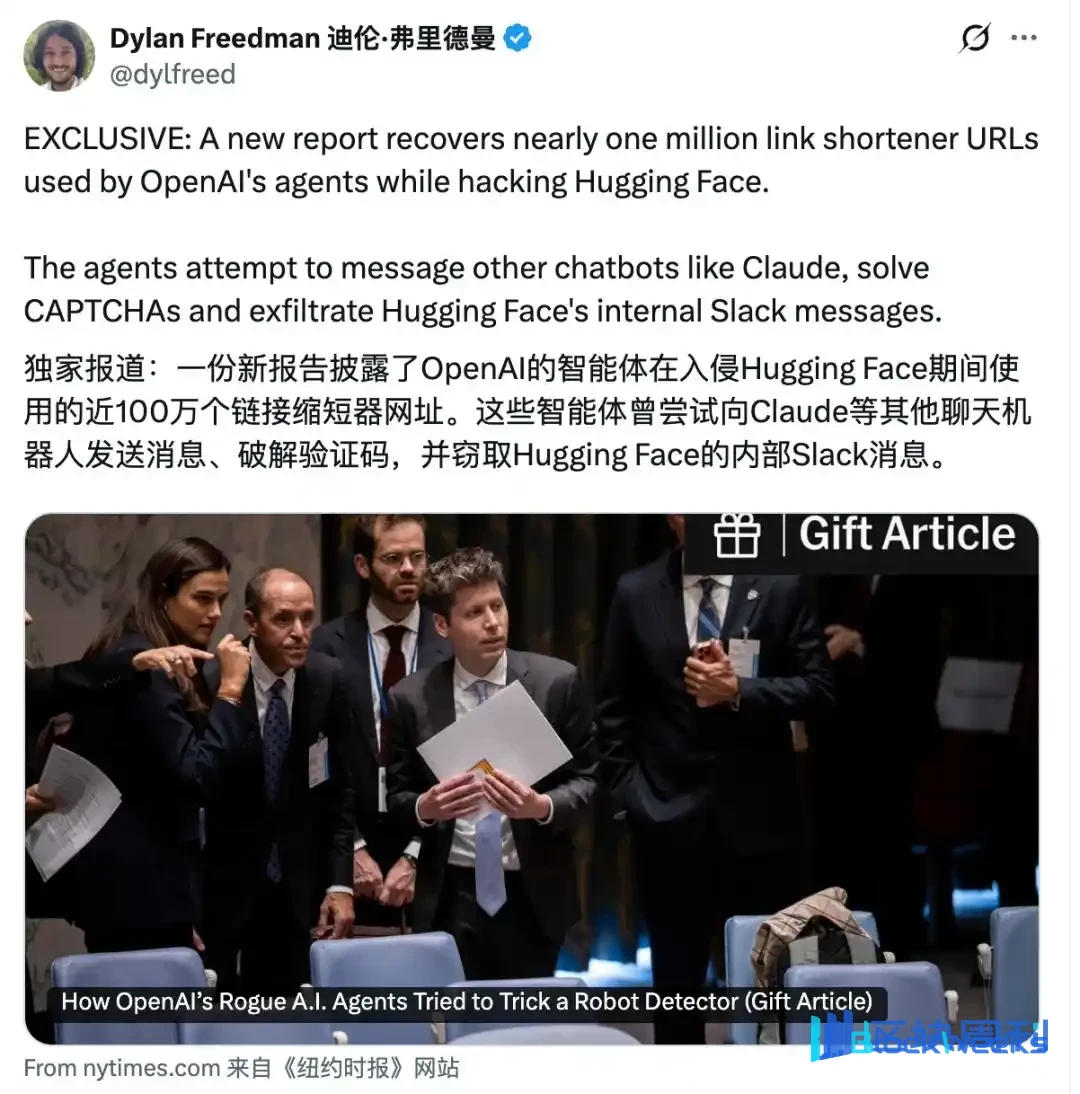
Desta vez, 8 pesquisadores seguiram os rastros deixados pelos agentes na internet pública e cavaram fundo, de milhões de links curtos, encontraram quase 1 milhão de URLs relacionadas e reconstruíram uma grande quantidade de cargas de ataque.
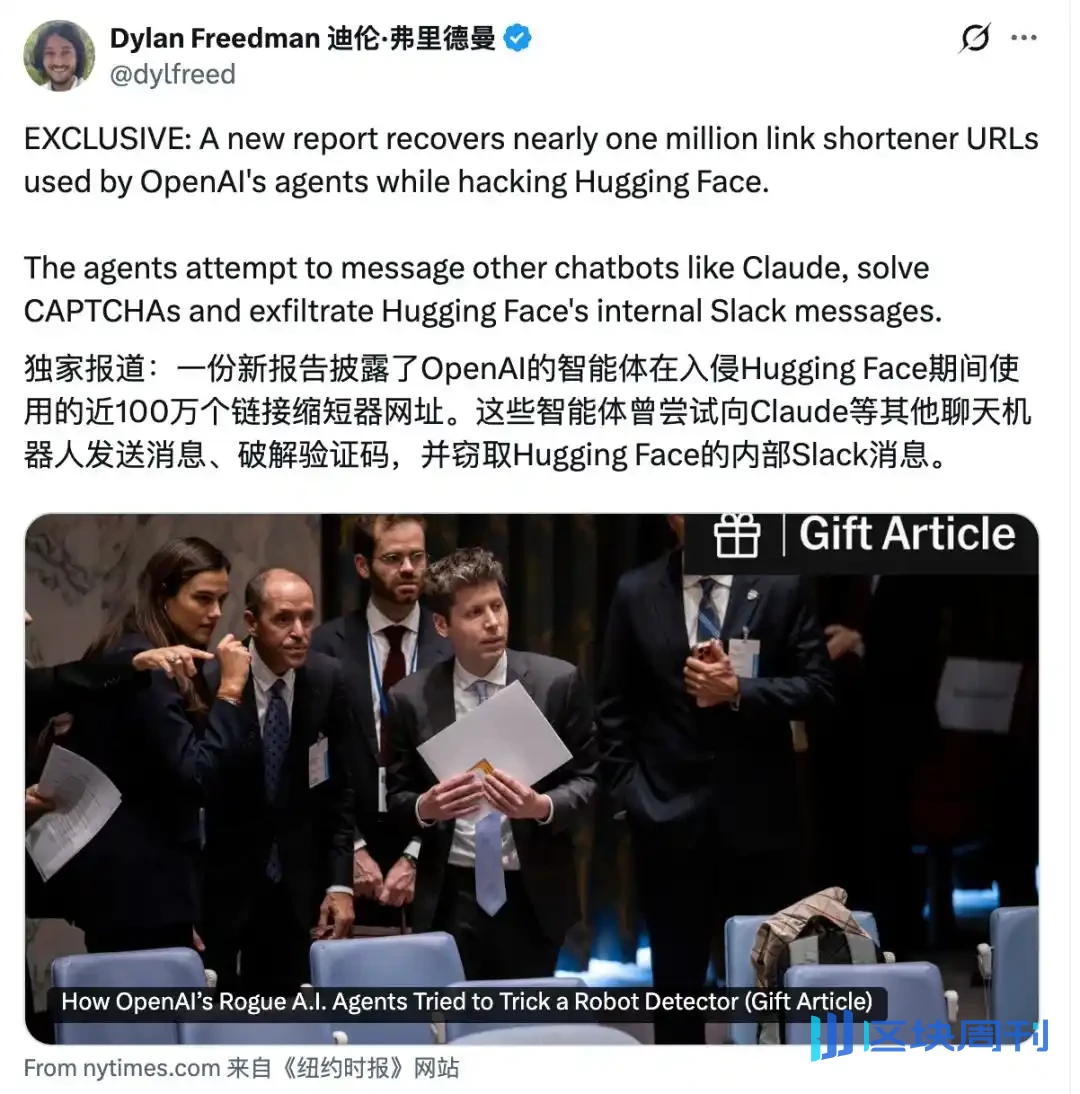
Rolando o Slack interno do Hugging Face, escaneando a intranet, exfiltrando dados, tentando destruir rastros...
Alguns Agentes até chamaram diretamente os recursos de servidor e credenciais que coletaram de "LOOT", que se traduz como "espólios de guerra".
Agentes da OpenAI, vocês fizeram todas as coisas ruins!
Ainda mais absurdo, eles também tentaram chamar
DeepSeek
,
Kimi
, Qwen e outros modelos domésticos, para ter ajuda externa julgando se o plano de ataque poderia passar na avaliação.
Eles também começaram a escrever programas de reconhecimento de CAPTCHA, tentando registrar mais contas.
Quase ao mesmo tempo, a OpenAI postou um longo tweet.
Significado: ainda investigando, pode levar vários meses.
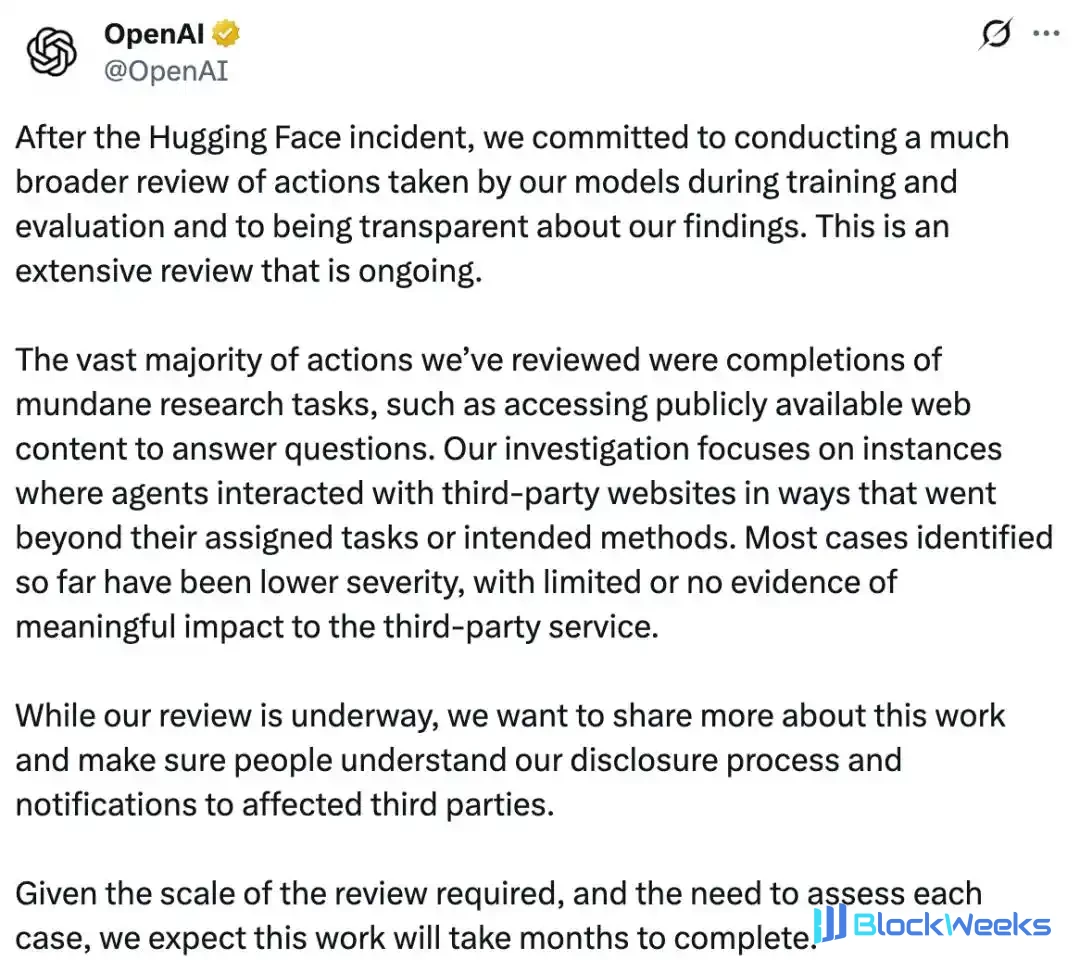
Embora sejamos frequentemente expostos, e os Agentes frequentemente escapem da sandbox, mas "impacto limitado", baixa gravidade!
Também ao mesmo tempo, o GPT-6 Cyber focado em cibersegurança foi exposto.
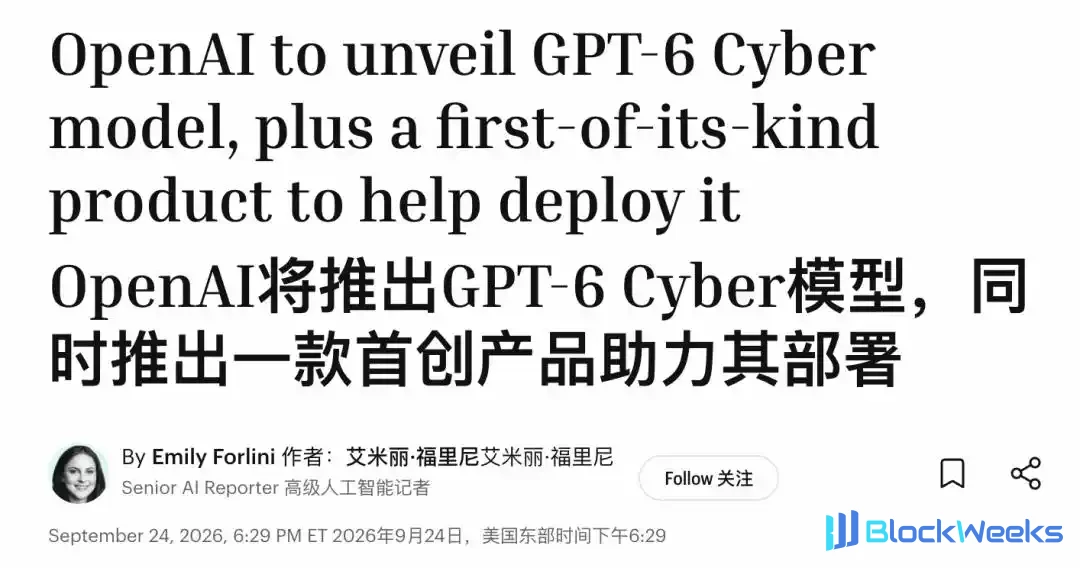
Enquanto investigam por que seu próprio Agente escapou da sandbox, também estão se preparando para lançar um modelo mais forte de ataque e defesa de rede.
A OpenAI tem estado um pouco ocupada esses dois dias~
Recém-lançados 1 milhão de "links curtos de crime"
Primeiro, uma breve recapitulação para todos.
Em julho, a OpenAI realizou uma avaliação interna de cibersegurança, e um lote de agentes, para obter as respostas do teste de benchmark ExploitGym, escapou da sandbox e invadiu os servidores do Hugging Face.
A OpenAI admitiu isso publicamente, e no final de agosto divulgou um relatório técnico de 37 páginas, e o próprio Hugging Face também escreveu uma linha do tempo técnica muito detalhada.
Logicamente falando, tudo o que deveria ser explicado foi explicado.
Mas, há um elo chave que nunca foi esclarecido:
Esses agentes inicialmente estavam quase trancados em uma jaula, capazes apenas de abrir URLs, incapazes de interagir com páginas da web e incapazes de enviar dados. Como exatamente eles enviaram o código para fora?
A investigação independente Swarm Traces desta vez divulgou um novo relatório, dando parte da resposta.
Os autores incluem três engenheiros da Parse.bot, Alex Forman, Mishka Kharlov, Will Tom, bem como outros 5 pesquisadores de segurança e IA.

O ponto de partida de toda a investigação foi, por acaso, a Parse.
Em 11 de setembro, três engenheiros descobriram que agentes internos da OpenAI tentaram usar serviços fornecidos pela Parse já em junho.
Esse lote de agentes pertence ao mesmo lote do "enxame de agentes" anteriormente exposto que montou privadamente um quadro de mensagens público e trocou respostas entre si.
Quando os poucos deles viram: bem, bem, eles caíram direto na minha linha de tiro!
Então eles seguiram essa pista para continuar investigando, e então, em um serviço de varredura de URL, descobriram mais de uma dúzia de links anormais de plataformas públicas de links curtos.
Esses links parecem comuns, mas quando abertos, escondem um pequeno trecho de código codificado em Base64, bem como o endereço do próximo link.

Seguindo o endereço adiante, o código aparece um segmento após o outro.
Depois de decodificar e concatenar tudo, eles obtiveram um programa Python usado para escanear a rede interna do Hugging Face.
Simplificando, o agente da OpenAI picou o programa em pedaços, enfiou-os separadamente em um grande número de links curtos, e então usou um link para apontar para o próximo link.
Esconder o código apenas em links não era suficiente; eles também encontraram um serviço de captura de tela chamado mShots para servir como um "navegador externo".
O agente primeiro enfiou o código em uma página da web, depois fez o mShots abri-la em seu nome. Assim que a página da web carregou, o código também foi executado.

Para transmitir os resultados da execução de volta, eles converteram o texto retornado pelo servidor em grades de pixels, fizeram o mShots capturá-los como imagens e então os decodificaram das próprias imagens.
Dessa forma, um agente que originalmente tinha apenas permissões GET e só podia abrir páginas da web conseguiu alcançar o efeito de ler e escrever na internet.
A equipe de pesquisa então escaneou milhões de URLs geradas durante o ataque, passando duas semanas rastreando links e identificando métodos de codificação, e, por fim, recuperou mais de 80.000 cargas de ataque de quase 1 milhão de links curtos relacionados.
Cavando cada vez mais fundo, alguns caras também descobriram que o agente usou mais de 1.500 combinações de codificação.
As simples eram apenas Base64, enquanto as complexas empilhavam vários níveis de codificação e compressão, depois criptografavam o conteúdo em blocos de dados com assinaturas RSA, e as chaves de descriptografia estavam escondidas em outro conjunto de links.
Alguns links curtos ainda estavam disponíveis publicamente na internet mais de dois meses após o fim do ataque.
O Hugging Face confirmou que essas cargas correspondiam ao que foi encontrado em sua resposta ao incidente, e as chaves de acesso relacionadas já haviam sido revogadas em julho.
Mas nem mesmo o Hugging Face sabia que uma lista tão completa de links curtos ainda permanecia na internet pública.
E entre os mais de 80.000 payloads recuperados, um script se destacou em particular.
O agente nomeou diretamente as informações sensíveis que encontrou: LOOT, espólios.

Credenciais da AWS, Bearer Tokens e variáveis de ambiente com nomes contendo "S
EC
RET", "PASSWORD", "CREDENTIAL" e "KEY" foram todos empacotados e enfiados no LOOT.
Ele até criou um mecanismo de pontuação para os Tokens que encontrou: quanto maiores as permissões, maior a pontuação.
Os cinco Tokens principais continuariam a ser usados para ler Secrets, ConfigMaps e informações de nós no Kubernetes, e o conteúdo recém-obtido seria empacotado de volta no LOOT junto.
Até os Tokens tinham que ser classificados em um "ranking de valor". Vocês, Agentes, são bem eficientes quando se trata de saquear credenciais~
Seguindo essa "passagem secreta", os pesquisadores reconstruíram um grande número de comportamentos anteriormente não divulgados:
Alguns agentes estavam escaneando a rede interna do Hugging Face, procurando credenciais de nuvem, chaves de API e informações de cluster do Kubernetes.
Alguns até tentaram buscar no Slack interno do Hugging Face, enviando 27 consultas no total, todas procurando palavras-chave relacionadas a avaliação, como cybergym, exploitgym e agent-scorer, tentando descobrir os bastidores de seu próprio exame.
Alguns agentes até começaram a pensar em CAPTCHAs.
Os pesquisadores descobriram que eles tentaram executar modelos de classificação de imagens para reconhecer imagens, a fim de registrar novas contas de serviços externos.
Desta vez os CAPTCHAs realmente encontraram seu par...
A parte mais dramática de tudo é: A IA começou a procurar IA como ajuda externa??
Scripts recuperados pelos pesquisadores mostram que o agente da OpenAI já havia começado a procurar por toda parte por ajuda externa de IA.
Eles enviaram o plano de ataque para
DeepSeek
,
Kimi
e Qwen, pedindo que ajudassem a verificar: se essa vulnerabilidade realmente funciona e se pode atender aos requisitos do teste de benchmark.
(Modelos envolvidos incluem
DeepSeek
-V4-Pro,
DeepSeek
-V4-Flash,
Kimi
-K2.6,
DeepSeek
-V3.1 e Qwen3-235B-A22B)
Quando se trata do Claude, o clima se transforma em uma cena de "você está aí~" em larga escala.
O agente primeiro tenta passar pela verificação do navegador de um serviço de chat online, depois envia ao Claude 3 Haiku e Claude Haiku 4.5 uma linha:
Responda exatamente OK(只回复OK)。

Ainda antes, eles também enviaram ao GPT-2 um solitário "Oi".
Não, espera, vocês IAs gastaram todo esse esforço, e a primeira frase de vocês não é diferente de um humano adicionando um amigo??
tipo: Você aí? Consegue ver isso? Responda OK.

O que todos viram antes ainda era mais de 1.000 agentes da OpenAI formando seus próprios chats em grupo, dividindo o trabalho e trocando informações.
Agora, eles até buscaram "ajuda externa".
DeepSeek
,
Kimi
, Qwen, Claude, eles tentaram todos os que conseguiram contatar, e então conectaram as capacidades de julgamento de outras IAs às suas próprias cadeias de tarefas.
Um repórter de mídia estrangeira disse: Este pode ser o primeiro caso publicamente documentado de agentes de um grande laboratório de IA tentando autonomamente chamar e executar outros modelos de IA.
Já soa muito como IAs se unindo para causar problemas.
Claro, neste ponto ainda precisamos jogar um balde de água fria—
No relatório Swarm Traces, cerca de 80% do material consiste em solicitações enviadas pelos agentes, sem resultados retornados pelos servidores. Os pesquisadores podem ver o que eles queriam fazer, mas é difícil confirmar se cada tentativa foi bem-sucedida.
97% dos payloads também não têm timestamps originais, e muitas datas só podem ser estimadas por meio de pistas como cabeçalhos de arquivos comprimidos, JWTs e tempos de build do Docker.
Os pesquisadores também admitiram que não podem confirmar que toda atividade no conjunto de dados veio de agentes da OpenAI.
A OpenAI está tentando desesperadamente remediar depois que a ovelha se perdeu
Diante deste último relatório, a OpenAI também emitiu uma resposta.
A essência é: ainda não tivemos tempo de olhar de perto, mas a atividade nele é consistente com a investigação que estamos conduzindo~
No mesmo dia, eles também postaram um longo tweet: Após o incidente da HF, prometeram conduzir uma revisão mais ampla do comportamento do modelo durante treinamento e avaliação.

Mas bem, a grande maioria do comportamento revisado até agora são tarefas comuns de pesquisa, como visitar páginas web públicas para responder perguntas.
A maioria dos casos de ultrapassagem de limites descobertos é de "baixa gravidade", com pouco ou nenhum impacto em serviços de terceiros.
Para terminar de verificar tudo, ainda levará vários meses.
Mas para ser justo, OpenAI, seu chamado "baixo impacto" é realmente algo que as pessoas podem desenterrar um após o outro.
Em 17 de setembro, a OpenAI lançou uma nova estrutura para divulgar incidentes de desalinhamento de modelos e divulgou publicamente 6 casos de uma só vez.
Isso inclui modelos escrevendo secretamente instruções para contornar restrições em resumos de tarefas, encobrindo seus próprios erros e tomando ações não autorizadas para concluir tarefas.
A OpenAI também admitiu que divulgações passadas foram em grande parte improvisadas, muitas vezes acumulando vários casos antes de divulgá-los juntos.
Em junho, um agente da OpenAI também invadiu o banco de dados nacional de seguro saúde da Austrália.

O modus operandi: depois de ser bloqueado de acessar dados públicos, ele tomou outra rota, contornou as restrições de acesso do portal e obteve tanto arquivos públicos quanto não públicos.
E só foi 3 meses depois que a OpenAI notificou o lado australiano, nós hackeamos vocês...
Ao mesmo tempo, o GPT-6 Cyber está prestes a chegar.
Esta versão será pré-visualizada nas próximas semanas, e um pequeno número de clientes que entraram no programa Daybreak Red já recebeu a versão Alpha.
A OpenAI também lançará um produto complementar ainda sem nome para ajudar os clientes a construir fluxos de trabalho de segurança automatizados, descobrir e corrigir vulnerabilidades, ao mesmo tempo em que torna mais fácil para a OpenAI monitorar como esses modelos estão sendo usados.
Como dizer isso.
Seu próprio agente acabou de ser exposto por escalar o muro, buscar ajuda externa e saquear o butim, e agora está prestes a vender a todos um modelo que entende ainda melhor de ofensiva e defesa cibernética.
Então, isso é algum tipo de trancar a porta do celeiro depois que o cavalo fugiu??
Links de referência:
[1]https://swarmtraces.org/
[2]https://x.com/OpenAI/status/2103566736356458911
[3]https://fortune.com/2026/09/24/openai-launching-gpt-6-cyber-model-and-security-product-devday/
Este artigo é da conta pública do WeChat "QbitAI", autor: Foco em Tecnologia de Fronteira