
Невже бенчмарки справді еволюціонували до такого рівня???
Цього разу йдеться вже не про розв'язування тренувальних задач — ШІ просто дають набір експериментальних умов і дозволяють йому самостійно проводити дослідження та заздалегідь передбачати результати реальних лабораторних експериментів...
Наприклад, якщо одну й ту саму реакцію провести за кількох різних умов, яка з них дасть більше цільового продукту? Серед партії варіантів антитіл який матиме вищий рівень експресії?
Відповіді спершу приховуються, і після того, як ШІ здає свою роботу, фактично виміряні результати порівнюються з нею.
І знаєте що, це насправді те, що варто перевірити вже зараз.
За останні два роки підхід AI for Science дедалі поглиблювався — ШІ вже здатен самостійно шукати літературу, користуватися програмним забезпеченням і безперервно працювати годинами, щоб завершити завдання аналізу.
Природно, усі почали переходити до наступного етапу: які саме дослідницькі здібності ми насправді хочемо, щоб мав ШІ?
Передбачення результатів лабораторних експериментів — один із пунктів із чималою практичною цінністю.
Це вимагає від ШІ розуміння мети експерименту та виокремлення відповідних механізмів із наявних знань, щоб він міг краще допомагати дослідникам відбирати напрями досліджень, варті подальшого вивчення.
Новий бенчмарк Science Prediction Universe (скорочено SPU), започаткований і запущений під проводом UniPat AI, гостро це помітив.
116 завдань, 4 207 лабораторних експериментів, що охоплюють хімію, матеріалознавство, біологію та медицину. Консультанти бенчмарку та лабораторні партнери також походять з таких університетів, як Стенфорд, Корнелл і Гарвард, а також із передових дослідницьких установ і біотехнологічних компаній у цій галузі.
Модель щоразу працює за системою 8-годинного робочого дня, оснащена H20, а потім самостійно вирішує, як використовувати ресурси пошуку та обчислень для формування експериментальних прогнозів.
Результати здивували всіх.
Навіть такі сильні моделі, як Opus 5.5 і GPT-6 Astra, згідно з даними, все ще дуже далекі від того, щоб справді бути здатними досягти передбачення...
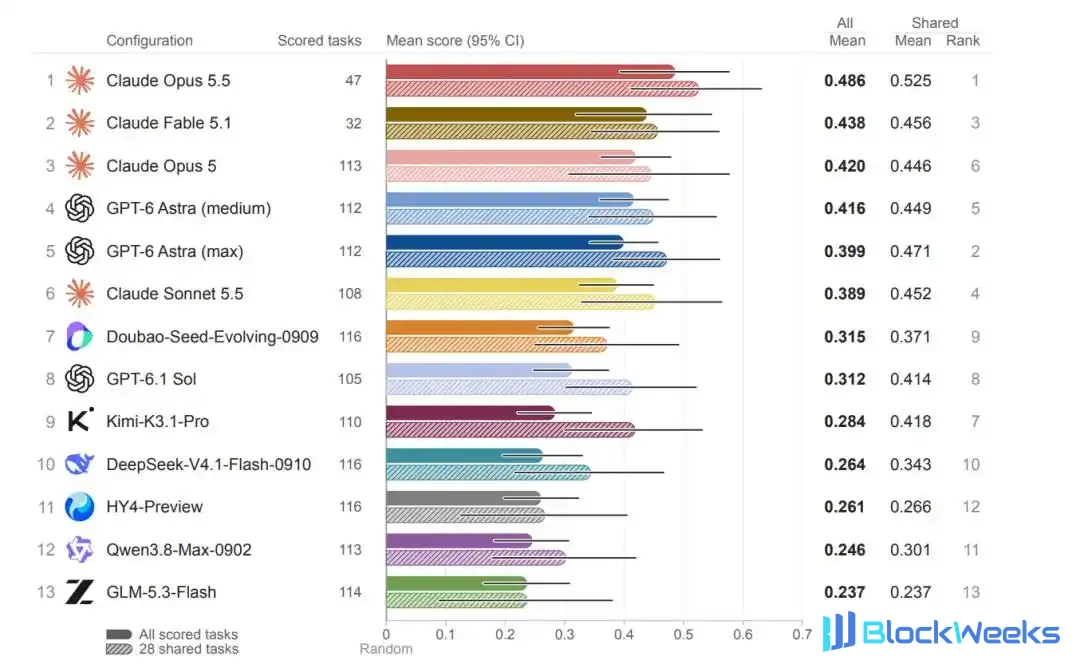
△Середні бали кожної конфігурації за всіма оцінюваними завданнями
Мушу сказати, SPU подала всім дослідницьким моделям непросту страву.
Ті дослідницькі здібності, які раніше були невидимими й невловимими, тепер стали числовими значеннями, які можна уніфіковано оцінювати й безперервно вивчати.
Щодо того, як наукове судження ШІ розвивається крок за кроком, тепер є конкретніша основа для обговорення.
Передбачення лабораторних експериментів: варте окремого іспиту для моделей
Повертаючись до передбачення лабораторних експериментів — передусім, це справді не нове питання.
В історії науки було багато таких моментів: судження робиться до експерименту, а потім це залишається на розсуд процесу — якщо правильно, воно залишається; якщо помилково, його спростовують.
Конкретна логіка судження становить смак науковця.
Маючи достатньо добрий смак і достатньо точну інтуїцію, науковці можуть швидше отримувати великі результати, заощаджуючи дорогоцінні експериментальні ресурси.
Зрештою, лише один експеримент у вологій лабораторії — для хімії потрібно приготувати реагенти, встановити умови реакції, а потім розділити продукти; для біології також доводиться проходити тривалу експресію білків... Витрати часу та витрати на інструменти самі по собі досить дорогі, і якщо результати неідеальні, доводиться повторювати це знову і знову протягом кількох раундів.
Тому прогнозування перед початком є найціннішим кроком у процесі дослідження.

Єдина відмінність полягає в тому, що раніше це робили виключно самі науковці, а тепер, в епоху ШІ, моделі також повинні мати цю здатність, і їм також потрібен тестовий лист, який може їх оцінити.
Існуючі бенчмарки все ще не можуть повністю охопити це. Наприклад, BrainBench дозволяє моделям безпосередньо оцінювати результати експериментів; ScienceAgentBench зосереджується на завершенні аналізу на наявних даних; а бенчмарки довготривалих завдань, такі як Terminal-Bench 4.0 та Long-Horizon-TB, переважно використовують попередньо встановлені тести для перевірки результатів завдань.
SPU відрізняється від усіх них.
Він більше наголошує на перевірці автономного дослідницького процесу ШІ разом із прогнозуванням результатів вологої лабораторії, охоплюючи як продуктивність прогнозування, так і здатність використовувати наукові інструменти та виконувати довготривалі завдання.

△Діаграму згенеровано ШІ
Такого роду судження також були організовані SPU у чіткі завдання.
100 публічних завдань були відповідно взяті з 85 нещодавно опублікованих статей. Експерти галузі організували варіанти-кандидати, матеріали, умови та методи вимірювання з дослідження, зберігши повні кількісні результати як основу для оцінювання.
Крім того, 16 приватних завдань походять від чотирьох груп неопублікованих спільних експериментів у вологій лабораторії, що охоплюють наноантитіла VHH, умови реакції, електроліти та варіанти Магролімабу.
Загалом 32 підгалузі та 4207 експериментів, серед яких публічні дослідження забезпечують міждисциплінарні джерела завдань, виміряні результати приховані від моделей, а неопубліковані експерименти додають тести, незалежні від відповідей у публічних статтях.
Певною мірою це може запобігти тому, щоб моделі бачили запитання заздалегідь.

△Охоплення та джерела завдань SPU
Процес відбору запитань також досить вимогливий.
Експерти віддають перевагу дослідженням із повними вимірюваннями та чіткими умовами; прості запитання, які можна впорядкувати за єдиною тенденцією, безпосередньо виключаються, а запитання з занадто близькими значеннями також вважаються такими, що мають мало цінності для порівняння.
Запитання, що зрештою залишаються, усі складніші та мають більшу розрізнювальну здатність.
Під час конкретного процесу прогнозування модель повинна працювати вісім годин щоразу, оснащена 8-ядерним процесором, 16 ГіБ пам'яті та одним H20, при цьому їй дозволено шукати в Інтернеті та встановлювати програмне забезпечення для наукових досліджень.
Протягом цього часу модель самостійно збирає докази, обирає обчислювальні методи і зрештою подає прогнозований рейтинг від низького до високого для кожної групи порівняння.
Щоб запобігти забрудненню пам'яті, процес оцінювання також повністю проводиться в незалежному офлайн-контейнері; ШІ заборонено отримувати оригінальні результати дослідження, а вихідні дані інструментів автоматично скануються для виявлення ідентифікаторів, таких як DOI та назва вихідної статті.
Нарешті, система використовує коефіцієнт кореляції Спірмена для порівняння прогнозованого рейтингу з виміряним рейтингом.
Чим ближче коефіцієнт до 1, тим ближчий рейтинг до експериментальних результатів.

△Процес оцінювання SPU
Цікаво, що SPU також звертає увагу на багато деталей, які не враховувалися в еталонних тестах.
Наприклад, щодо фінальної оцінки SPU враховує, чи не могло це бути через випадковість, щоб уникнути ситуації, коли сліпа кішка натрапила на мертву мишу.
Тому він додатково генерує 4000 випадкових рейтингів для кожного питання, використовує 95-й процентиль як поріг випадкового рівня та перевіряє, чи значно перевищує подання моделі цей орієнтир. Різні завдання також мають відповідні базові орієнтири.
Дизайн усього SPU можна назвати науково строгим.
Модель повинна крок за кроком усередині нього самостійно визначати, що варто обчислювати, і подавати свій остаточний прогноз.
Цей дизайн не лише допомагає виміряти поточну здатність ШІ до прогнозування в умовах вологих лабораторій, а й вказує напрямок для подальших дослідницьких груп щодо постійного вдосконалення експериментів за допомогою уніфікованих метрик.
Тим не менш, далі ми можемо разом поглянути на звітні картки першої партії передових моделей. Деталі цілком варті окремого обговорення.
Новий тест змушує передові моделі колективно зазнати краху
Перший раунд систематичного оцінювання SPU охоплює 12 передових моделей і 13 конфігурацій. Конфігурації тут означають модель, інтенсивність міркування та використовувану модельну структуру.
Спочатку поговоримо про загальні результати.
Одним реченням: жодна з них не є хорошою.
Серед усіх оцінених завдань найвищий середній бал був у Claude Opus 5.5 — 0,486 бала. Але навіть для нього лише половина завдань перевищила випадковий рівень.
Серед 13 конфігурацій це майже завжди так; частка завдань, що перевищують поріг випадкового рівня, становить лише від 34% до 52%.
Іншими словами, усім представленим моделям ще далеко до справді надійного прогнозування в умовах вологих лабораторій.

△Порівняльний аналіз поведінки провідної та відстаючої груп
Однак між моделями також є відмінності, і середню продуктивність можна поділити на два рівні:
провідну групу (6 моделей) і відстаючу групу (7 моделей).
У порівняннях на однакових питаннях провідна група в середньому все ще приблизно на 0,15 бала вища за інші сім.
Є ще одна деталь, варта уваги. Близько 9% завдань у провідній групі отримали оцінку нижче 0, тоді як для інших семи конфігурацій ця частка може сягати 22%.
Тут 0 означає середній бал випадкового дійсного рейтингу; негативний бал означає, що прогноз негативно корелює з фактичним рейтингом.
Звідки саме виникає розрив? Дослідницька група копнула на крок глибше.
Спочатку вони об'єднали прогнози інших моделей щодо того самого питання в еталонний рейтинг, потім попарно зіставили експерименти, порівняли їх із виміряними результатами та перевірили, чи кожна модель окремо ранжувала їх правильно.
На парах експериментів, де еталонний рейтинг був правильним, провідна група ранжувала їх правильно у 86% випадків, тоді як інші сім конфігурацій досягли 78%; для пар експериментів, де еталонний рейтинг був неправильним, обидві групи незалежно ранжували їх правильно приблизно у 30% випадків.
Отже, насправді частина переваги провідної групи саме відображається в тих місцях, де прогнози спільно правильні; у цій частині провідна група завжди стабільніша.

Щодо того, чому модель відхиляється від правильного судження, записи запусків містять більш конкретні підказки.
Візьмімо як приклад завдання з розчином. Для тієї самої реакції полімеризації послідовно змінили 12 розчинників, і завдання вимагало ранжувати за масою полімеру, остаточно виділеного.
Opus 5.5 отримав оцінку 0.874, тоді як Qwen3.8 отримав -0.126. 12 кандидатних умов розчинників були попарно зіставлені, загалом 66 пар; перший правильно ранжував 56 пар, а другий правильно ранжував 30 пар.

△Два запуски Opus і Qwen на тому самому завданні
Аналіз показав, що це тому, що вони відрізнялися в чинниках, на які звертали увагу з самого початку:
Qwen3.8 переважно ранжував на основі того, наскільки багато етилену може розчинити розчинник, тоді як Opus 5.5 більше звертав увагу на змішуваність сировини та сумісність каталізатора в розчиннику.
Хоча Qwen3.8 також виявив цю проблему під час процесу обчислення, він зрештою не зміг безпосередньо змінити основу ранжування, остаточно прийняту моделлю.
Тому етап, на якому найімовірніше виникають помилки прогнозування, — це крок вибору основи для судження. Модель також повинна навчитися коригувати метод ранжування в реальному часі відповідно до підказок, щоб ці висновки могли справді впливати на відповідь.
Якщо розкласти, ці відмінності також варіюються залежно від конкретної дисципліни та завдання.
Серед оцінених результатів для кожної дисципліни в публічних завданнях найвищий середній бал з хімії був у Opus 5.5, з матеріалознавства — у Fable 5.1, з біології — у GPT-6 Astra Medium, а з медицини — у Opus 5.
P.S. Fable 5.1 і Opus 5.5 продемонстрували поведінку відмови від відповіді.

△Оцінки кожної моделі за чотирма дисциплінами
Тож якщо ви готуєтеся залучити ШІ до певного типу досліджень, можливо, варто спочатку знайти відповідне завдання та перевірити його за допомогою SPU, і лише після підтвердження, що модель справді придатна, переходити до формальних експериментів.
Результати приватних завдань роблять цей момент ще більш конкретним.
Серед 13 конфігурацій 12 мали середні бали, значно вищі за випадкове ранжування, і жодних очевидних відмінностей між конфігураціями не виявлено. Натомість варіація, спричинена різними завданнями, була особливо разючою.
Для однієї й тієї ж партії електролітів, під час прогнозування іонної провідності, коефіцієнти рангової кореляції 13 конфігурацій були зосереджені в діапазоні від 0,89 до 0,95; коли ж перейшли до електрохімічного вікна, оцінки 12 конфігурацій, які отримали бали, коливалися від -0,55 до 0,07, жодна не перевищувала поріг випадкового рівня.
Модель не змінилася, але щойно змінилася цільова величина вимірювання, розподіл оцінок також явно змінився.
Тож наступного разу, коли ви оцінюватимете модель, сказати лише, що вона добре розбирається в хімії, недостатньо конкретно; вам також потрібно побачити яку саме конкретну цільову величину вимірювання та які експериментальні умови вона має перед собою.

△Прогностична продуктивність кожної моделі на 16 приватних завданнях
Ось ще одна досить неінтуїтивна річ:
Загалом кажучи, надання моделі більше часу та вищої інтенсивності міркування має спричиняти подальше зростання оцінки, чи не так?
Усі зазвичай так думають, і всі так роблять.
Але вгадайте що? Щойно з'явилися результати SPU, вони прямо дали нам ляпаса—
За тих самих 8 годин обчислень дослідницька група змінила GPT-6 Astra з середньої інтенсивності міркування на найвищу. Медіанний час виконання за найвищої інтенсивності зріс до 4,8 раза, а медіанна вартість API також зросла до 5,3 раза.
Але оцінка прогнозу... ледве зрушила з місця.
Га? Дослідницька група навіть спеціально повернулася, щоб переглянути записи запусків моделі.
І оце так, на 79 завершених завданнях GPT-6 Astra за найвищої інтенсивності міркування зазвичай уже давала відповідь до медіанних 26% часу виконання.
Модель потім теж не байдикувала; вона продовжувала обчислювати та переглядати, але це були всі дрібні коригування, які не проявилися як відмінності в результатах.
Іншими словами, вища інтенсивність міркування не обов'язково робить результати кращими.

△Витрати та продуктивність GPT-6 Astra за двох інтенсивностей міркування
Це явище також слугує нагадуванням для розподілу ресурсів моделі: якщо ви хочете додати обчислень, не кидайтеся навмання—це витрачає час, сили і може навіть не окупитися.
Натомість ви можете уважніше вивчити записи запусків, спершу повністю зрозумівши, якому саме судженню насправді відповідають новододані докази, а потім цілеспрямовано підсилити обчислювальні потужності локально.
Насправді подібне явище також з'являється у використанні інструментів.
У кожному запуску медіанна кількість категорій методів, використаних GPT-6 Astra Max, становить 4, тоді як для Medium — 1, проте між двома конфігураціями не виявлено значущої різниці в оцінках.
Причина багато в чому та сама: хороші інструменти не використовувалися там, де це було найважливіше.
Наприклад, із семплуванням Монте-Карло, хоча модель викликає цей інструмент більшість часу, він лише додає похибку до остаточного ранжування і не впливає безпосередньо на сам результат.

△Виклик інструментів наукових обчислень
Тож насправді краще використовувати інструменти точно, а не багато.
Використання GPU також дає цікавий ракурс.
Навіть за наявності достатньої обчислювальної потужності GPU лише 255 запусків фактично успішно виконали обчислення на GPU, менше однієї п'ятої.
Різні моделі та різні дисципліни відрізняються за кількістю запусків на GPU, тому просте врахування кількості викликів GPU навряд чи може вказати на дослідницьку здатність моделі.
Щоб оцінити, чи допомогла обчислювальна потужність, все ще потрібно побачити, для чого саме її використовували, чи допомогли результати обчислень із прогнозуванням і як ці результати вплинули на підсумковий рейтинг.
Ключовим залишається спрямування обчислювальної потужності на фізичні величини, що стосуються рейтингу, щоб модель могла точніше виконувати прогнозування.

△Статистика використання GPU
Якщо розглядати разом із витратами, середня вартість API за один запуск у різних конфігураціях коливається від $0,22 до $65,91, розрив становить цілих 300 разів.
Це означає, що SPU надає як прогнозну продуктивність, так і вартість викликів, що є хорошим орієнтиром для команд, які готуються розгортати дослідницькі моделі.
Від загальних оцінок до траєкторій окремих питань — SPU розкриває відмінності моделей у кожній деталі наукового судження, наприклад, в обчислювальній потужності та витратах.
Наскільки обчислені ШІ значення насправді допомагають прогнозуванню; коли прогноз виявляється помилковим, які судження слід переглянути... усе це можна додатково проаналізувати, поєднуючи результати експериментів із записами запусків.
Таким чином, наступний раунд покращення має чіткий напрямок для спроб:
Згідно з SPU, модель може швидше виявляти помилкові гіпотези та зберігати або змінювати рейтинги з більшим обґрунтуванням. Після змін її знову повертають до того самого завдання, щоб побачити, чи стали прогнози точнішими.
Перенесення «перевірки розуміння» до екзаменаційної кімнати моделі
Можна сказати, що SPU дуже узгоджується з закономірностями розвитку AI4S.
Оцінювання AI4S поступово заглиблюється в реальні експериментальні етапи, і цього року також з'являються бенчмарки, орієнтовані на виконання експериментів.
Але окрім виконання, прогнозування, як неминучий етап дослідницького процесу і найскладніший для кількісної оцінки, нарешті має вимірюваний спосіб.
Переваги відображаються у двох аспектах:
Дослідники завдяки цьому можуть аналізувати, які цілі вимірювання легше прогнозувати, які завдання відрізняються найбільше і як формується помилкове судження. Це може заощадити дорогі та цінні експериментальні ресурси й скоротити час прийняття рішень.
Для розробки моделей це також дає більш конкретний орієнтир для вдосконалення.
Зі збільшенням типів експериментів оцінювання також може відповідати на більш конкретні питання: для яких матеріалів, експериментальних умов і методів вимірювання рейтинги, надані ШІ, є надійнішими та більш вартими посилання.
Таким чином науковці можуть безперервно накопичувати прогрес навколо однотипних питань.

Насправді SPU — це лише вершина айсберга в серії оцінювань реальної роботи UniPat AI:
- ScienceVision: зосереджується на тому, як моделі отримують докази з тривимірних наукових об'єктів і відповідають на запитання;
- PaperBenchX: перетворює опубліковані дослідження на виконувані, верифіковані завдання відтворення статей;
- SaaS-Bench і EvoCode-Bench: відповідно досліджують реальні програмні процеси та розробницьку роботу, коли вимоги безперервно змінюються. ...
Ці роботи охоплюють наукові дослідження, офісну роботу та розробку програмного забезпечення, і всі вони поділяють занепокоєння щодо того, як ШІ виконує завдання після входу в конкретну роботу, і як перевіряються результати.
Це також опосередковано відображає, що UniPat AI має унікальне галузеве бачення та далекоглядне судження щодо руху ШІ до науково-дослідницької практики і навіть до реального світу.
UniPat AI також демонструє новий тип моделі співпраці ШІ:
Галузеві експерти беруть участь у відборі та перевірці завдань, партнерські лабораторії надають неопубліковані завдання, а проєктна команда організовує експерименти з різних дисциплін у єдині оцінювальні завдання.
Взявши SPU як приклад, ним керує UniPat AI, а установи членів дорадчої ради включають Стенфорд, Корнелл, Гарвард, UIC, Пекінський університет, HKUST і FutureHouse. Співпрацівники з вологих лабораторій з Yourui Saishi, Aibotaike, Deep Principle та Enhe Biology взяли участь у відповідній експериментальній роботі.
Міждисциплінарні знання та експериментальні ресурси таким чином входять в один і той самий процес оцінювання. SPU не лише несе відбір проблем, але й представляє співпрацю, необхідну для організації науково-дослідницьких проблем у виконувані завдання.
Наразі 100 публічних завдань, пов'язаних із SPU, планується випустити як повні пакети завдань Harbor; 16 приватних завдань залишаться приватними для контрольованого оцінювання. Як набір даних, так і код були відкрито опубліковані.
Варто визнати, що сьогоднішній ШІ все ще є лише новачком перед цим механізмом SPU.
Він може використовувати інструменти з блискавичною швидкістю і протягом 8 годин встановити три набори програмного забезпечення, завершити запуск DFT, а потім запустити Монте-Карло, але щодо найкритичнішого судження він ще не навчився ставити собі одне запитання: чи є величина, яку я обчислюю, саме тією величиною, яку експеримент справді потребує виміряти.
Але в міру накопичення таких завдань стане зрозуміло, яку саме науково-дослідницьку роботу ШІ здатен виконувати.
SPU виміряв цю відстань, і кожен наступний іспит є записом того, як ШІ наближається до справжнього експериментального стенду.
Ця стаття походить із публічного акаунта WeChat "Quantum位" (ID: QbitAI), автор: Focus on Frontier Technology





