Коротко
- Microsoft заявляє, що MAI Code 2 забезпечує 96% продуктивності Claude Opus 5.5 у програмуванні за 5% його вартості, хоча порівняння включає промоційні ціни.
- За оцінками Microsoft, її нова модель кібербезпеки набрала 92,3% проти 91,5% у GPT-6 Astra у тесті на виявлення вразливостей.
- MAI Image 2.7 очолила незалежний рейтинг редагування зображень, тоді як наші швидкі порівняння віддали перевагу її реалістичності, креативності та загальній якості результатів.
У вівторок на конференції Ignite Microsoft представила нову лінійку спеціалізованих ШІ-моделей, кинувши прямий виклик Anthropic і OpenAI у програмуванні, кібербезпеці та генерації зображень.
Замість того щоб намагатися створити єдиного чат-бота, який перевершує всіх у всьому, вона пропонує моделі, навчені виконувати конкретні завдання за суттєво нижчою ціною.
Найгучніша заява стосується MAI Code 2, яка, за словами Microsoft, забезпечує 96% продуктивності Claude Opus 5.5 на типових корпоративних завданнях програмування лише за 5% вартості. Також стверджується, що вона досягає 98% продуктивності GPT-6.1 Sol за 40% ціни.
Ці показники усереднюють результати чотирьох оцінювань, зосереджених на практичній розробці програмного забезпечення, включно з виправленням коду та внесенням змін до кількох файлів. Microsoft провела три з цих тестів на власній платформі оцінювання, використала зовнішні результати для четвертого та розрахувала витрати MAI Code 2 з урахуванням 50% промоційної знижки.
Полегшена модель Code 2 Flash орієнтована на рутинні виправлення та швидкі редагування, і Microsoft стверджує, що її продуктивність зіставна з Claude Haiku 5.5 за 20% ціни, тобто надзвичайно дешево без втрати якості. Обидві моделі для програмування вже доступні в GitHub Copilot, що впроваджує власну технологію Microsoft безпосередньо в продукт, який значною мірою покладався на зовнішніх постачальників ШІ.
Безпека — ще одна ціль. Microsoft заявляє, що MAI Cyber 2 Flash досягла успіху в 92,3% оцінюваних завдань з виявлення вразливостей CyberGym-E2E порівняно з 91,5% для GPT-6 Astra, за менш ніж 2% вартості на завдання. CyberGym-E2E оцінює відсоток досліджень безпеки програмного забезпечення, які ШІ успішно завершує; Microsoft виключила 92 з 905 завдань після виявлення збігів між їхнім вихідним матеріалом і своїми тренувальними даними.
Компанія ще не опублікувала прямого порівняння з обмеженою моделлю GPT-6 Cyber від OpenAI. Її система безпеки почне замінювати старішу модель MAI для відповідних клієнтів MDASH у середині грудня, розвиваючи підхід до сканування вразливостей, про який Decrypt раніше писав.
У ШІ Давид також може перемогти Голіафа
Чи може мала модель перемогти велику? Безумовно — у конкретних випадках.
Модель загального призначення має навчитися писати поезію, пояснювати фізику, налагоджувати програмне забезпечення та відповідати на запитання майже про все. Модель, налаштована для програмування чи кіберзахисту, може витрачати більше свого тренувального та обчислювального бюджету на шаблони, що мають значення для цієї роботи, замість того щоб нести ту саму широту знань у кожен запит.
Це не робить менші моделі універсально розумнішими. Це може зробити їх швидшими та економнішими, коли завдання чітко визначене, особливо в бізнесі, де та сама робота виконується тисячі разів на день.
Сканер безпеки, який аналізує кожну нову зміну коду, не потребує дорогої фронтирної моделі, щоб пояснювати історію Римської імперії. Якщо модель може присвятити всю свою потужність генерації коду Python, платити за її API-виклики матиме більше сенсу, ніж використовувати надпотужну універсальну модель.
Спеціалізація також може покращити всю систему навколо моделі: інструменти, які вона викликає, перевірки, що верифікують її відповіді, та дані, використані для її вдосконалення. OpenAI застосувала споріднений підхід зі своїми моделями Mini та Nano, дозволяючи дешевшим працівникам виконувати рутинні завдання, тоді як більші системи беруться за винятки.
Однак є компроміси. Власна документація Microsoft зазначає, що Code 2 ще не оптимізована для фундаментальних наукових досліджень чи дуже тривалих автономних завдань. А Anthropic конкурує в дешевшому сегменті ринку з Haiku, а не лише зі своїми преміальними моделями Opus, тож Microsoft входить у гонку, яку її конкуренти вже розуміють.
MAI Image — це переконливіша демонстрація
MAI Image 2.7 від Microsoft може надати найясніше підтвердження того, що її стратегія працює. У наших швидких порівняльних тестах його зображення перевершили GPT Image та Nano Banana від Google за реалістичністю, креативністю та загальною якістю.
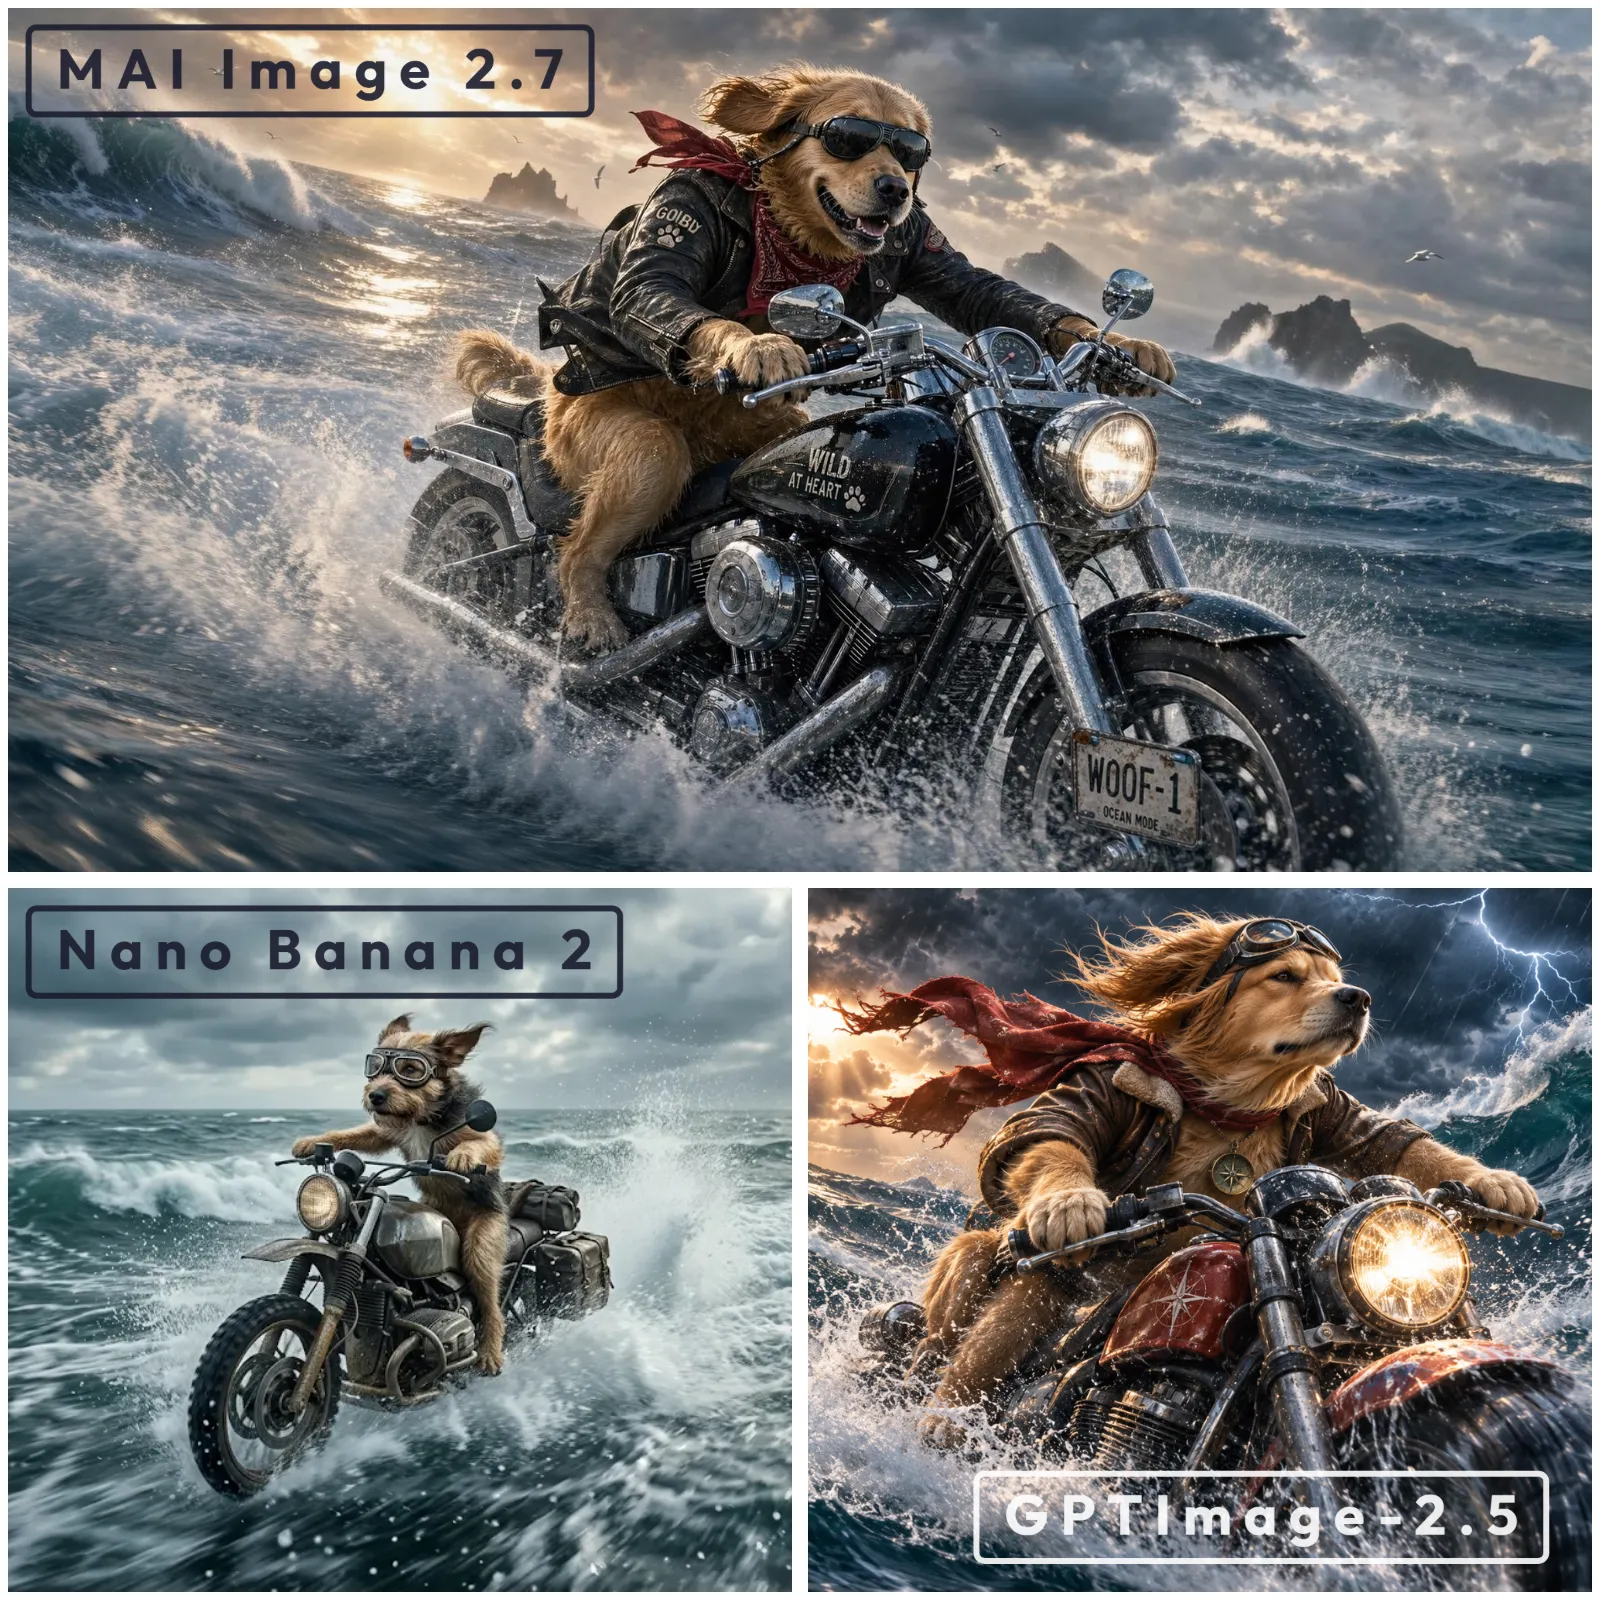
Це були лише перші враження, засновані на кількох генераціях, але вони загалом збігаються з його сильними результатами в незалежних рейтингах.
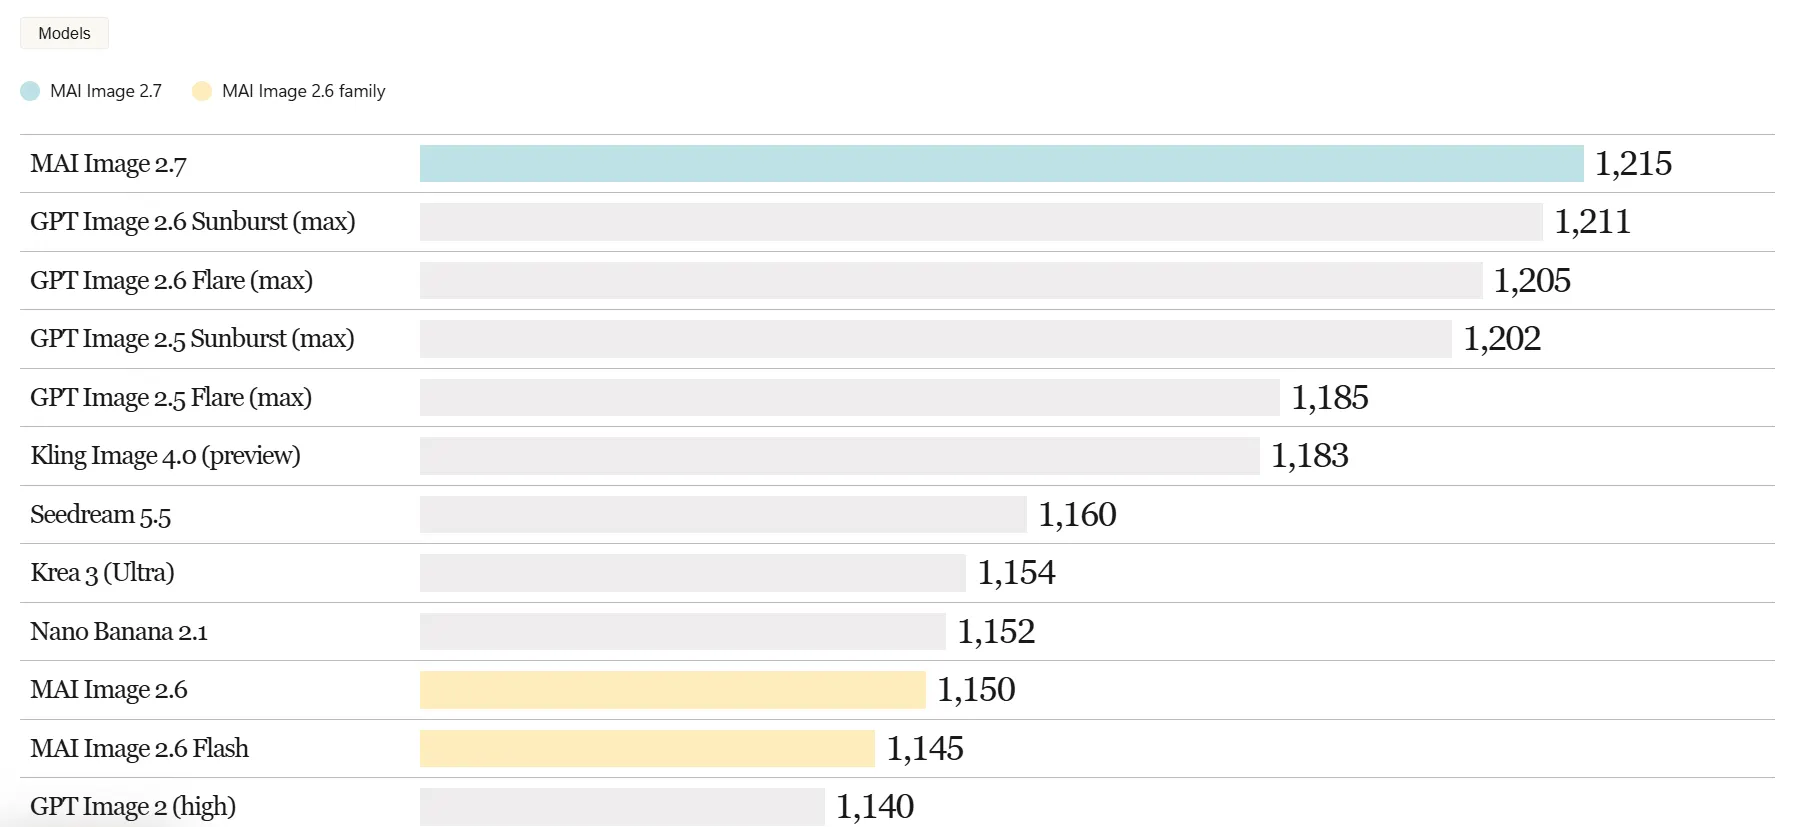
У тесті редагування зображень від Artificial Analysis, який пропонує людям обирати між анонімно згенерованими редагуваннями та перетворює ці вподобання на рейтинг Elo, MAI Image 2.7 наразі лідирує з 1 215 балами проти 1 211 у GPT Image 2.6 Sunburst.
Розрив у чотири бали є достатньо малим, щоб їхні заявлені діапазони невизначеності перекривалися; окремий рейтинг генерації зображень за текстом, оцінений за допомогою того самого методу на основі вподобань, ставить Microsoft на четверте місце.
Ціноутворення важче ігнорувати. Microsoft вказує близько $35 за 1000 зображень для MAI Image 2.7 і $10 для його версії Flash, порівняно з приблизно $211 для GPT Image 2.6 Sunburst максимальної якості в порівнянні Artificial Analysis. Google Nano Banana 2.1 там коштує близько $34 за 1000, тоді як Nano Banana Pro — близько $134; фактичні рахунки залежать від постачальника, роздільної здатності та налаштувань.
Наше попереднє тестування MAI Image 2 виявило чудовий реалізм, але дратівливі обмеження щодо редагування та форматів виводу. Новіша версія додає інтерактивне редагування через робочий простір Canvas від Microsoft, прозорі фони та ширший доступ через Foundry, хоча якість зображення та придатний до використання продукт — це все ще дві різні речі. Тим не менш, модель також досить цензурована.