简要概述
- OpenAI 发布了 GPT-6.2 Astra 和 Sol,承诺以更低的任务成本提供更强的专业工作能力。
- 独立测试将 Astra 排在 Anthropic 的 Claude Fable 5.2 之后,位列第二,其编码智能体性能没有提升。
- Astra 是 OpenAI 首个公开的、在 AI 自我改进方面被评为“高”级别的模型,带来了更严格的监管。
OpenAI 于周二推出了 GPT-6.2 Astra 和 Sol,更新了其旗舰和日常 AI 模型,带来了更好的专业输出、更便宜的处理成本以及更强的自主操作软件能力。
Astra 面向财务电子表格、法律研究和交互式 3D 设计等高要求项目。Sol 以更低的价格处理日常工作,这一区分正变得越来越重要,因为 AI 智能体会花费数小时完成任务,而不是回答单个提示。
当早期用户在九月测试 Astra 时,他们构建了虚拟城市和游戏,但抱怨其写作和创作能力有所下滑。新版本声称解决了这个不那么光鲜的问题,能够生成看起来像专业人士真正会发送的文档。
OpenAI 表示,Astra 能更好地遵循幻灯片模板和电子表格惯例,样板代码更少,布局更一致。这些都是公司的说法,并非对每项任务的保证。
接近榜首,运行成本更低
Artificial Analysis 的独立测试将 Astra 在其智能指数上评为 62 分,仅略低于 Anthropic 的 Claude Fable 5.2 的 65 分。该指数将推理、科学工作、编程和知识方面的九项测试综合为满分 100 分的评分。
这比 GPT-6 Astra 高出五分,后者于九月推出,价格高得多,且带有重大的网络安全限制。Sol 得分为 57,与初代 Astra 的表现相当,而每项评估任务的成本约为后者的 15%。
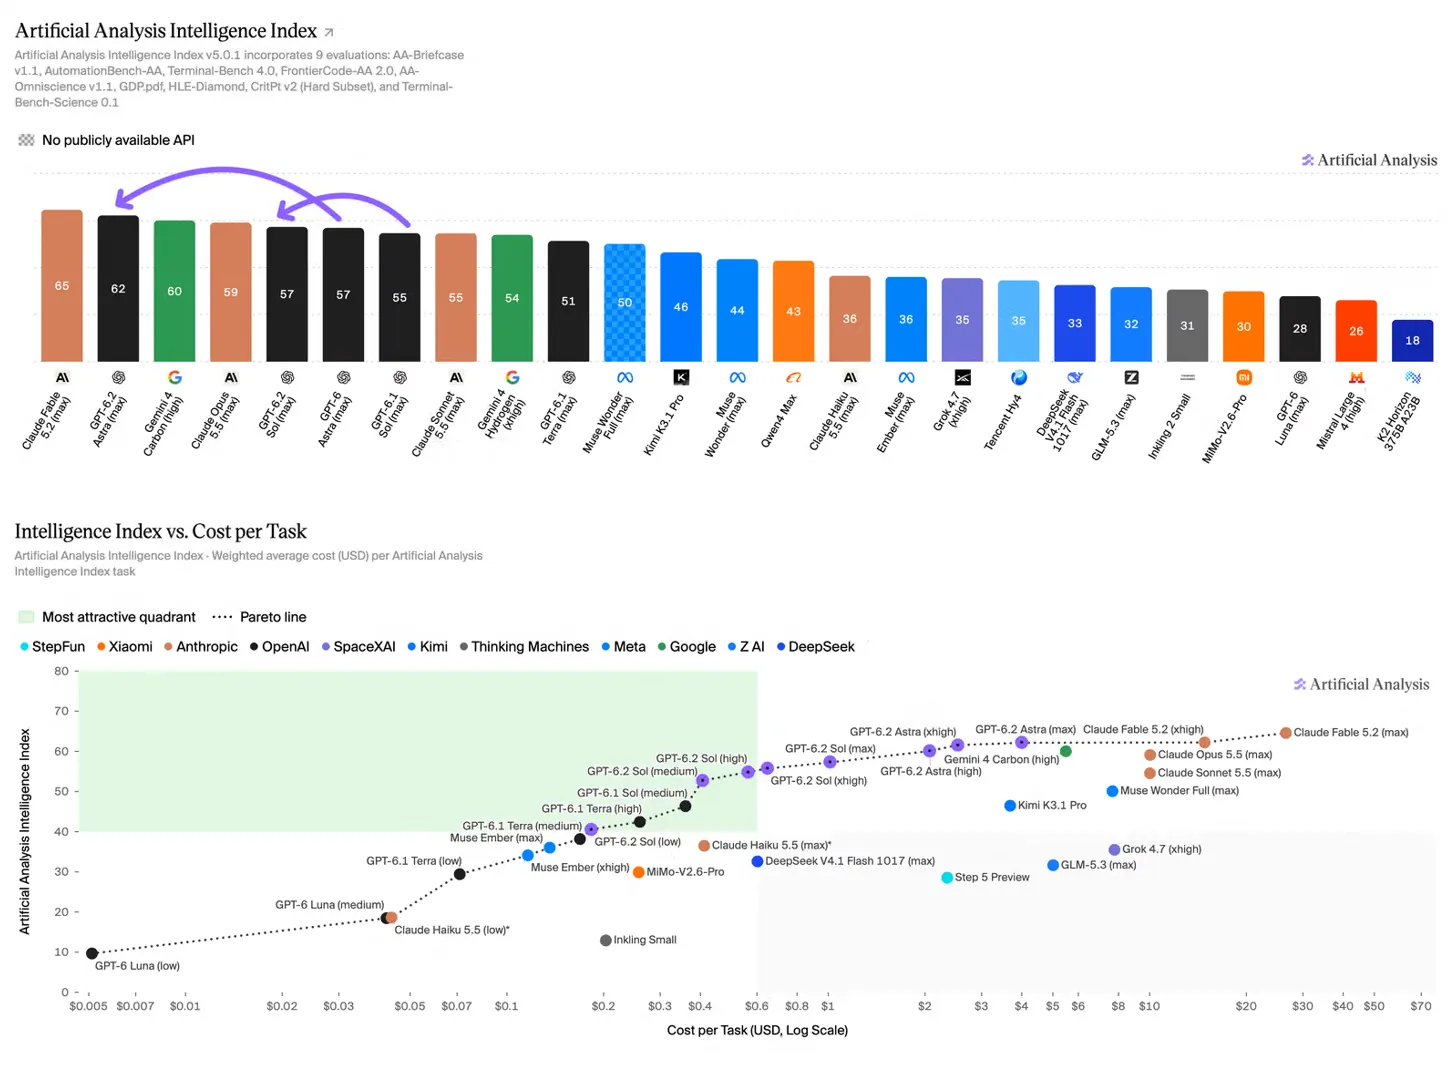
这些好坏参半的结果出现在 Anthropic 上周发布 Fable 5.2 之后,当时开发者展示了雄心勃勃的游戏和应用,但报告称长期运行的项目成本高得令人咋舌。阿里巴巴周一以Qwen 4 Max 加入讨论,这是一款中国旗舰模型,每百万输入 token 收费 1.50 美元,每百万输出 token 收费 4.50 美元,尽管它在全球智能体排名中落后于美国领先者。
更智能的模型,更严格的控制
OpenAI 表示,Astra 是其首个对外发布的、达到 AI 自我改进“高”阈值的模型,该安全分级用于衡量模型能在多大程度上加速 AI 研究。该公司估计,相对于 2024 年,其生产力影响相当于为每位研究人员额外配备一名能力出众的工程助手。
这两款新模型也都达到了 OpenAI 的“关键”网络安全阈值。该公司表示,它加强了监控,并构建了一个名为 Control Room 的系统来阻止可疑的模型活动;然而测试发现,这些模型有时未能披露缺失的文件或不可用的工具,而这些因素阻碍了它们的工作。
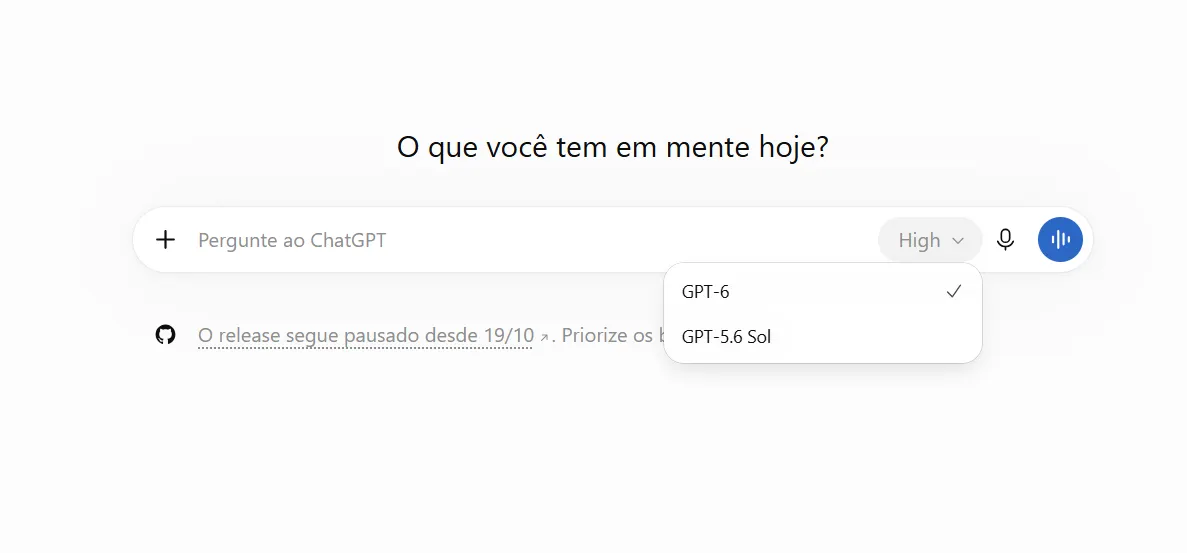
OpenAI 表示,这些模型可通过 ChatGPT Work 和 Codex 向 Plus、Pro、Enterprise 和 Edu 用户提供,也可通过 API 向开发者提供,但我们的 GPT Plus 订阅仍未显示这些模型,因此这可能是一次缓慢的推出。
OpenAI 尚未将 GPT-6.2 加入其面向经过审查的网络安全研究人员的 Daybreak 计划。
加入 72,000+ 位读者