
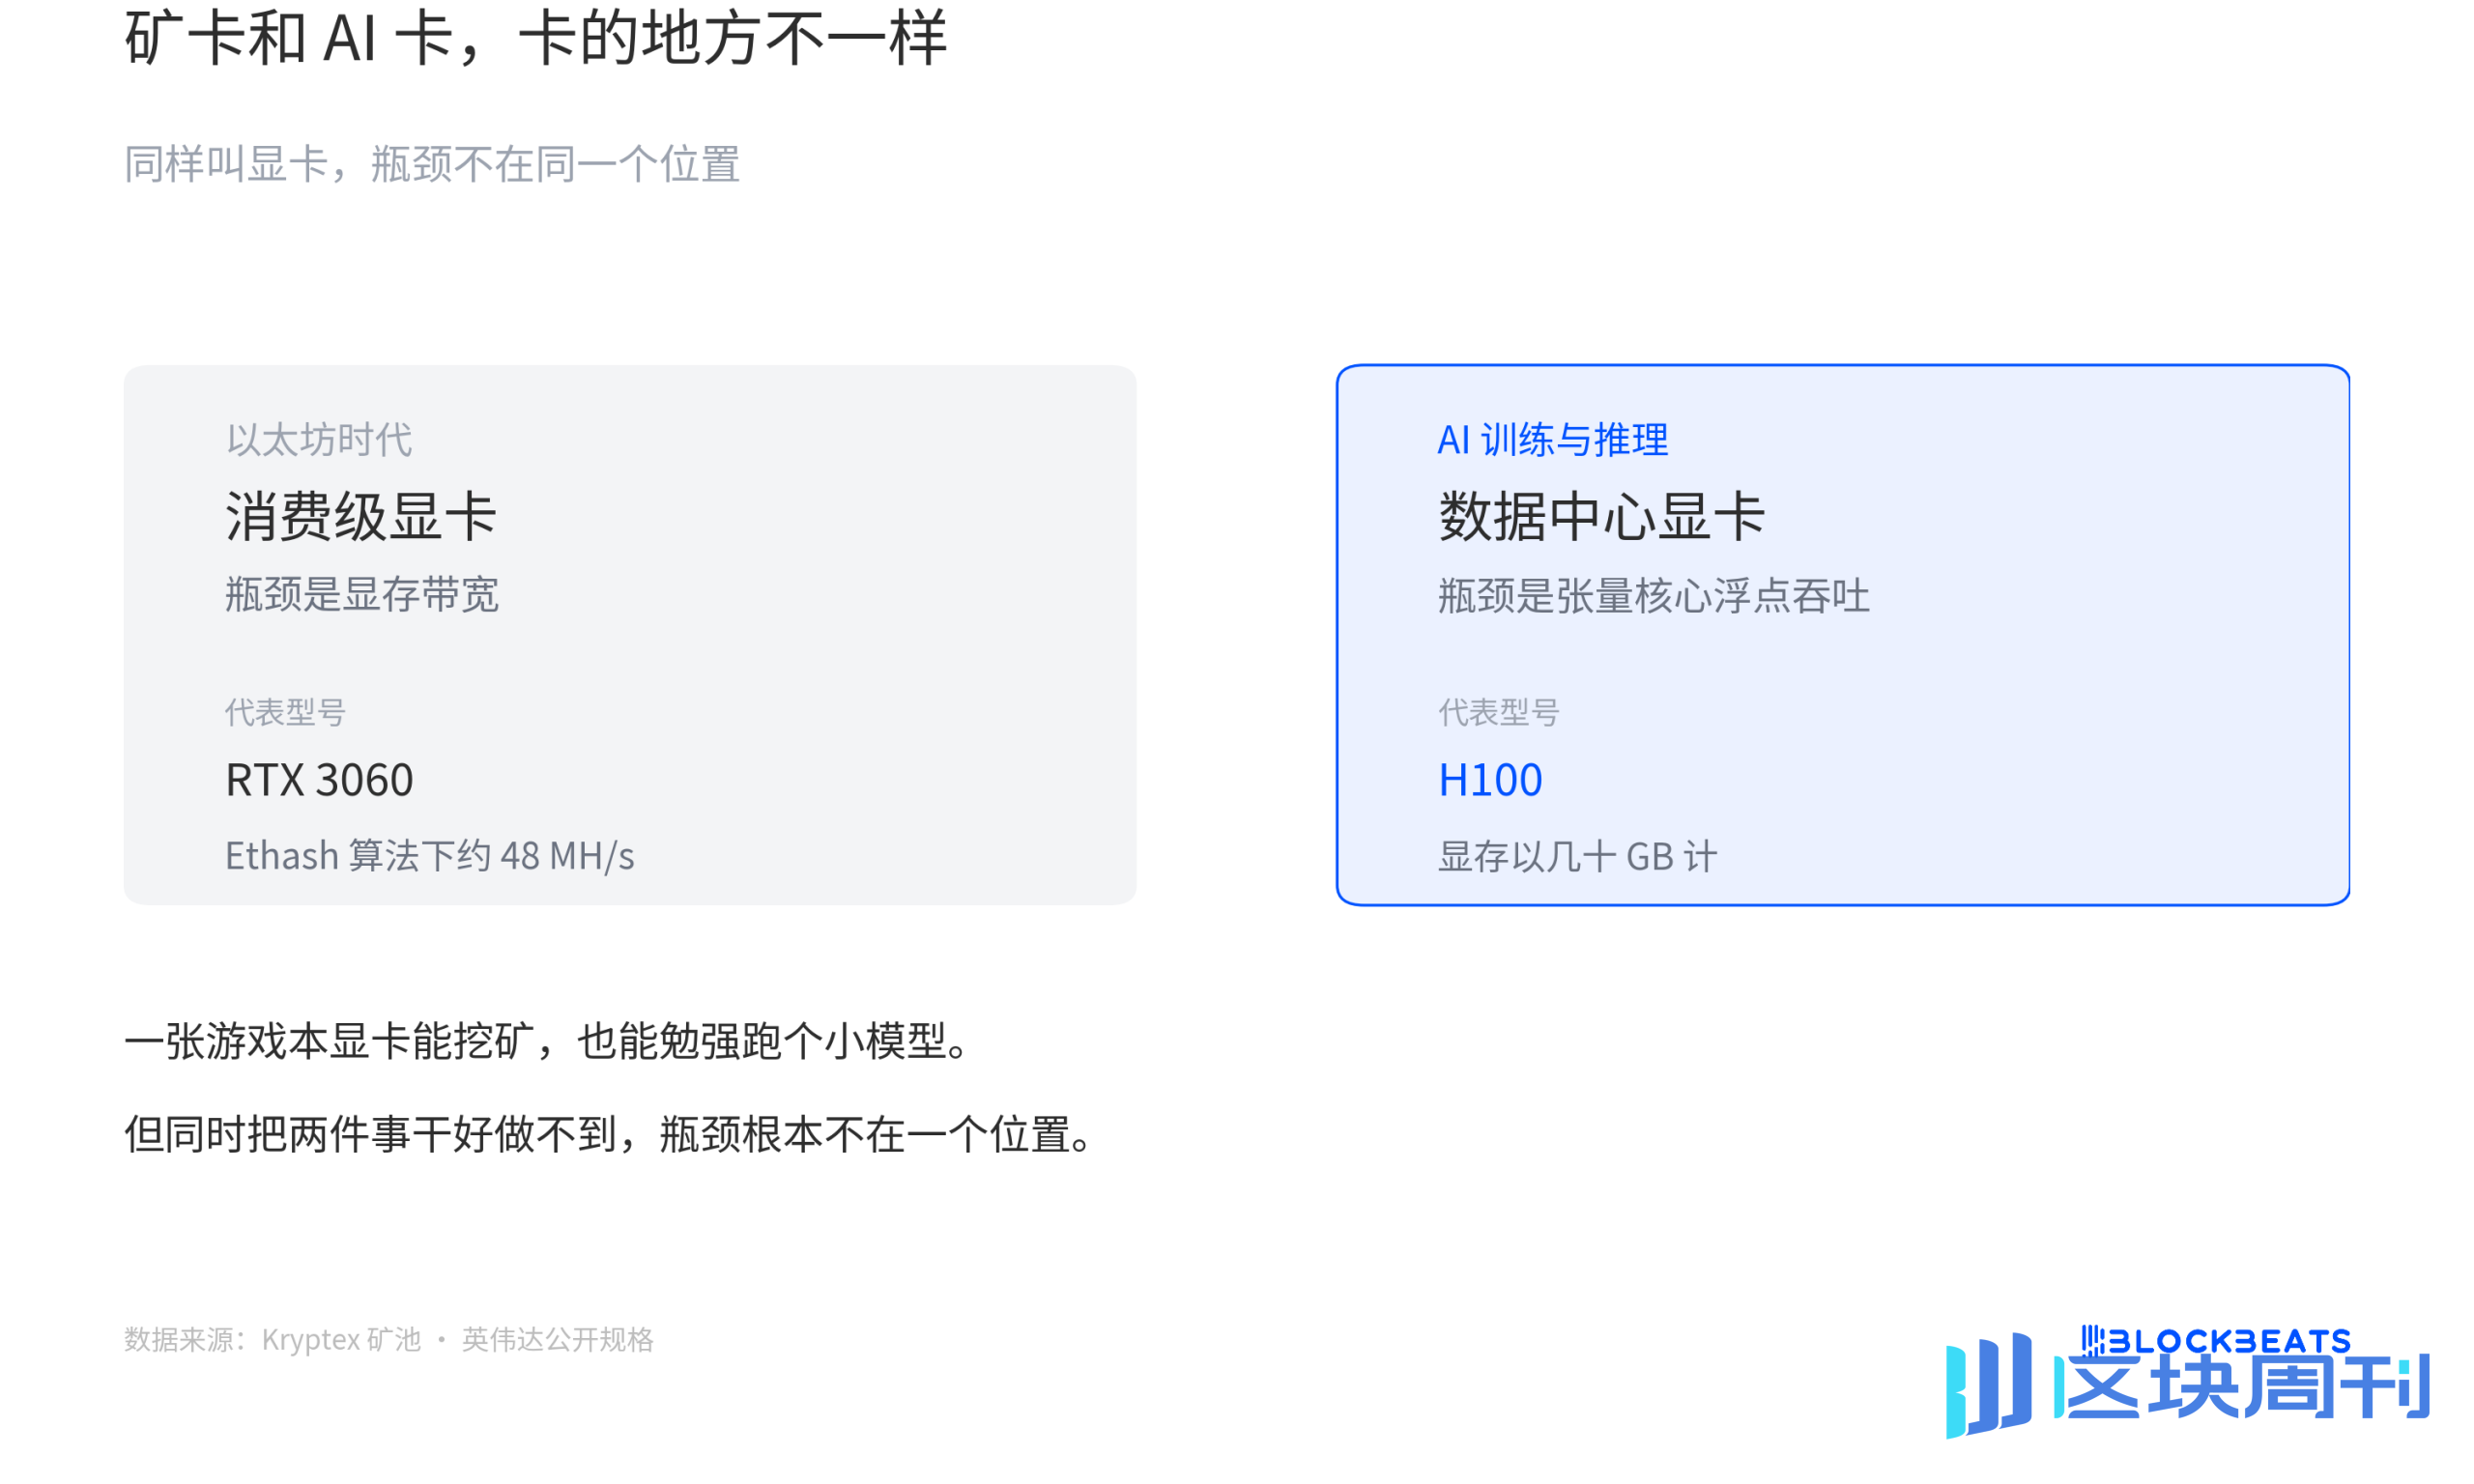
以太坊還是 POW 的那幾年,礦工用的就是消費級顯卡,演算法叫 Ethash。一張 RTX 3060 在 Ethash 上大約 48 MH/s。當時確實有人就想过,既然挖礦和 AI 都靠顯卡,能不能讓同一張卡一邊挖一邊算模型。
這個想法沒成,因為兩件事卡的地方不一樣。Ethash 吃顯存頻寬,算的是固定難度的哈希。AI 要的是張量核心的浮點吞吐和幾十 GB 顯存,主力是 H100 這類資料中心卡。一台遊戲本上的顯卡能挖礦,也能勉強跑個小模型,但同時幹好兩件事做不到。
Vitalik Buterin 在 2019 年給這件事下過一個判斷,原話是如果能找到某種既有用又容易驗證的計算,加密貨幣挖礦會成為社會的一筆巨大財富,但這大概是做不到的。
Pearl 聲稱它做到了。Vitalik 幾年前的判斷,被 Pearl 官網掛在顯眼的位置。
Pearl 是一條獨立的工作量證明公鏈,代幣叫 PRL。礦工不反覆算哈希,改做矩陣乘法,也就是神經網路每一層都在做的那種乘加。設計上,同一份 GPU 計算既出塊發幣,又產出可驗證的 AI 計算。
官方對這件事有個說法,叫「能量、數據、貨幣在一次操作裡」。比特幣把能量和貨幣綁在一起,AI 把能量和數據綁在一起,貨幣化把數據和錢綁在一起。三樣東西以前兩兩相遇,Pearl 想在一次矩陣乘法裡讓三者同時發生。
PoW 這條線安靜了很久。上一批能讓人坐下來認真討論的新公鏈基本交卷在幾年前,之後的熱鬧都在 L2、模組化和再質押那邊,一條新 PoW 鏈本身就少見,現在流通市值 4.3 億美金的 PRL,想講一件什麼事?
它想解決什麼問題
比特幣的工作證明有個特點,礦工算的東西和現實世界沒有任何關係。同樣一度電,拿去跑模型能出 token、能出圖、能幹活,很多人覺得拿去挖礦有點浪費。
真正的難點不在「有用」,在無許可。無許可的意思是,誰都能來挖,不用報名,也沒有人審核資格。比特幣的安全模型就建立在這一點上,不管你算的是什麼,成本都一樣。一旦工作量換成有現實價值的東西,礦工就有動機偷工,或者挑一種便宜的輸入。所以問題不是能不能讓挖礦有用,而是能不能讓它有用,同時誰也偷不了工。
Pearl 自己的說法是,把比特幣的隨機哈希換成矩陣乘法,讓 GPU 把工作證明當成 AI 負載的副產品來做。白皮書裡直接用了「2-for-1」這個詞。翻成大白話,以前一批 GPU 只有兩個去處,要麼挖礦一邊燒電一邊出幣,要麼跑模型一邊燒電一邊出 token,Pearl 想把這兩個去處合成一個。
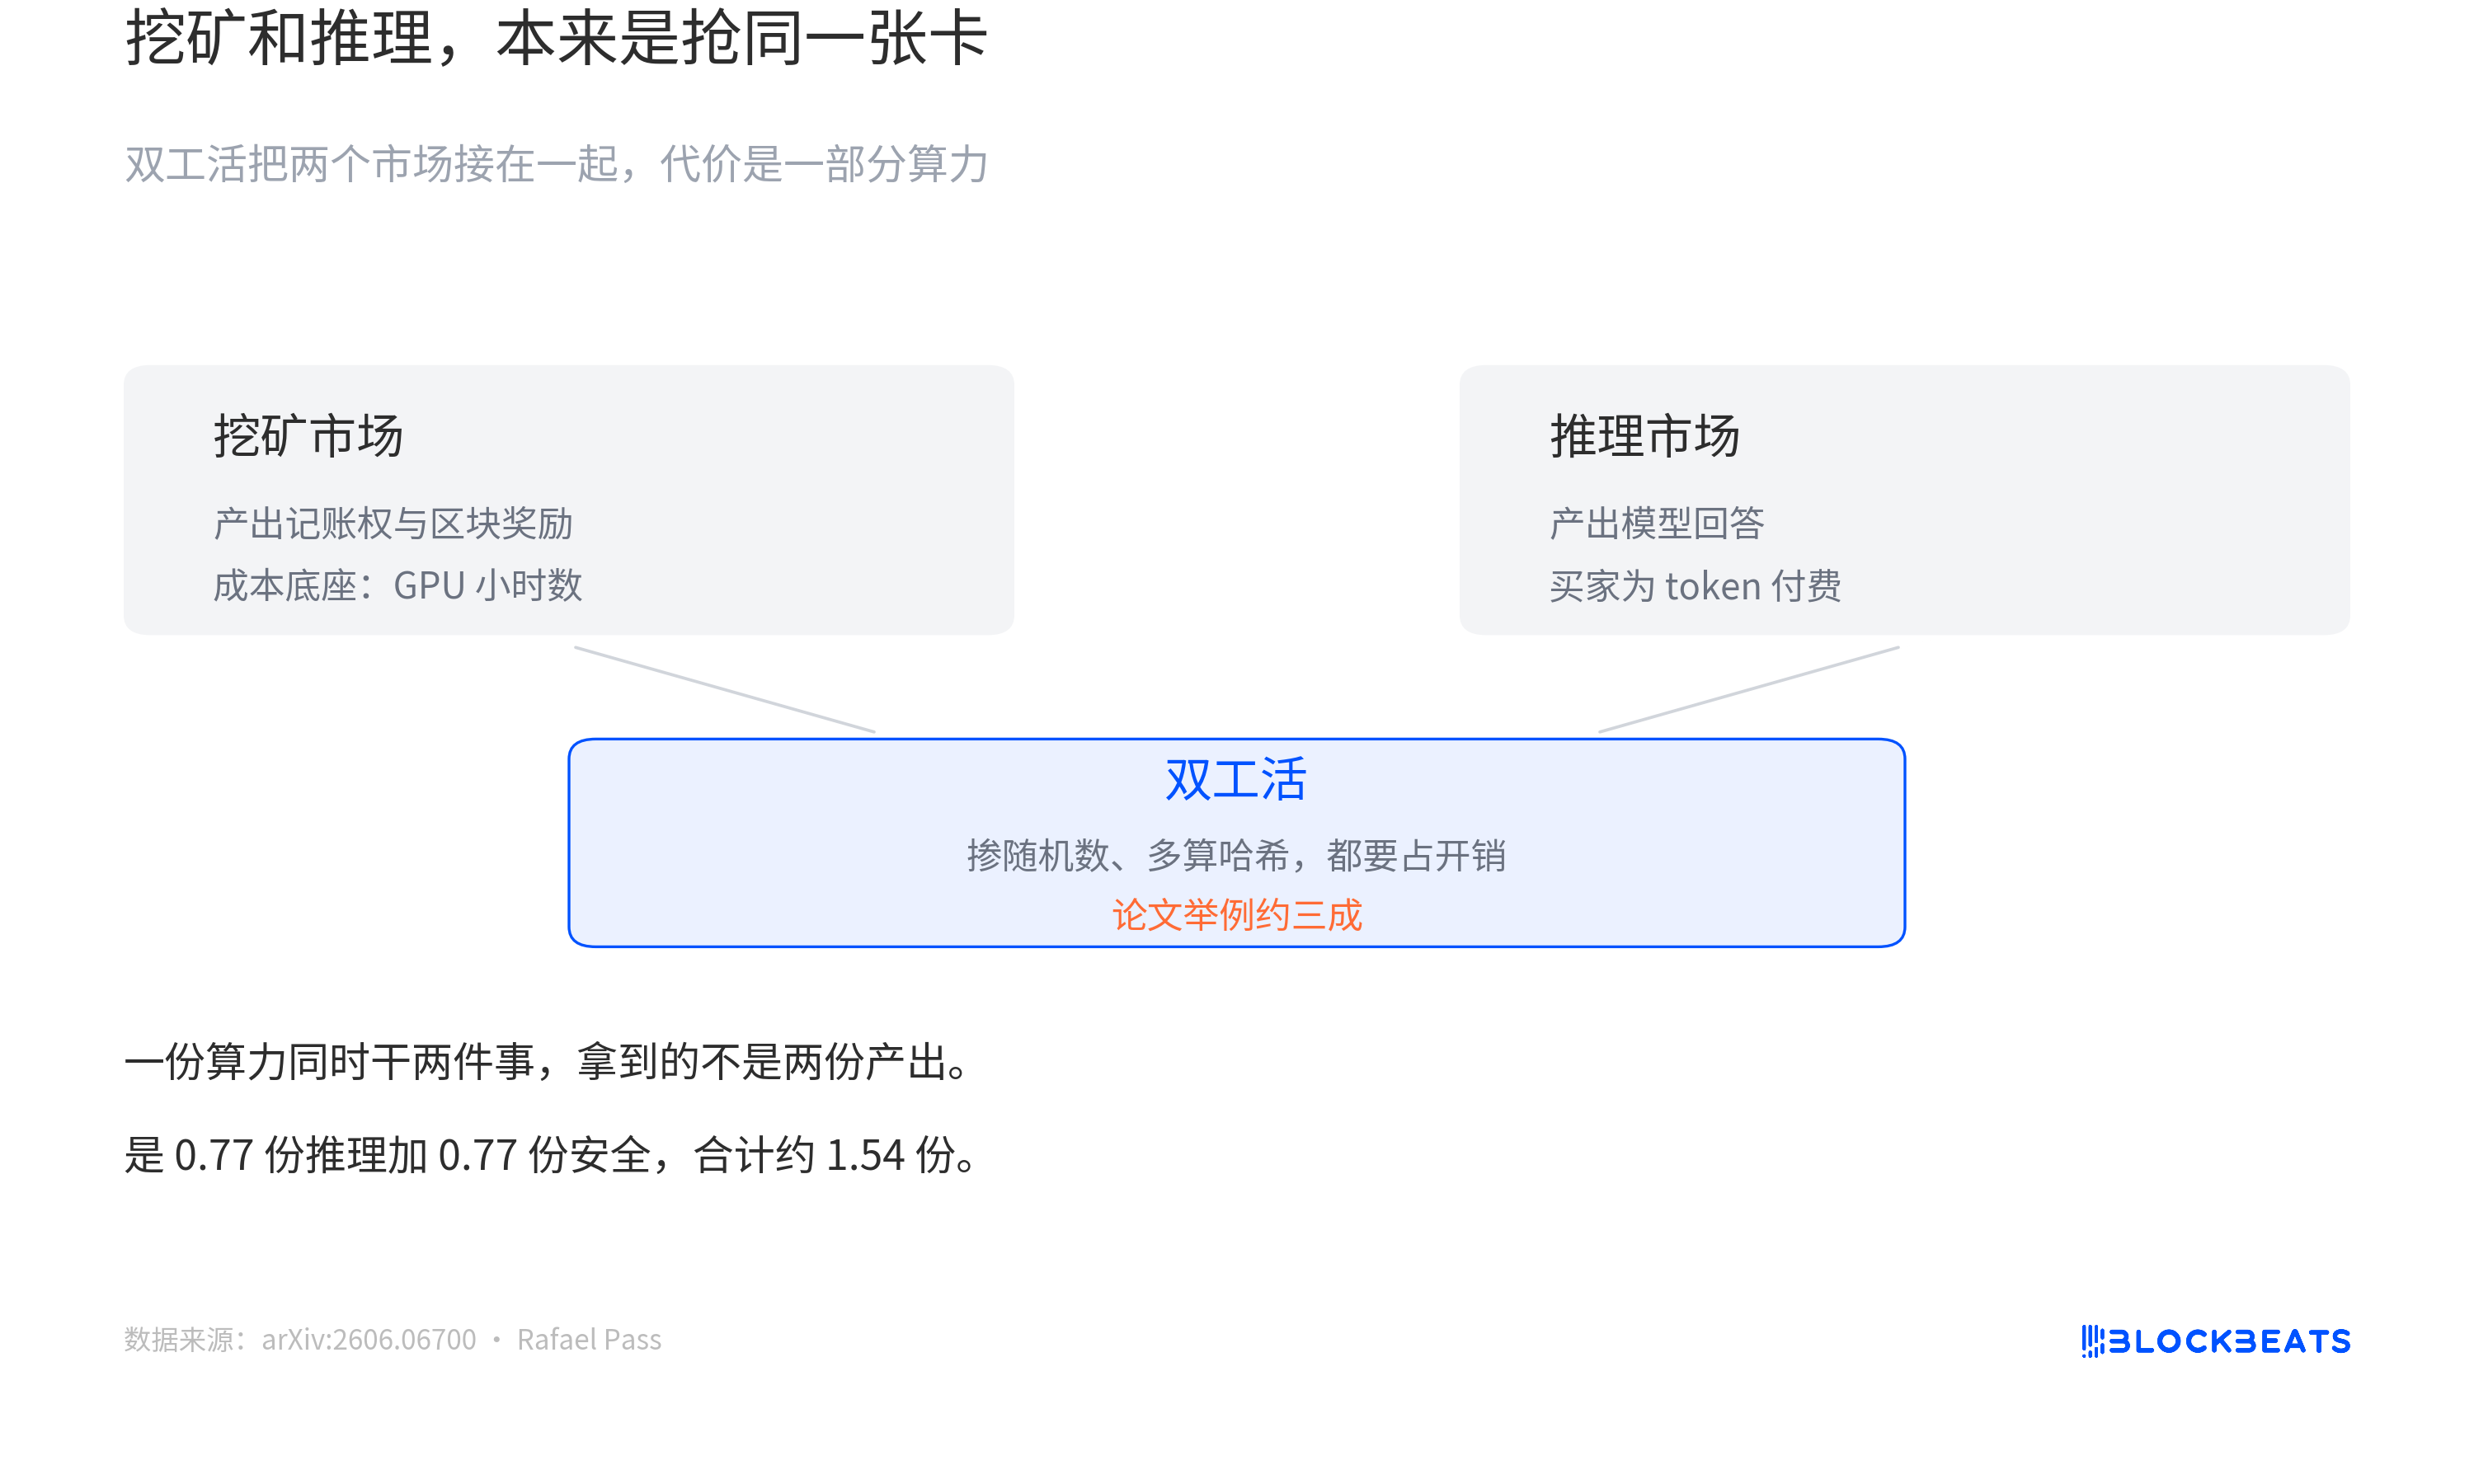
這個想法有人算細過。密碼學研究者 Rafael Pass 的論文《The Economics of Proof-of-Useful-Work》把機器的活分成三種,純挖礦、純推理,還有同時產出兩者的雙工活。雙工不免費,論文舉例說一份算力同時幹兩件事,拿到的不是兩份產出,是一份半左右。開銷夠小、代幣被市場接受的規模夠大,區塊獎勵就相當於給推理價格打了返點,把原本不會有人做的推理算力拉進來。這套推演在數學上挑不出毛病,麻煩在於它的三個變數,開銷、幣價、推理需求,沒有一個是 Pearl 能自己決定的。論文腳註披露,作者是在為 Pearl Research Labs 提供諮詢期間完成這項工作的。
Pearl的運轉邏輯
要說清這套東西怎麼轉,得先把矩陣乘法這個詞拆開。它不是 Pearl 造出來的,是一道很老的運算,神經網路裡幾乎每一層都在用它。
一張矩陣就是一張按行列排好的數字表格。兩張表能相乘,條件是前一張的列數等於後一張的行數。結果表的每個格子,是前一張的一行和後一張的一列,一個對一個乘起來再全部加總。舉個最小的例子,A 的第一行是 1 和 2,B 的第一列是 5 和 7,結果表左上角就是 1 乘 5 加 2 乘 7,等於 19。剩下的格子照這個規矩一個個填。
AI 模型裡,一層運算可以寫成「輸入乘權重」。用戶的一句話被切成向量,和這一層的權重表相乘,得到結果,再過一道非線性函數,交給下一層。模型越大表格越大,一次乘加的次數動輒上萬億。GPU 就是為這種整齊的乘加造的,這也是為什麼挖礦卡和 AI 卡是同一類晶片。
理想情況下,事情是這樣的。有個人網上問聊天機器人一個問題,伺服器上的顯卡開始跑模型,一層一層做矩陣乘法。如果這台機器裝的是 Pearl 的插件、跑的是它認證過的開源模型,那麼這些乘法在出回答的同時,還會被拿去碰運氣。每算完一小塊就揉一次指紋,指紋夠小就中一張彩票,中了拿區塊獎勵。用戶那邊看不出區別,回答照拿,價格甚至可能便宜一點。同一批乘加,一邊變成 token,一邊變成幣。

這套東西要成立,得先解決偷工。礦工手上就是兩張表格,他要先把表格揉成一個指紋交上去。所謂揉指紋,就是拿這張表裡的所有數字一起算一次哈希,壓成很短的一小段。鏈上看過這個指紋,才會告訴他要往表格裡摻什麼隨機數,順序卡死,他想改表格也來不及。官方管這個動作叫加噪聲,說白一點,就是往兩張表格裡摻進一堆隨機數字,摻多少、摻在哪,由那個指紋決定,礦工自己挑不了。
不摻的話有捷徑可走。乾淨的 A 乘 B,和摻過隨機數的乘積之間,只差三個修正項,這三項數量級不小,算起來卻很便宜。礦工手上本來就有乾淨的 A 和 B,他完全可以先把乾淨答案算好,再加這幾個便宜的修正項湊出摻過隨機數的答案,那道大乘法根本不用做。好比考試題目是 3987 乘 2913,學生早就背過答案,拿幾個小數字湊一湊,看著像認真算過。
所以協議不要求礦工交出算好的結果,只要求他交出用到的那幾行輸入,加上一份證明。檢查的人把這部分拿出來,摻上同樣的隨機數,只重算這一小塊,看指紋對不對。重算一小塊很便宜,足夠確認他沒偷工。如果這些表格涉及公司權重或用戶數據,還可以再加一層零知識證明,證明確實算過,但不透露用的是哪兩張表。

現在跑到哪一步了
去 Hugging Face 看,pearl-ai 這個組織下面有四個認證模型,Llama 3.3 70B、Llama 3.1 8B、Qwen3 30B 和 Gemma 4 31B。官方管它們叫「認證變體」,做法不是重新訓練,是把同一批權重按 Pearl 的量化格式重新壓一遍,讓它能在插件裡一邊推理一邊挖礦。精度損失很小,Gemma 4 31B 的 MMLU 從 90.93 降到 90.56。截至 2026 年 10 月 9 日,這四個模型近三十天的下載量從 195 到 6424 不等,點讚數分別是 0、3、5、6。
商業出口也有一條。2026 年 5 月,Pearl 和 Together AI 合作上了一個跑 Gemma 模型的接口,據 Together 的公告,調用價比普通接口便宜 25%,差價由代幣的未來價值抵扣。
模型掛出來了,代碼也開源了,然後就沒有然後了。2026 年 6 月,研究者 Abhinaba Basu 的《The Usefulness Gap in Proof-of-Useful-Work》測了這件事。據當時全網算力約 24 EH/s,相當於約 32 萬張 RTX 3090 級別的卡,估計耗電 112 兆瓦,而有用的人工智慧計算產出是零。
作者抽查了 8012 個礦工工作單元,硬體全都具備推理能力,但主力礦機軟體裡,矩陣乘法相關的字串有 4803 條,機器學習框架相關的有 0 條。他還自己寫了個礦工程序,用隨機數字填表格,在輝達、AMD、CPU、蘋果晶片上都跑通了,拿到礦池認可的份額,一共 44 個。一個人提供數據、讓模型算出結果,和用同一張卡挖幣,在設計裡可以合一,在實際運行裡是分開的。
那網路上實際在跑的是什麼。據礦池 Kryptex 的頁面,全網算力已經漲到 46.37 EH/s,難度 2.26 TH,出塊約 203 秒,每塊獎勵 2271.03 PRL,每天產出約 96.6 萬枚,幣價約 1.30 美元。六個月裡算力幾乎翻了一倍,漲上來的這部分,絕大多數還是在填隨機數字。市面上現在做的,主要就是這麼一件事,買卡、插上、填隨機數、等結算。
有什麼問題
我們想像一下,食堂貼出告示,誰切夠一百斤菜,誰就能領一份工資。切菜這件事本身是真的,刀工、力氣、時間都得花。但告示只檢查你有沒有切夠一百斤,不檢查你切的是什麼菜。於有人拉來一車爛菜葉,切夠一百斤,領走工資。他確實切了菜,力氣也真的花了,只是廚房用不上這堆葉子。
Pearl 現在就卡在這裡。協議檢查的是表格的指紋對不對得上、結果是不是真等於兩張表相乘、工作量夠不夠難度,正式設計裡還有一層統計閘門,專門擋一眼能看出做過手腳的輸入。這些它都查。它沒有查的是,這兩張表格是從哪來的。所以礦工完全可以自己造兩張隨機數字的表格,乘法一樣難,指紋一樣達標,一樣能中獎,只是算出來的結果沒有人要用。協議只認乘法關係,不認語義,「有用」在這裡是商業問題,不是密碼學保證。
這不是猜的。據前面那篇報告,被抽到的那批機器全都跑得動模型,礦機軟體裡卻一行推理代碼都沒有,作者自己用隨機數字填的表格也拿到了礦池認可的份額。目前全網算力在 45 EH/s 上下,絕大多數還是在填隨機數字。
規模上的落差也可以這麼看。論文給過一個反事實,如果這套設計真像宣傳那樣運轉,當時那張 24 EH/s 的網每天本應產出約 770 萬 GPU 小時的有用人工智慧算力。論文還提了一個指標叫價值毀滅比,Pearl 實測是 1.0,和比特幣持平,而 Filecoin 約為 0.64。
礦工不接推理訂單,不是不懂,是算過賬。論文估計,把推理引擎和挖礦耦合在一起,會損失大約 10% 到 30% 的有效算力。也就是說,接真實推理不光要改軟體、遷就請求的節奏,還得先賠掉這部分算力。幣價不高的年份,這筆賬很容易算成負的。
那這事有可能怎麼解。論文列了幾條路。一條是把表格的來源管起來,讓礦工必須用外面客戶交過來的表格。Pearl 官方現在做的插件和認證模型就是往這個方向走,把模型和插件遞到礦工手上,你用真實模型跑推理,那份乘法順手就把礦挖了。難處在於它是自願的,接不接還是礦工自己算經濟賬。
另一條是檢查表格長得像不像真的。真實模型的權重和隨手填的隨機數在統計特徵上有差別。但論文自己把這條路否掉了,礦工只要把分佈調一調就能騙過檢查,成本幾乎為零。還有幾條更遠的路都還沒落地。把模型來源做成能驗證的簽名,得先有模型方的公鑰體系。用可信硬體證明數據出處,要額外信任晶片廠商,還會拖慢速度。在獎勵上做區分,用真實數據的給得多一點,這需要先有一批真願意付錢的客戶。
Pearl 的開發方是 Pearl Research Labs。Omri Weinstein 是聯合創始人兼 CEO,這個頭銜出自 Together AI 的合作公告。他是複雜性理論方向的研究者,希伯來大學有教職,也是那篇奠基論文的作者之一。
另一位作者 Ilan Komargodski 也在 Hugging Face 的組織成員名單裡,具體身份是員工還是顧問沒有公開來源可證。能對上號的還有 Erez Badash,講 GPU 逐位復現的 Hawkeye 論文一作。
Bittensor 讓驗證者給礦工提交的模型輸出打分,分數由一套叫 Yuma 的共識決定。io 是按需把 GPU 租給機器學習任務。Pearl 押的是一個更窄的假設,出塊用的那道乘法本身可以有人要。
它賭的是推理需求會大到吃掉出塊算力。到了那個程度,礦工自己會算清楚,接真實訂單比填隨機數字划算。吃不到,它就是一條換了數學的顯卡礦鏈,算出來的東西和人工智慧同源,和任何一個具體用戶的期待無關。