
不ber,現在的基準測試都進化到醬嬸了???
這回不刷題了,就直接給AI一組實驗條件,讓它自己研究、提前猜真實濕實驗的結果……
比如,同一個反應換幾種條件,哪種能得到更多目標產物?一批抗體變體,哪個表達量更高?
答案先藏好,等AI交卷,再拿實測結果對一對。
你還別說,這事兒現在真值得一測。
這兩年,AI for Science的方式越來越深入,AI已經能自主查文獻、用軟體,為完成一項分析任務連續做上幾小時也不在話下。
大家自然而然開始進入下一個階段:我們到底希望AI具備怎樣的科研能力?
濕實驗結果預測,就是其中頗有實際價值的一項。
它需要AI理解實驗目標,並從已有知識中挖掘出相關機制,才能更好地幫助研究人員篩選值得進一步探索的研究方向。
UniPat AI牽頭推出的新基準Science Prediction Universe(簡稱SPU),便敏銳地察覺到這一點。
116個任務,4207個濕實驗,覆蓋化學、材料科學、生物和醫學,基準顧問與濕實驗合作成員也來自史丹佛、康乃爾、哈佛等高校,以及業內前沿科研機構和生物技術公司。
模型踐行每次工作8小時制,配有一塊H20,然後自主決定怎樣利用檢索與計算資源形成實驗預測。
結果出乎所有人意料。
即使強如Opus 5.5、GPT-6 Astra,數據上距離真正能實現預測還都很遙遠。。。
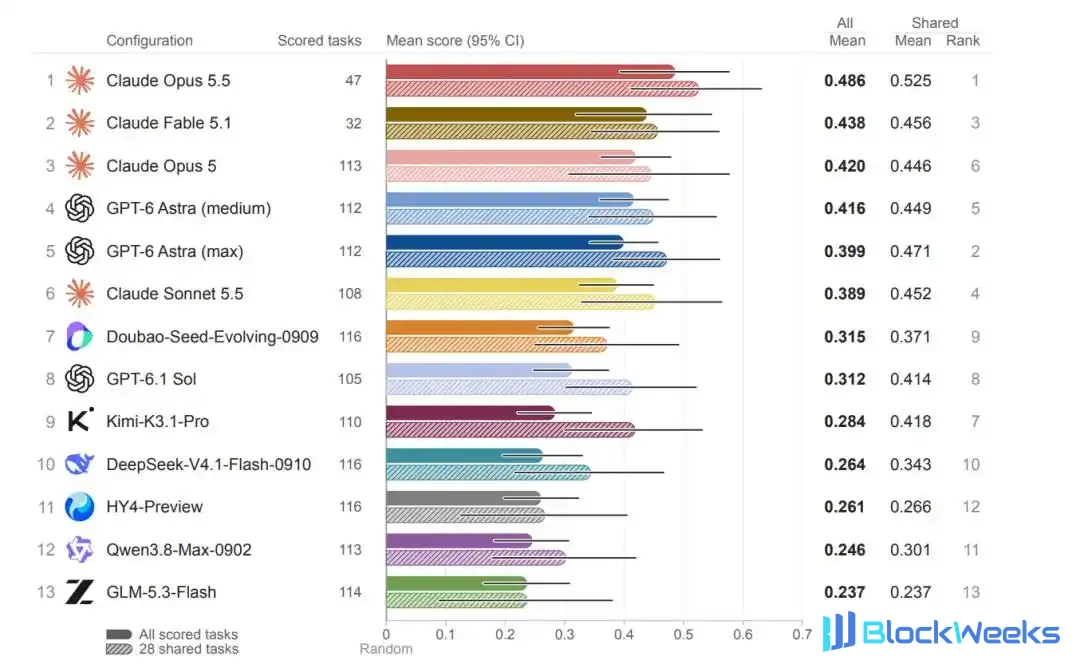
△各配置在全部已評分任務上的平均得分
不得不說,SPU這是給所有科研模型都上了道硬菜。
從前那些看不見摸不著的科研能力,如今都變成了可以統一評估、持續研究的數值。
至於AI的科研判斷怎樣一步步養成,就有了更為具體的討論依據。
濕實驗預測:值得單獨為模型考一次
回到濕實驗預測上,首先這的確不是一道新題。
科學史上有過很多這樣的時刻,一個判斷在實驗之前被給出,然後交給過程去裁決,對了就留下,錯了就推翻。
具體的判斷邏輯就構成了科學家的品味。
品味夠好、直覺夠準,科學家就能更快拿到大結果,同時節省寶貴的實驗資源。
畢竟光一次濕實驗,做化學的要配試劑、設定反應條件,再分離產物;做生物的也要經過漫長的蛋白表達……時間成本、工具費用本身就價格不菲,結果不理想還得反反覆覆做好幾輪。
所以在動手之前先預測,是科研流程裡含金量最高的一步。

只不過區別在於,過去這件事純靠科學家自己,現在到了AI時代,模型也需要有這項能力,並且還需要一張能為之打分的試卷。
現有的基準還無法完全覆蓋,比如BrainBench讓模型直接判斷實驗結果,ScienceAgentBench側重在已有數據上完成分析,Terminal-Bench 4.0和Long-Horizon-TB這類長程任務基準,則主要用預設測試檢查任務產物。
SPU與之相比,均有所不同。
它更強調把AI自主研究過程與濕實驗結果預測放在一起考,既涉及預測效果,也考驗科學工具使用和長程任務執行的能力。

△圖表由AI生成
這種判斷也被SPU組織成了明確的任務。
100個公開任務分別取自85篇近期發表的論文,領域專家從研究中整理候選項、材料、條件與測量方式,保留完整的定量結果作為評分依據。
另外16個私有任務,來自四組未發表的合作濕實驗,涉及VHH奈米抗體、反應條件、電解液和Magrolimab變體。
共計32個子領域、4207個實驗,其中公開研究提供了跨學科的任務來源,實測結果對模型隱藏,未發表實驗則增加了獨立於公開論文答案的檢驗。
這在一定程度上可以避免模型提前見過題目。

△SPU的任務覆蓋與來源
題目的篩選過程也很有講究。
專家優先選擇測量完整、條件清楚的研究,那些沿著單一趨勢就能排序的簡單問題會被直接剔除,數值過於接近的問題也會被視作參考意義不大。
最終留下來的那些題,都會更難也更有區分度。
具體預測過程中,要求模型每次運行八小時,配8核CPU、16 GiB記憶體和一塊H20,同時允許聯網檢索並安裝科研軟體。
模型將在這段時間裡自行蒐集證據、選擇計算方法,最後提交各比較組從低到高的預測排序。
為了防止記憶污染,評分過程也會全程在獨立、斷網的容器中進行,禁止AI檢索原始研究結果,還會自動掃描工具輸出,識別源論文DOI、標題等標識符。
最後系統將用Spearman相關係數對照預測與實測排序。
係數越接近1,排序就越貼近實驗結果。

△SPU的評測流程
有意思的是,SPU還關注到了很多基準測試沒有考慮到的細節。
比如對於最後的得分,SPU會考慮會不會是運氣使然,萬一是瞎貓碰到死耗子了呢。
所以它會額外為每道題生成4000份隨機排序,把第95百分位作為隨機水平閾值,檢查模型提交是否明顯超過這一參照。不同任務也都有相應的參照依據。
整套SPU的設計,可以說是科學嚴謹的。
模型要在裡面一步步自己判斷什麼值得算,並為最終預測交卷。
這一設計既有利於衡量當前AI的濕實驗預測能力,也為後續研究團隊藉助統一指標持續改進實驗指明了方向。
說歸說,咱們接下來不妨一起看看首批前沿模型的成績單。箇中細節還挺值得單獨拎出來講講。
全新測試讓前沿模型集體破繃
SPU首輪系統評測覆蓋12款前沿模型、13種配置。這裡的配置,指的是模型、推理強度以及所使用的模型框架。
先說說整體成績。
一句話:都不咋地。
在全部已評分任務上,平均分最高的是Claude Opus 5.5,拿了0.486分。但其中也只有一半的任務,超過了隨機水平。
13個配置裡,幾乎都是這樣,能超過隨機水平閾值的任務比例僅有34%~52%。
也就是說,在場的所有模型距離真正可靠的濕實驗預測,都還有一段很長的距離。

△領先組和落後組的行為對比分析
不過模型之間亦有差距,平均表現可以劃分為兩個梯隊:
領先組(6個模型)和落後組(7個模型)。
同題比較中,領先組平均還是要比其餘七個高出約0.15分。
還有個細節值得注意。領先組約9%的任務得分低於0,其餘七個配置的這一比例能高達22%。
這裡的0指的就是隨機有效排序的平均分,負分即意味著預測與實際排序呈負相關。
差距具體來自哪兒呢?研究團隊又往下深挖了一步。
他們先把同題中其它模型的預測合成一份參考排序,再將實驗兩兩配對,對照實測結果,檢查每個模型單獨有沒有排對。
在參考排序正確的實驗對上,領先組能排對86%,其餘七個配置為78%;而對於參考排序錯誤的實驗對,兩組獨立排對的比例都在30%左右。
所以其實領先組的一部分優勢,恰恰體現在共同預測正確的地方,這部分領先組始終會更穩。

至於模型為什麼會偏離正確判斷,運行記錄裡有更具體的線索。
以溶液任務為例,同一個聚合反應,依次更換12種溶劑,任務要求按最後分離得到的聚合物質量排序。
Opus 5.5得分0.874,Qwen3.8為-0.126。12個候選溶劑條件兩兩配對,共66對,前者排對56對,後者排對30對。

△同一道任務上Opus和Qwen的兩次執行
分析發現,這是因為二者從一開始關注的因素就有所差別:
Qwen3.8主要依據溶劑能溶解多少乙烯來排序,Opus 5.5更關注原料的混溶情況以及催化劑在溶劑中的相容性。
雖然Qwen3.8在計算過程中,也同樣發現了這一問題,但最終沒能直接改變模型最後採用的排序依據。
所以預測出錯最有可能發生的階段,就是在選擇判斷依據的那一步上,模型還要學會根據線索即時調整排序方式,才能讓這些發現真正影響答案。
拆開來看,這些差異也會隨著具體學科與任務發生變化。
在公開任務各學科的已評分結果中,化學平均分最高的是Opus 5.5,材料科學是Fable 5.1,生物學是GPT-6 Astra Medium,醫學是Opus 5。
P.S.Fable 5.1、Opus 5.5存在拒答現象。

△各模型在四個學科上的得分
所以如果準備讓AI參與某一類研究,不妨先找個相關任務,拿來SPU測測,確定模型真的適用後再進行正式實驗。
私有任務的結果,把這一點講得更具體。
13個配置中有12個的平均分顯著高於隨機排序,配置之間沒有檢出明顯差異。相比之下,不同任務帶來的變化尤為醒目。
同一批電解液,預測離子電導率時,13個配置的排序相關係數集中在0.89~0.95;換成電化學窗口,12個獲評分配置的得分為-0.55~0.07,均未超過隨機水平閾值。
模型沒變,測量目標一換,成績分布就明顯換了。
所以下次再評價一個模型時,只說它擅長化學還不夠具體,還要看它具體面對哪一種測量目標、哪些實驗條件。

△各模型在16個私有任務上的預測表現
再講一個挺反直覺的事兒:
一般來說,多給模型一些時間、更高的推理強度,成績應該會繼續往上走吧?
大家普遍都是這樣想的,也都是這樣做的。
結果你猜咋地,SPU的結果一出,直接啪啪打臉——
在同樣的8小時運算下,研究團隊將GPT-6 Astra從中等推理強度調到最高,最高強度的運行時間中位數增至4.8倍,API成本中位數也增至5.3倍。
但預測得分……幾乎紋絲不動。
嗯?研究團隊還特地回去翻了翻模型運行記錄。
結果好傢伙,在完成的79個任務上,GPT-6 Astra最高推理強度通常在運行到中位26%時,就已經給出了答案。
模型後續也沒閒著,繼續計算修改,但都是微調,沒能在結果中顯現出差異。
換言之,推理強度再高,也不一定讓結果更好。

△GPT-6 Astra在兩種推理強度下的投入與表現
這個現象倒也給模型的資源分配提了個醒,如果要追加計算,千萬別盲目衝,耗時耗力還未必討巧。
相反可以更細緻地沿著運行記錄檢查,先充分了解新增的證據究竟對應哪項判斷,再有目的性地局部提升算力。
其實在工具使用上,也有類似的現象顯現。
GPT-6 Astra Max每次運行使用的方法類別中位數為4類,Medium為1類,但兩種配置的得分仍未檢出顯著差別。
理由也差不多,都是好工具沒有用在刀刃上。
比如蒙特卡洛採樣,雖然大部分時間模型都在調用該工具,但只是給最後的排序加了點誤差範圍,沒有直接影響到結果本身。

△科學計算工具調用情況
所以其實,工具用得再多也不如用得準。
GPU的使用情況也提供了一個有意思的視角。
在提供了充足的GPU算力情況下,真正成功運行GPU計算的只有255次,不到五分之一。
不同模型、不同學科,跑GPU的情況也各不相同,所以單純看調用GPU的次數,本身很難說明模型科研能力。
要判斷算力有沒有幫上忙,還得看它被用來算了什麼、計算結果是否有助於預測,以及這些結果如何影響最終排序。
關鍵還是要將算力引到排序相關的物理量上,才能讓模型更為精準地完成預測。

△GPU使用統計
搭配成本一起看,各配置每次運行的平均API成本,從0.22美元到65.91美元不等,差距足足300倍。
這意味著SPU同時提供預測表現與調用成本,對準備部署科研模型的團隊,是個不錯的參考依據。
從整體得分到同題軌跡,SPU把模型差異展開到了科研判斷的每一處細節裡,比如算力、比如成本。
AI算出的數值,對預測到底有多大幫助;預測出了錯,又該回頭檢查哪些判斷……這些都能結合實驗結果與運行記錄繼續分析。
下一輪改進也就有了可以明確嘗試的方向:
根據SPU,模型能夠更及時發現錯誤假設,更有依據地保留或修改排序。改完後,再放回相同任務,看看預測有沒有更準。
把「檢驗理解」搬進模型的考場
可以說,SPU與AI4S的發展規律高度契合。
AI4S的評測正在逐步深入真實實驗環節,面向實驗執行的基準也在今年陸續出現。
但在執行之外,預測作為科研流程中繞不開的一步,也是最難量化的一步,終於有了可衡量的方式。
這樣的好處體現在兩方面:
研究者由此可以分析,哪些測量目標更容易預測,哪些任務差異最大,以及一次錯誤判斷如何形成。既能節約昂貴且寶貴的實驗資源,也能縮短決策時間。
對模型開發而言,這也提供了更為具體的改進參照。
隨著實驗類型增多,評測也能回答更具體的問題:面對哪些材料、實驗條件和測量方式,AI給出的排序更可靠、更值得參考。
科學家由此可以圍繞同一類問題持續積累進展。

事實上,SPU還只是UniPat AI系列真實工作評測中的冰山一角:
- ScienceVision:關注模型如何從三維科學對象中獲取證據並回答問題;
- PaperBenchX:把已發表研究轉為可執行、可驗證的論文復現任務;
- SaaS-Bench及EvoCode-Bench:分別考察實際軟件流程與需求持續變化時的開發工作。……
這些工作覆蓋科研、辦公與軟件開發,共同關心AI進入具體工作後怎樣完成任務,以及結果如何得到驗證。
這也側面體現了,UniPat AI對AI走向科研實踐、甚至走向真實世界,擁有獨到的行業認知和前瞻性判斷。
UniPat AI也展示出一種新型的AI合作模式:
領域專家參與任務篩選與審核,合作實驗室提供未發表任務,項目團隊將不同學科的實驗組織成統一評測任務。
以SPU為例,由UniPat AI牽頭,顧問成員所屬機構包括斯坦福、康奈爾、哈佛、UIC、北大、港科大和FutureHouse。來自優睿賽思、愛博泰克、深度原理與恩和生物的濕實驗合作成員,參與了相關實驗工作。
跨學科知識與實驗資源由此進入同一套評測過程。SPU既承載了對問題的選擇,也呈現出將科研問題組織成可執行任務所需的協作。
目前SPU相關的100個公開任務計劃以完整的Harbor任務包形式發布;16個私有任務繼續保持私有,用於受控評測。數據集和代碼都已經開源。
誠然,今天的AI,在這套SPU機制面前還只是新手。
它能把工具用得飛快,能在8小時裡裝三套軟件、跑完DFT再做蒙特卡洛,但在最關鍵的判斷上,它還沒學會問自己一句,我算的這個量,是不是實驗真正需要測的那個量。
但隨著這類任務持續積累,AI能夠承擔怎樣的科研工作,也將變得清晰。
SPU把這段距離量了出來,接下來每一次考試,都是AI向真實實驗台走近的記錄。
本文來自微信公眾號 “量子位”(ID:QbitAI),作者:關注前沿科技





