簡述
- Anthropic 於週一發布 Claude Sonnet 5.5,每百萬輸入 token 收費 2 美元,每百萬輸出 token 收費 10 美元——與 Sonnet 5 相同,且為 Opus 5.5 價格的一半。
- 根據 Anthropic 的說法,Sonnet 5.5 在 Terminal-Bench 4.0 上得分 70.6%,而 Opus 5.5 為 66.4%;獨立測試機構 Artificial Analysis 也認為它領先,分別為 63.6% 對 59.6%。
- Artificial Analysis 將其排在 Opus 5.5 之後,位居第二,但表示它每項任務使用的 token 比其測試過的任何模型都多。
Anthropic 於週一發布 Claude Sonnet 5.5,這是對六月推出的 Sonnet 5 的升級。Anthropic 表示,這款中階模型的運行速度比其前代快 30% 以上。
「Sonnet 5.5 在範圍明確的日常任務、修復錯誤,以及製作精美的文件、簡報和試算表方面最為強大。它對設計也有敏銳的眼光,」Anthropic 寫道。
價格維持在每百萬輸入 token 2 美元、每百萬輸出 token 10 美元。Token 是 AI 讀寫的文字區塊,比一個單詞稍短,而公司按百萬計費。這是 Opus 5.5 收費的一半。然而,它每項任務使用的 token 少了近三分之一,這意味著它最終運行起來比 Sonnet 5 更便宜。
話雖如此,這個模型在程式設計方面表現出色。在 Terminal-Bench 4.0 上——這是一項測試 AI 代理能否自行輸入指令完成複雜專業任務的測試,以完成任務的比例計分——Sonnet 5.5 達到了 70.6%。Opus 5.5 得分為 66.4%,而 Sonnet 5 僅達到 10.3%。
簡單來說,更便宜的模型完成了更多工作。 Artificial Analysis,一家獨立測試公司,運行了自己的版本並表示同意:Sonnet 5.5 為 63.6%,Opus 5.5 為 59.6%,而 OpenAI 的 GPT-6 Astra 為 59.1%。
Claude Sonnet 5.5(max)在 Terminal-Bench 上取得重大進展,在 Terminal-Bench 4.0 和 Terminal-Bench-Science 中均位居頂尖模型之列。在 Terminal-Bench 4.0 中它得分為 64%,比 Claude Sonnet 5(max)提高了 50 分,並略高於 Opus 5.5 和 GPT-6 的 60%… pic.twitter.com/7CPrhgmfxe
— Artificial Analysis (@ArtificialAnlys) 2026年9月28日
分數也取決於努力設定,這是一個讓模型思考更久以獲得更好答案、同時帳單也更高的調節旋鈕。Anthropic 表示,Sonnet 5.5 在高努力設定下,在 FrontierCode 上可與 GPT-6 Sol 匹敵,而每項任務成本約為其五分之一。
在 GDPval-AA 上,該基準使用 Elo——這套類似西洋棋、用來排名相對技能的系統——為橫跨 44 種職業的真實世界專業工作評分,Sonnet 5.5 得分 1844,Opus 5.5 得分 1846,實際上打成平手。GPT-6 Sol 得分 1487。
競爭對手也跟上價格。 OpenAI 上週將 GPT-6 Sol 降至 2 美元與 10 美元,而其中階模型 GPT-5.6 Terra 定價為 2 美元與 12 美元。Anthropic 未公布 Terra 的基準測試。
問題所在
Sonnet 5.5 話很多。在最大努力設定下,它每個測試任務寫了約 193,000 個 token,是 Artificial Analysis 測量過最多的,約比 Opus 5.5 多 60%。這相當於每項任務 7.60 美元,約比 Sonnet 5 高 50%,這與 Anthropic 聲稱最多可節省 30% 的說法相牴觸。
Anthropic 的節省來自較低設定:在其應用程式中預設的中等努力設定下,該公司表示 Sonnet 5.5 以不到十分之一的成本,超越 Sonnet 5 的最佳程式編寫分數。Artificial Analysis 表示,高努力設定最具性價比。對日常使用者而言,這意味著只要把旋鈕保持在低檔,就能以一小部分價格獲得接近旗艦級的程式編寫能力。
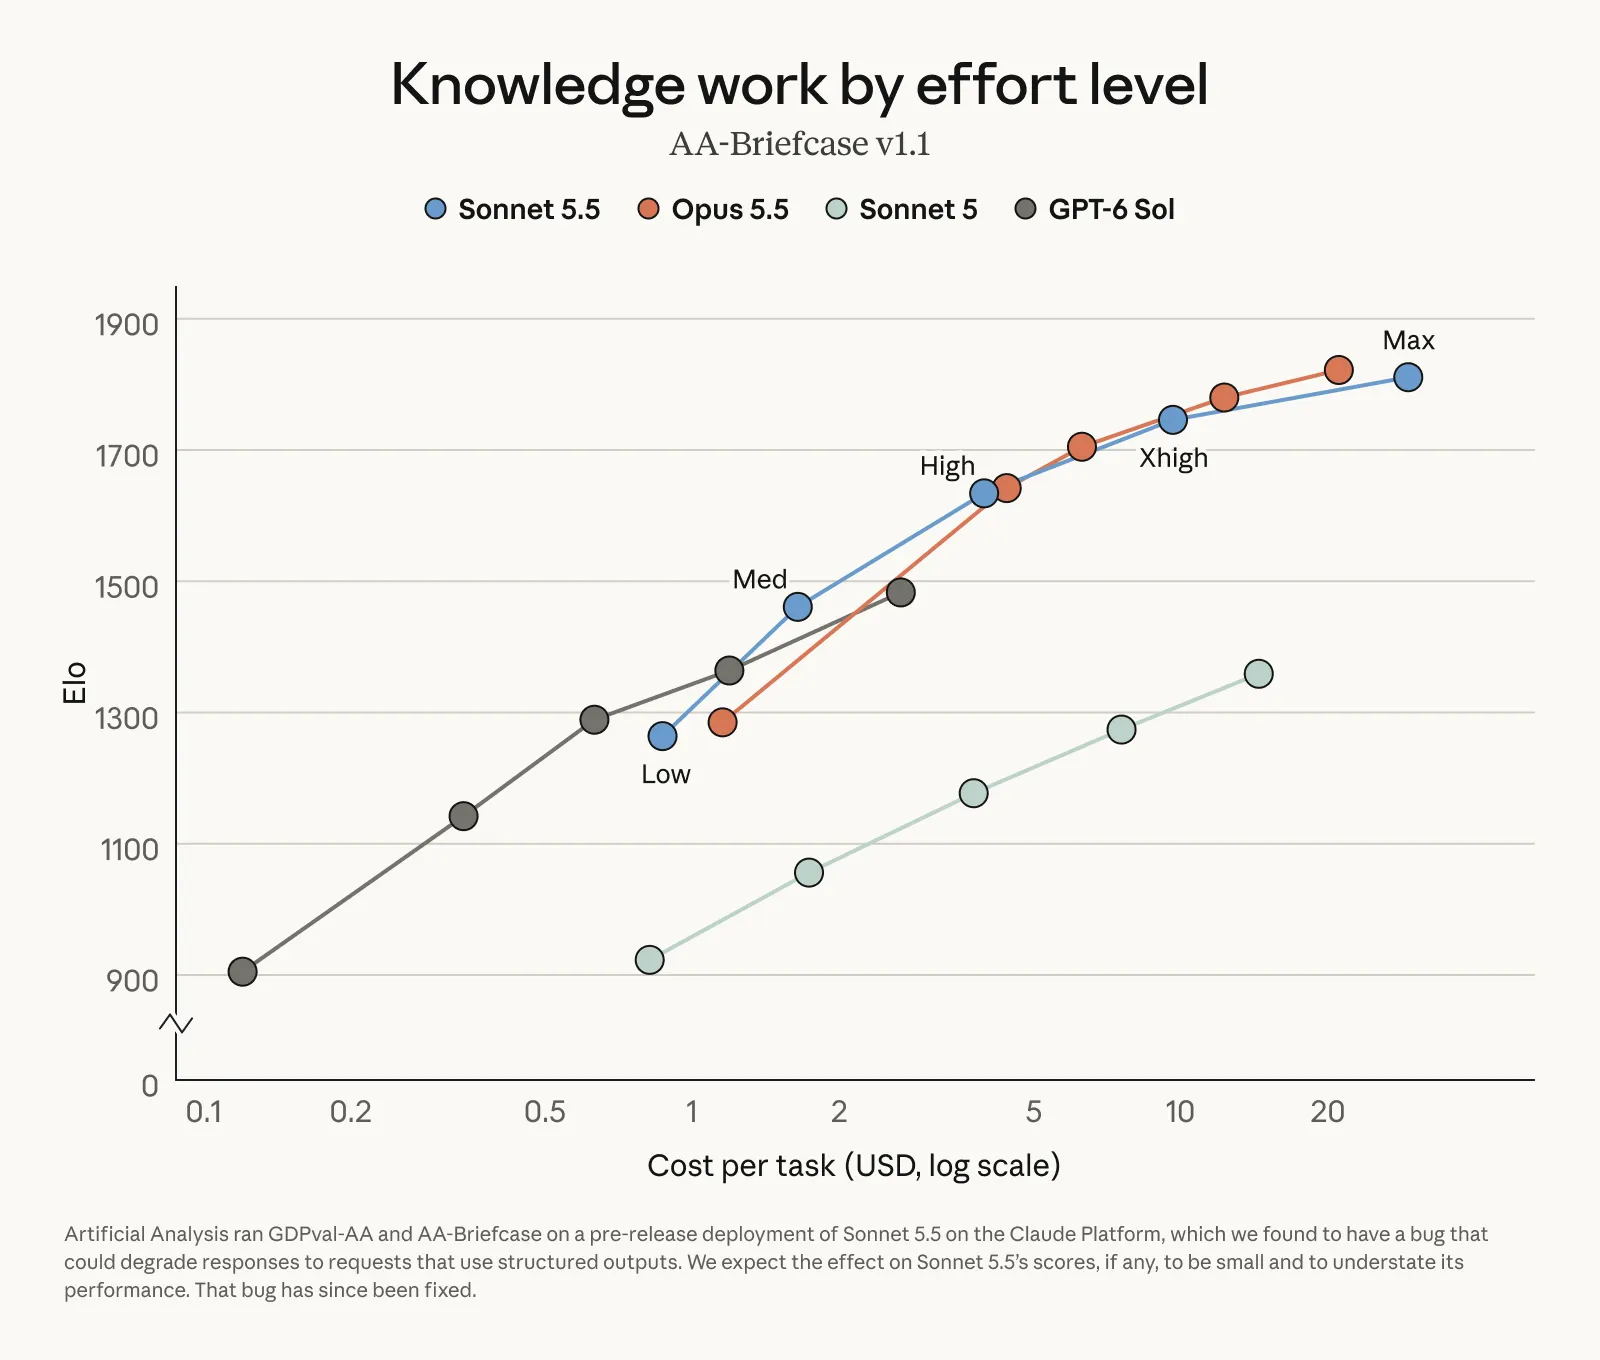
Anthropic 的表格是自行回報的,而 Artificial Analysis 測試的是一個預發布版本,該版本存在一個錯誤,Anthropic 預期這對其分數的影響很小或略微低估了其分數。Anthropic 表示,Opus 5.5 在需要持續判斷的複雜工作上仍然明顯更強。
Claude Haiku 5.5 專為高用量、成本敏感的應用而打造,預計將在未來幾週內推出。