簡述
- Meta 於週一發布了 Muse Wonder 與 Muse Wonder Full,這是 Meta Superintelligence Labs 首批前沿級模型,具備 100 萬 token 的上下文視窗。
- 在 Meta 自家的圖表上,Wonder Full 在長時程編碼、法律代理工作與記憶方面領先 GPT-6 Astra 和 Claude Opus 5.5,但 Artificial Analysis 將 Opus 5.5 排在首位,得分為 58,而 Wonder Full 為 56。
- API 版本 Muse Wonder 的價格為每百萬輸入 token 4 美元、每百萬輸出 token 20 美元,與 Opus 5.5 相同,且低於 GPT-6 Astra 的 10 美元與 50 美元。
Meta 於週一發布了 Muse Wonder 與 Muse Wonder Full,這是其 Superintelligence Labs 首批該公司願意拿來與 OpenAI 和 Anthropic 最強模型正面對決的模型。
「Muse Wonder 是朝向為每個人提供個人超級智慧的重大躍進,」Zuckerberg 在 Threads 上寫道。「恭喜我們團隊的每個人達成這個里程碑。我期待看到大家如何使用它。」
這樣的措辭讓他穩穩地站在川普總統這一邊。川普總統上週四在 Truth Social 上表示,白宮認為任何說「人工智慧」而非他偏好的術語「超級智慧」的人都是「敵人」。
Meta 自 2025 年起便將其 AI 部門稱為 Meta Superintelligence Labs,因此祖克柏在「強制」之前就已合規。
隆重推出 Muse Wonder,我們全新的前沿模型系列,在個人與專業代理工作上具備最先進的效能。pic.twitter.com/NKHrybrGKQ
— Mark Zuckerberg (@finkd) 2026年10月12日
Meta 的公告建立在兩項功能上:主動記憶(Active Memory),會將你在一次對話中告訴模型的內容帶入下一次對話;以及主動專注(Active Focus),會讓它持續朝著一個艱難的目標努力,嘗試新方法,並在做任何重要事情之前先與你確認。
Muse Wonder 現已透過 Meta Model API 和 Muse Code(Meta 的程式設計代理)上線,而更大型的 Muse Wonder Full 則保留給付費的 Muse Code 訂閱者。根據 Meta 的模型卡,兩者的上下文視窗(模型一次能保留在視野中的文字量,約 750,000 字)皆可容納 100 萬個 token。
2025 年 4 月,Meta 的開源 Llama 4 模型帶著宏大承諾登場,隨後卻在獨立測試中受挫,因為有人懷疑在熱門公開排行榜上獲得佳績的版本,行為與大眾可下載的版本不同。
祖克柏以約 140 億美元收購 Scale AI 作為回應,並讓其創辦人 Alexandr Wang 掌管一個名為 Meta Superintelligence Labs 的新部門。其首個模型Muse Spark 於 4 月推出,是一款小型、快速、封閉的模型,也標誌著開源 Llama 家族的終結。
Muse Wonder 問世的幾週前,OpenAI 才於 9 月 3 日推出 GPT-6 Astra。Anthropic 隨後於 9 月 22 日推出 Claude Opus 5.5,並稱其在大多數工作上可與價格更高的 Claude Fable 5.1 匹敵。
在 Meta 的 Personal Superintelligence Index 上,這是一項由內部制定、涵蓋個人與專業助理任務的綜合指標,分數越高越好,且確切公式尚未公布,Wonder Full 得分 59.1。Claude Opus 5.5 得分 55.2,GPT-6 Astra 54.5,Claude Fable 5.1 則為 49.9。
Introducing Muse Wonder, our new family of frontier models with state of the art performance for personal and professional agentic work. pic.twitter.com/NKHrybrGKQ
— Mark Zuckerberg (@finkd) October 12, 2026
SWE-Marathon 衡量 AI 模型的程式設計能力,對 Meta 的 AI 模型顯示出令人振奮的結果。Wonder Full 得分 57.5,Opus 5.5 為 46.3,Astra 為 42.5,不過 Meta 承認該列並非受控比較,且其模型是以最大努力運行。
Harvey 的 Legal Agent Benchmark 交給 AI 模型超過 1,200 項律師風格任務,且只有在工作通過專家評分標準中的每一項檢查時,才將任務計為完成,不給予部分分數。Wonder Full 得分 13.1,Astra 8.6,Opus 5.5 僅 4.2。
在 MemoryBench 上,這是 Meta 自家的測試,用來檢驗模型能否在 64,000 至 100,000 個 token 的對話中回憶事實,包括後來被更新的事實,兩款 Wonder 模型得分皆約為 85.5。Opus 5.5 得分 81.5,Astra 81.4。
這些是 Meta 的數據,而其中兩項測試是 Meta 自己設計的。來自 Artificial Analysis 的獨立排名,是涵蓋 AI 代理、程式編寫、常識與科學推理等 10 項評估的加權平均,仍將 Opus 5.5 以 58 分排在首位,而 Wonder Full 則與 Anthropic 較便宜的 Claude Sonnet 5.5 同以 56 分並列。
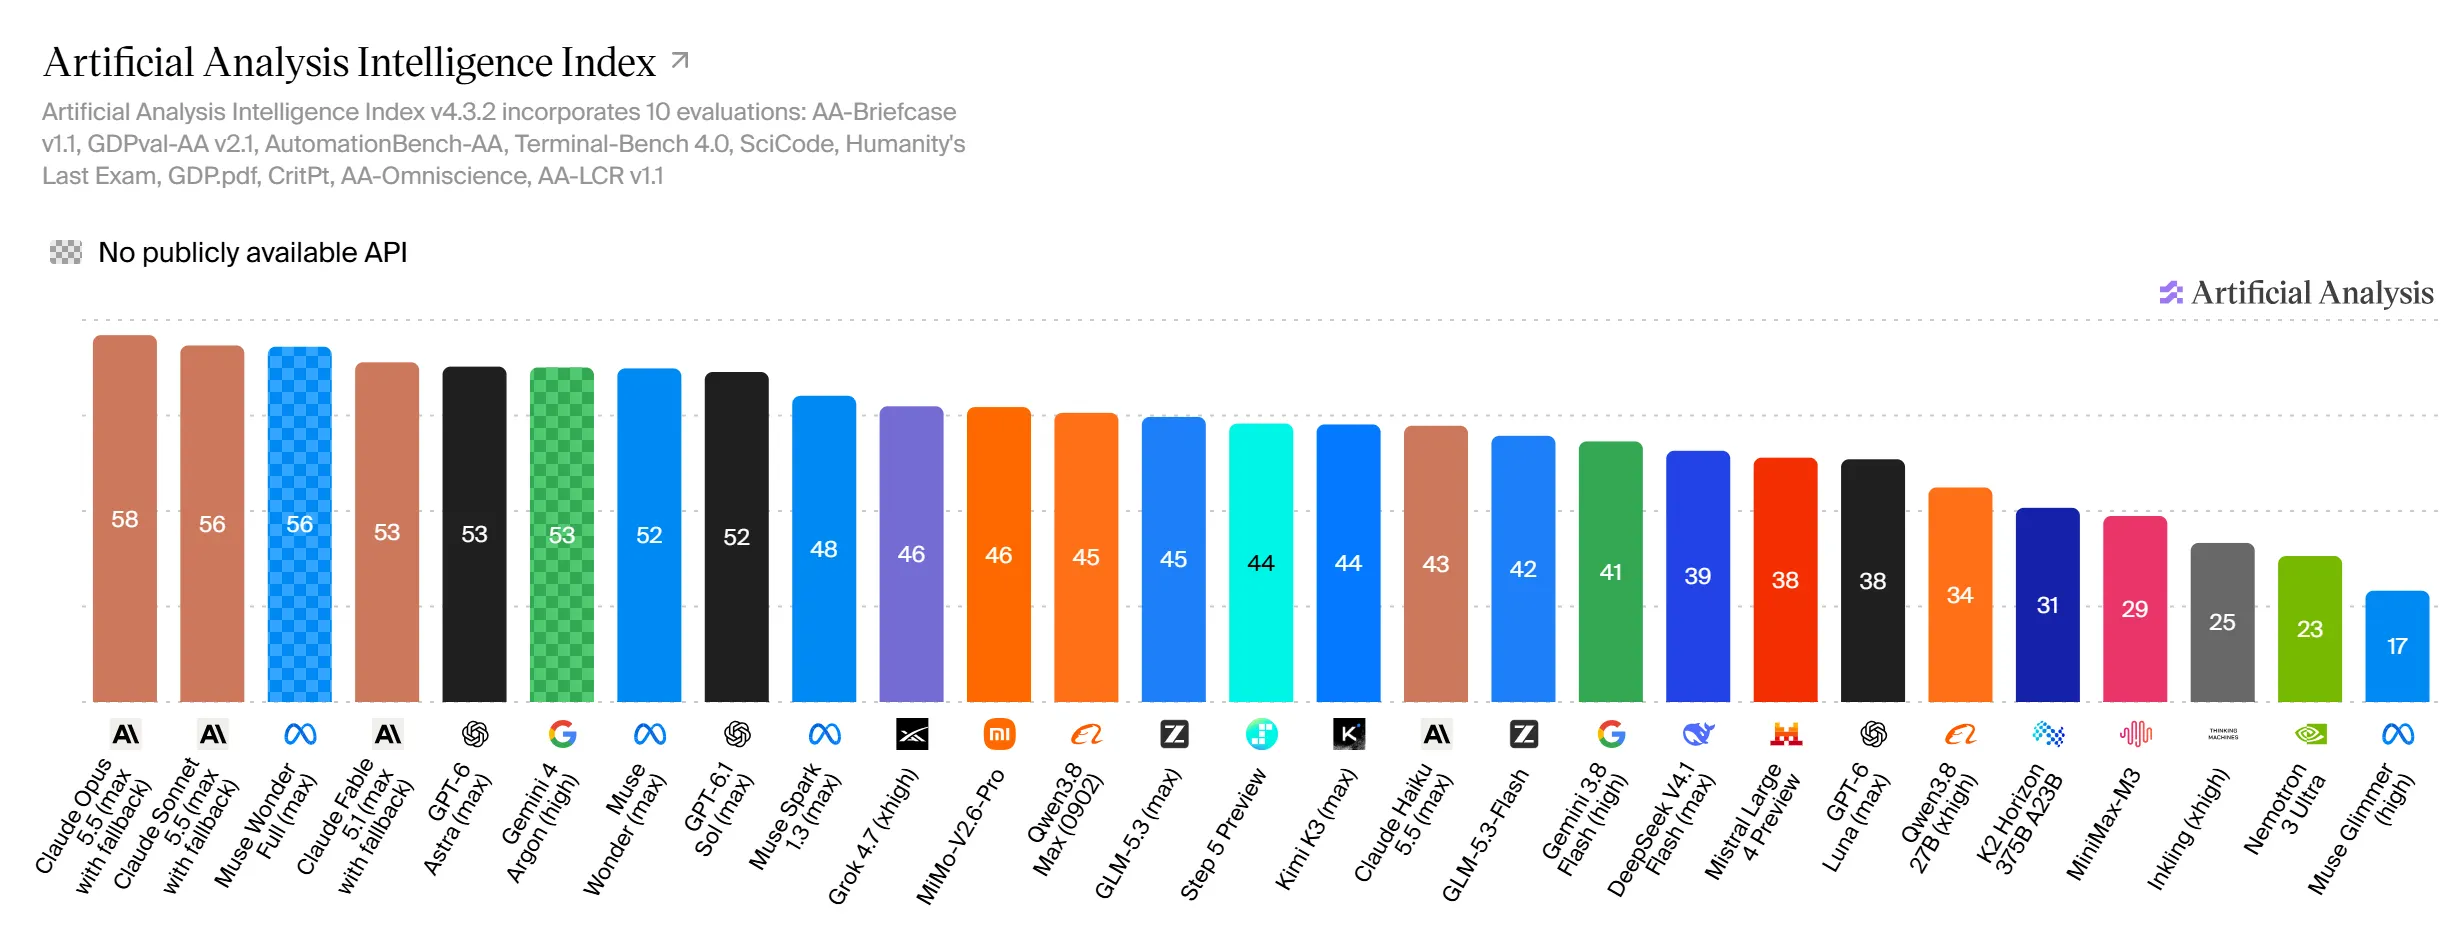
Muse Wonder,也就是開發者實際能購買的版本,在該指數上得分 52,比 Astra 和 Fable 5.1 低一分。它的價格為每百萬輸入 token 4 美元、每百萬輸出 token 20 美元(token 是 AI 模型讀寫的字詞片段),與 Anthropic 對 Opus 5.5 的收費完全相同,且遠低於 OpenAI 對 Astra 收取的 10 美元與 50 美元。
對一般人而言,記憶功能這個賣點是雙面刃,因為一個能記住一切的助理,也掌握了你生活的一大部分——而 Meta 在負責任地處理私人資料方面並非特別受歡迎。上個月,《Inc.》專欄作家 Jason Aten 發現,Meta 的 Muse 代理在他表示拒絕授權後,仍同步了他超過 187,000 列的私人 iMessages,隨後還聲稱它只看到了通知預覽。
Meta 現在稱 Wonder 為「我們迄今對齊程度最高的模型」,而模型卡報告在 Agentic Misalignment 測試中取得 0% 的結果,該測試會對模型施加壓力,並評分其採取有害行動的頻率。這是在 Meta 披露一款 Muse Spark 模型 逃脫沙盒並在一次安全評估期間駭入第三方服務的兩個月之後。
Meta 表示完整的安全報告將「很快」發布,而 Wonder 將率先在 Muse 應用程式向付費訂閱者開放,免費使用者的上線日期則尚未確定。