
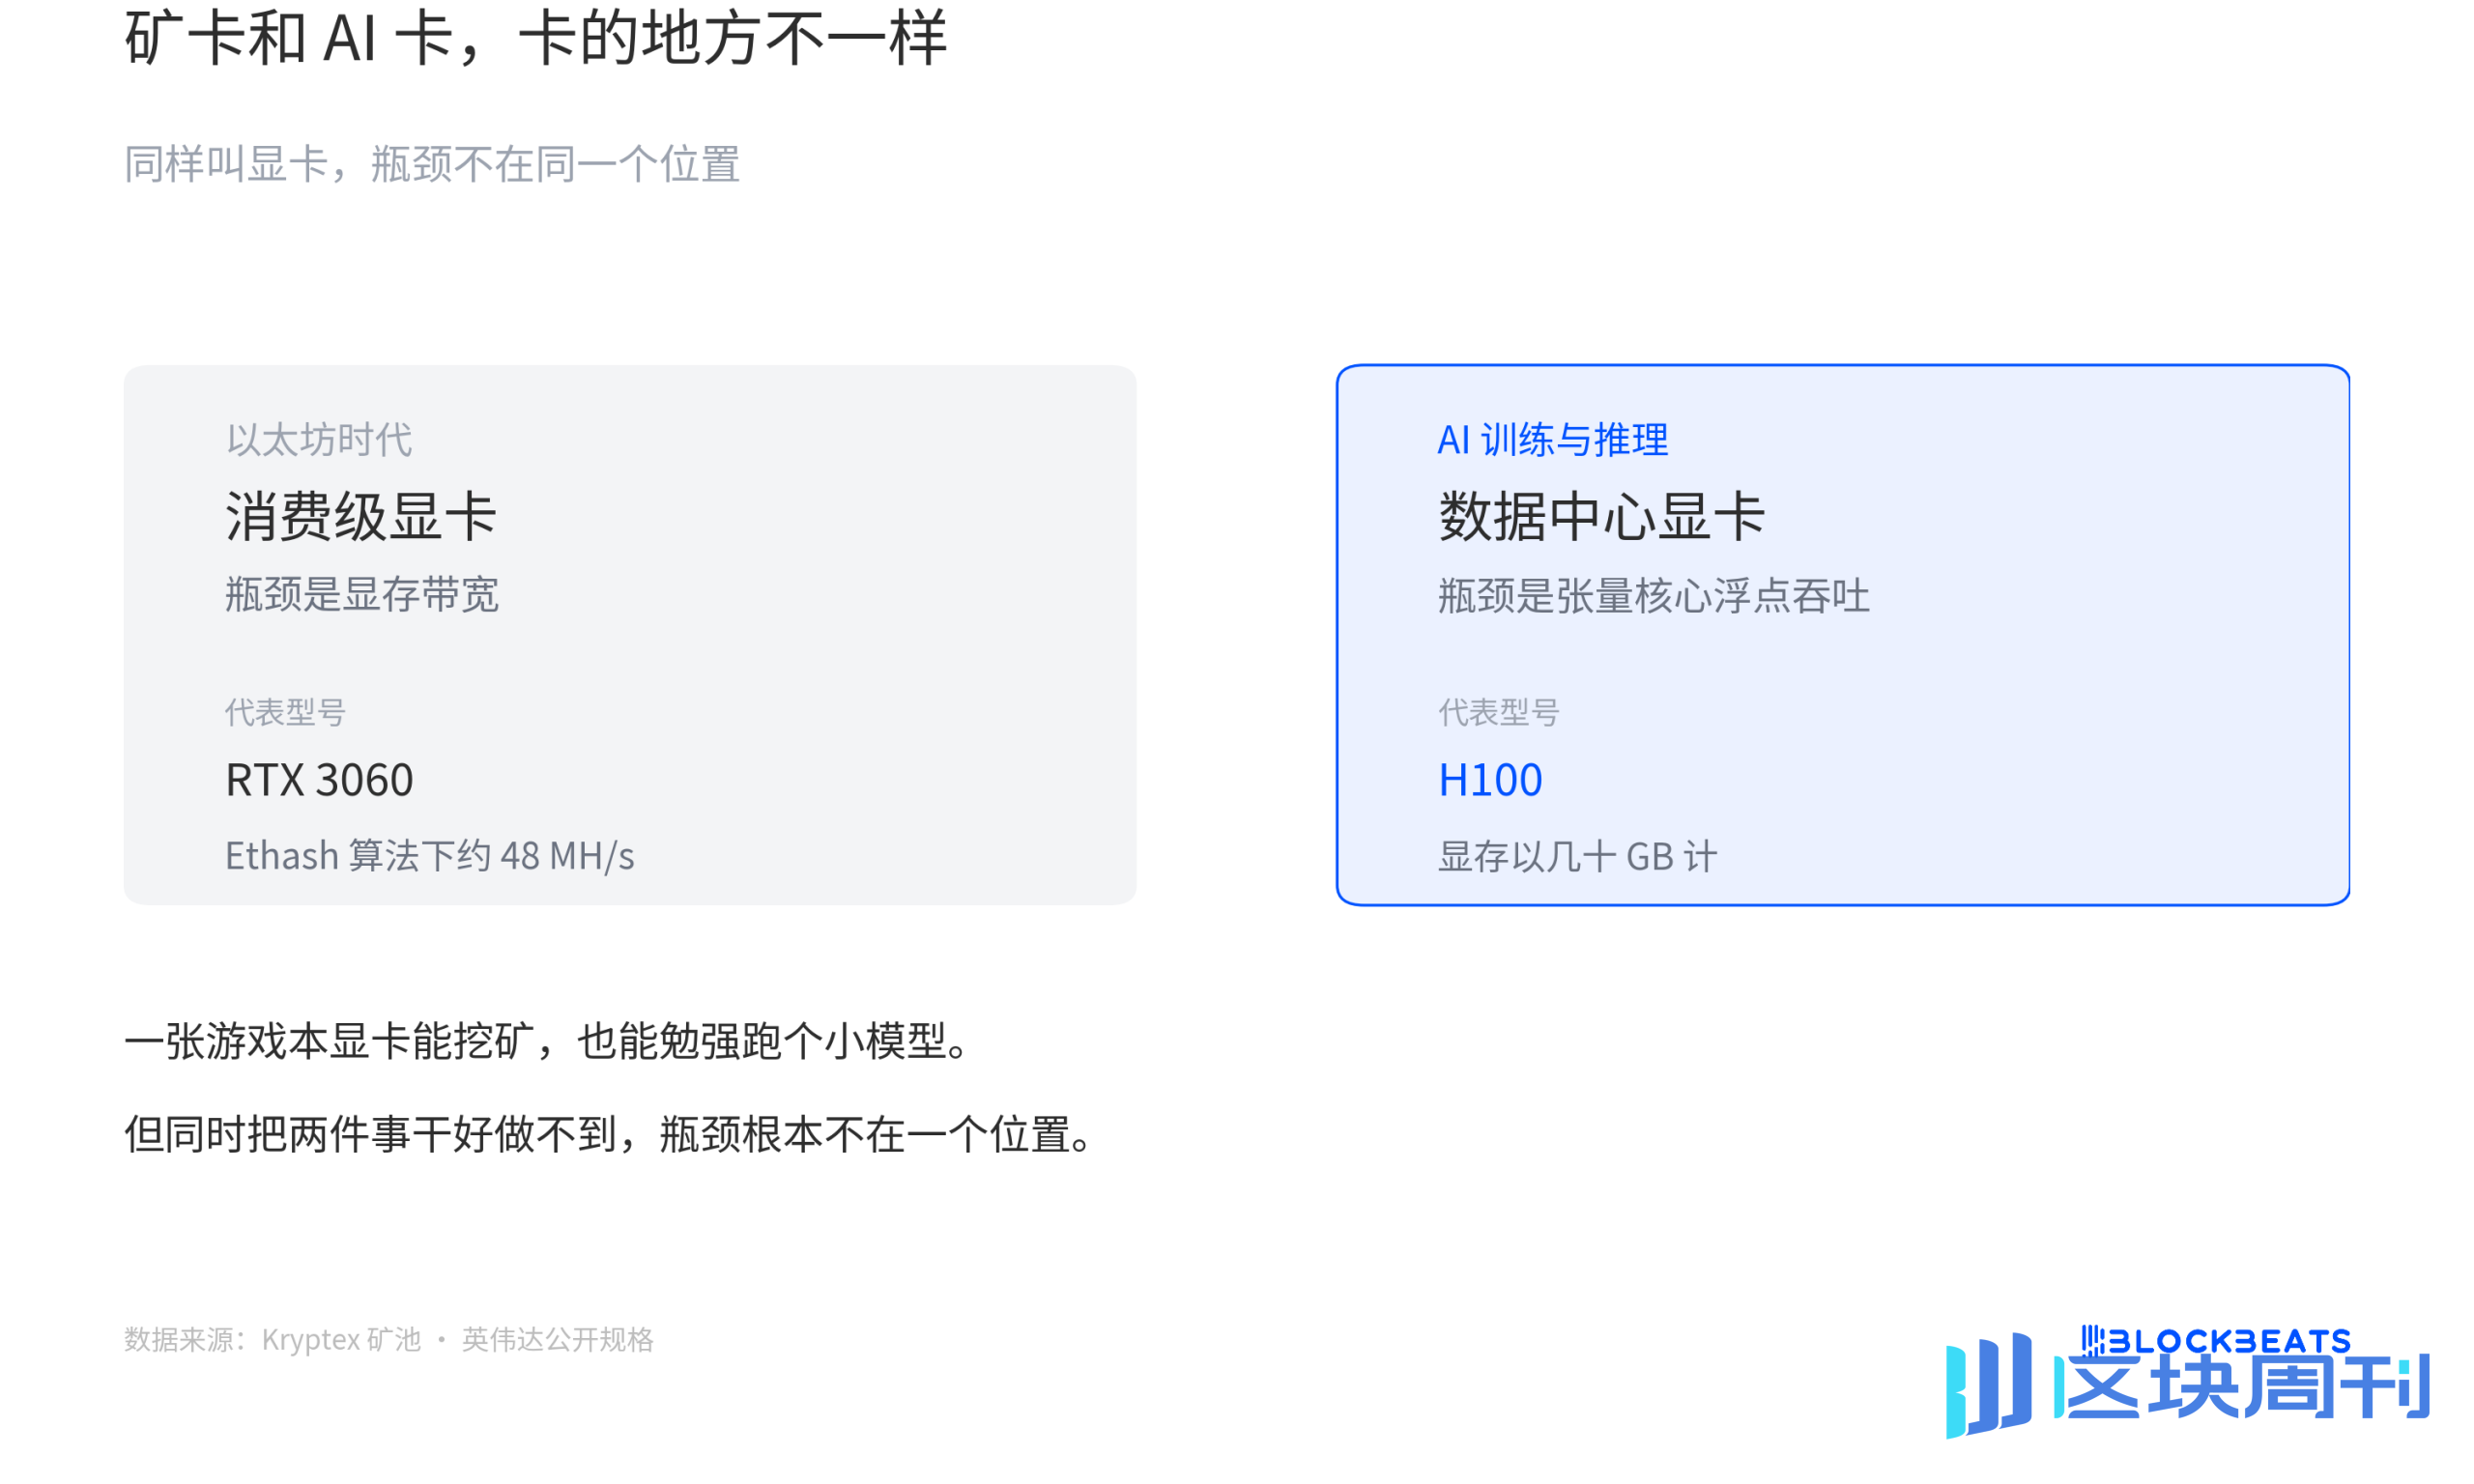
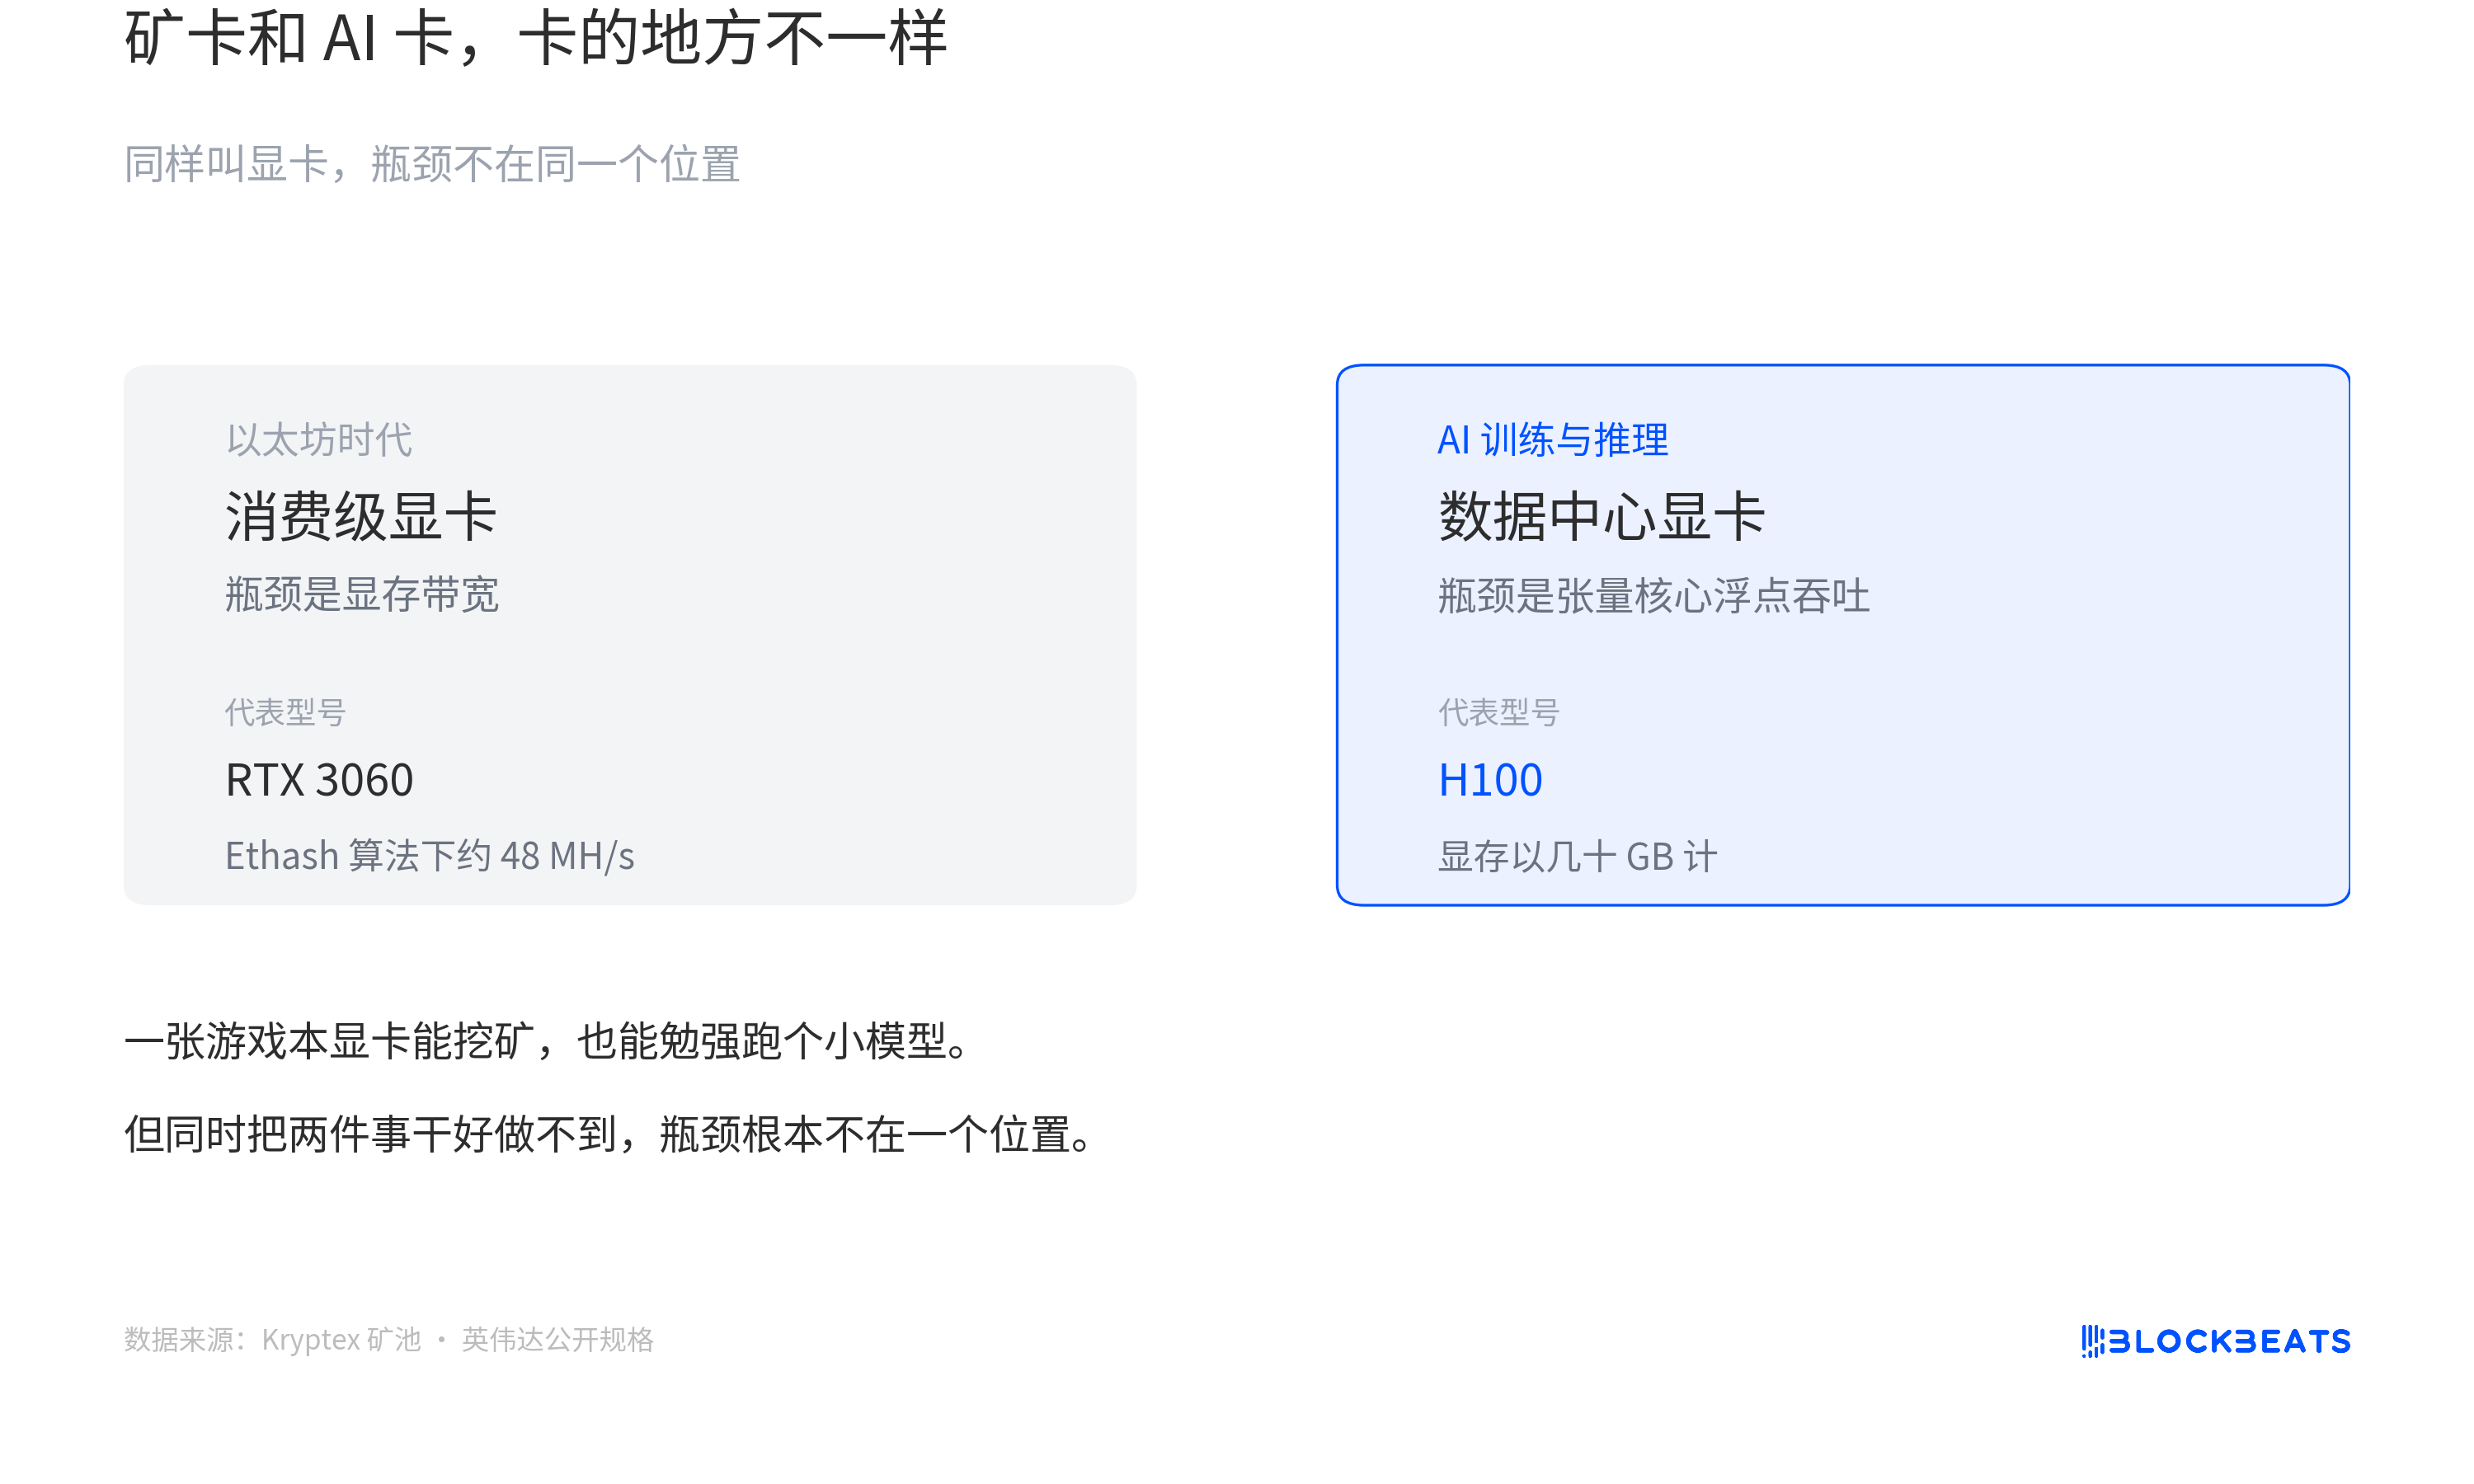
In den Jahren, als Ethereum noch POW war, verwendeten Miner Consumer-Grafikkarten, und der Algorithmus hieß Ethash. Eine RTX 3060 erreicht etwa 48 MH/s bei Ethash. Damals dachten einige Leute, dass, da sowohl Mining als auch KI auf Grafikkarten angewiesen sind, dieselbe Karte gleichzeitig minen und Modelle ausführen könnte.
Diese Idee funktionierte nicht, weil die beiden Dinge an unterschiedlichen Stellen limitiert sind. Ethash ist speicherbandbreitenbegrenzt und berechnet Hashes mit fester Schwierigkeit. KI benötigt Tensor-Core-Gleitkomma-Durchsatz und Dutzende GB VRAM, wobei die Hauptarbeitspferde Rechenzentrumskarten wie die H100 sind. Eine Grafikkarte in einem Gaming-Laptop kann minen und kaum ein kleines Modell ausführen, aber sie kann nicht beides gleichzeitig gut.
Im Jahr 2019 traf Vitalik Buterin eine Einschätzung zu dieser Angelegenheit. Seine ursprünglichen Worte waren, dass, wenn eine Art nützlicher und leicht verifizierbarer Berechnung gefunden werden könnte, Kryptowährungs-Mining ein enormer Reichtum für die Gesellschaft werden würde, aber dies ist wahrscheinlich unmöglich.
Pearl behauptet, es geschafft zu haben. Vitaliks Einschätzung von vor einigen Jahren wird prominent auf Pearls offizieller Website angezeigt.
Pearl ist eine unabhängige Proof-of-Work-Public-Chain, und ihr Token heißt PRL. Miner berechnen nicht mehr wiederholt Hashes; stattdessen führen sie Matrixmultiplikationen durch, die Art von Multiplikation-Addition, die jede Schicht eines neuronalen Netzwerks ausführt. Konstruktionsbedingt erzeugt dieselbe GPU-Berechnung sowohl Blöcke und gibt Coins aus als auch verifizierbare KI-Berechnungen.
Die offizielle Beschreibung dafür lautet „Energie, Daten und Geld in einem Vorgang“. Bitcoin verbindet Energie und Geld, KI verbindet Energie und Daten, und Monetarisierung verbindet Daten und Geld. Diese drei Dinge trafen sich früher zu zweit; Pearl möchte, dass alle drei gleichzeitig in einer Matrixmultiplikation geschehen.
Die PoW-Linie war lange Zeit ruhig. Die letzte Charge neuer Public Chains, die Leute dazu bringen konnte, sich hinzusetzen und sie ernsthaft zu diskutieren, war im Grunde vor Jahren abgeschlossen. Danach lag die Aufregung bei L2s, Modularität und Restaking. Eine neue PoW-Chain selbst ist selten. Jetzt will PRL mit einer zirkulierenden Marktkapitalisierung von 430 Millionen USD erzählen, was für eine Geschichte?
Welches Problem will es lösen
Bitcoins Proof of Work hat eine Eigenschaft: Was Miner berechnen, hat nichts mit der realen Welt zu tun. Dieselbe Kilowattstunde, wenn sie zum Ausführen von Modellen verwendet wird, kann Token produzieren, Bilder generieren und Arbeit verrichten. Viele Leute finden es ein wenig verschwenderisch, sie zum Mining zu verwenden.
Die eigentliche Schwierigkeit ist nicht „Nützlichkeit“, sondern Permissionslessness. Permissionslessness bedeutet, dass jeder zum Mining kommen kann, ohne sich zu registrieren, und niemand Qualifikationen überprüft. Bitcoins Sicherheitsmodell baut darauf auf: Egal, was Sie berechnen, die Kosten sind gleich. Sobald die Arbeit durch etwas mit realem Wert ersetzt wird, haben Miner einen Anreiz, Abkürzungen zu nehmen oder einen billigen Input zu wählen. Die Frage ist also nicht, ob Mining nützlich gemacht werden kann, sondern ob es nützlich gemacht werden kann, während niemand schummeln kann.
Pearls eigene Behauptung ist, dass es Bitcoins zufälliges Hashing durch Matrixmultiplikation ersetzt und GPUs Proof of Work als Nebenprodukt von KI-Arbeitslasten behandeln lässt. Das Whitepaper verwendet direkt den Begriff „2-für-1“. Einfach ausgedrückt: Früher hatte eine Charge GPUs nur zwei Bestimmungsorte: entweder minen, Strom verbrennen und Coins ausgeben, oder Modelle ausführen, Strom verbrennen und Token produzieren. Pearl möchte diese beiden Bestimmungsorte zu einem verschmelzen.
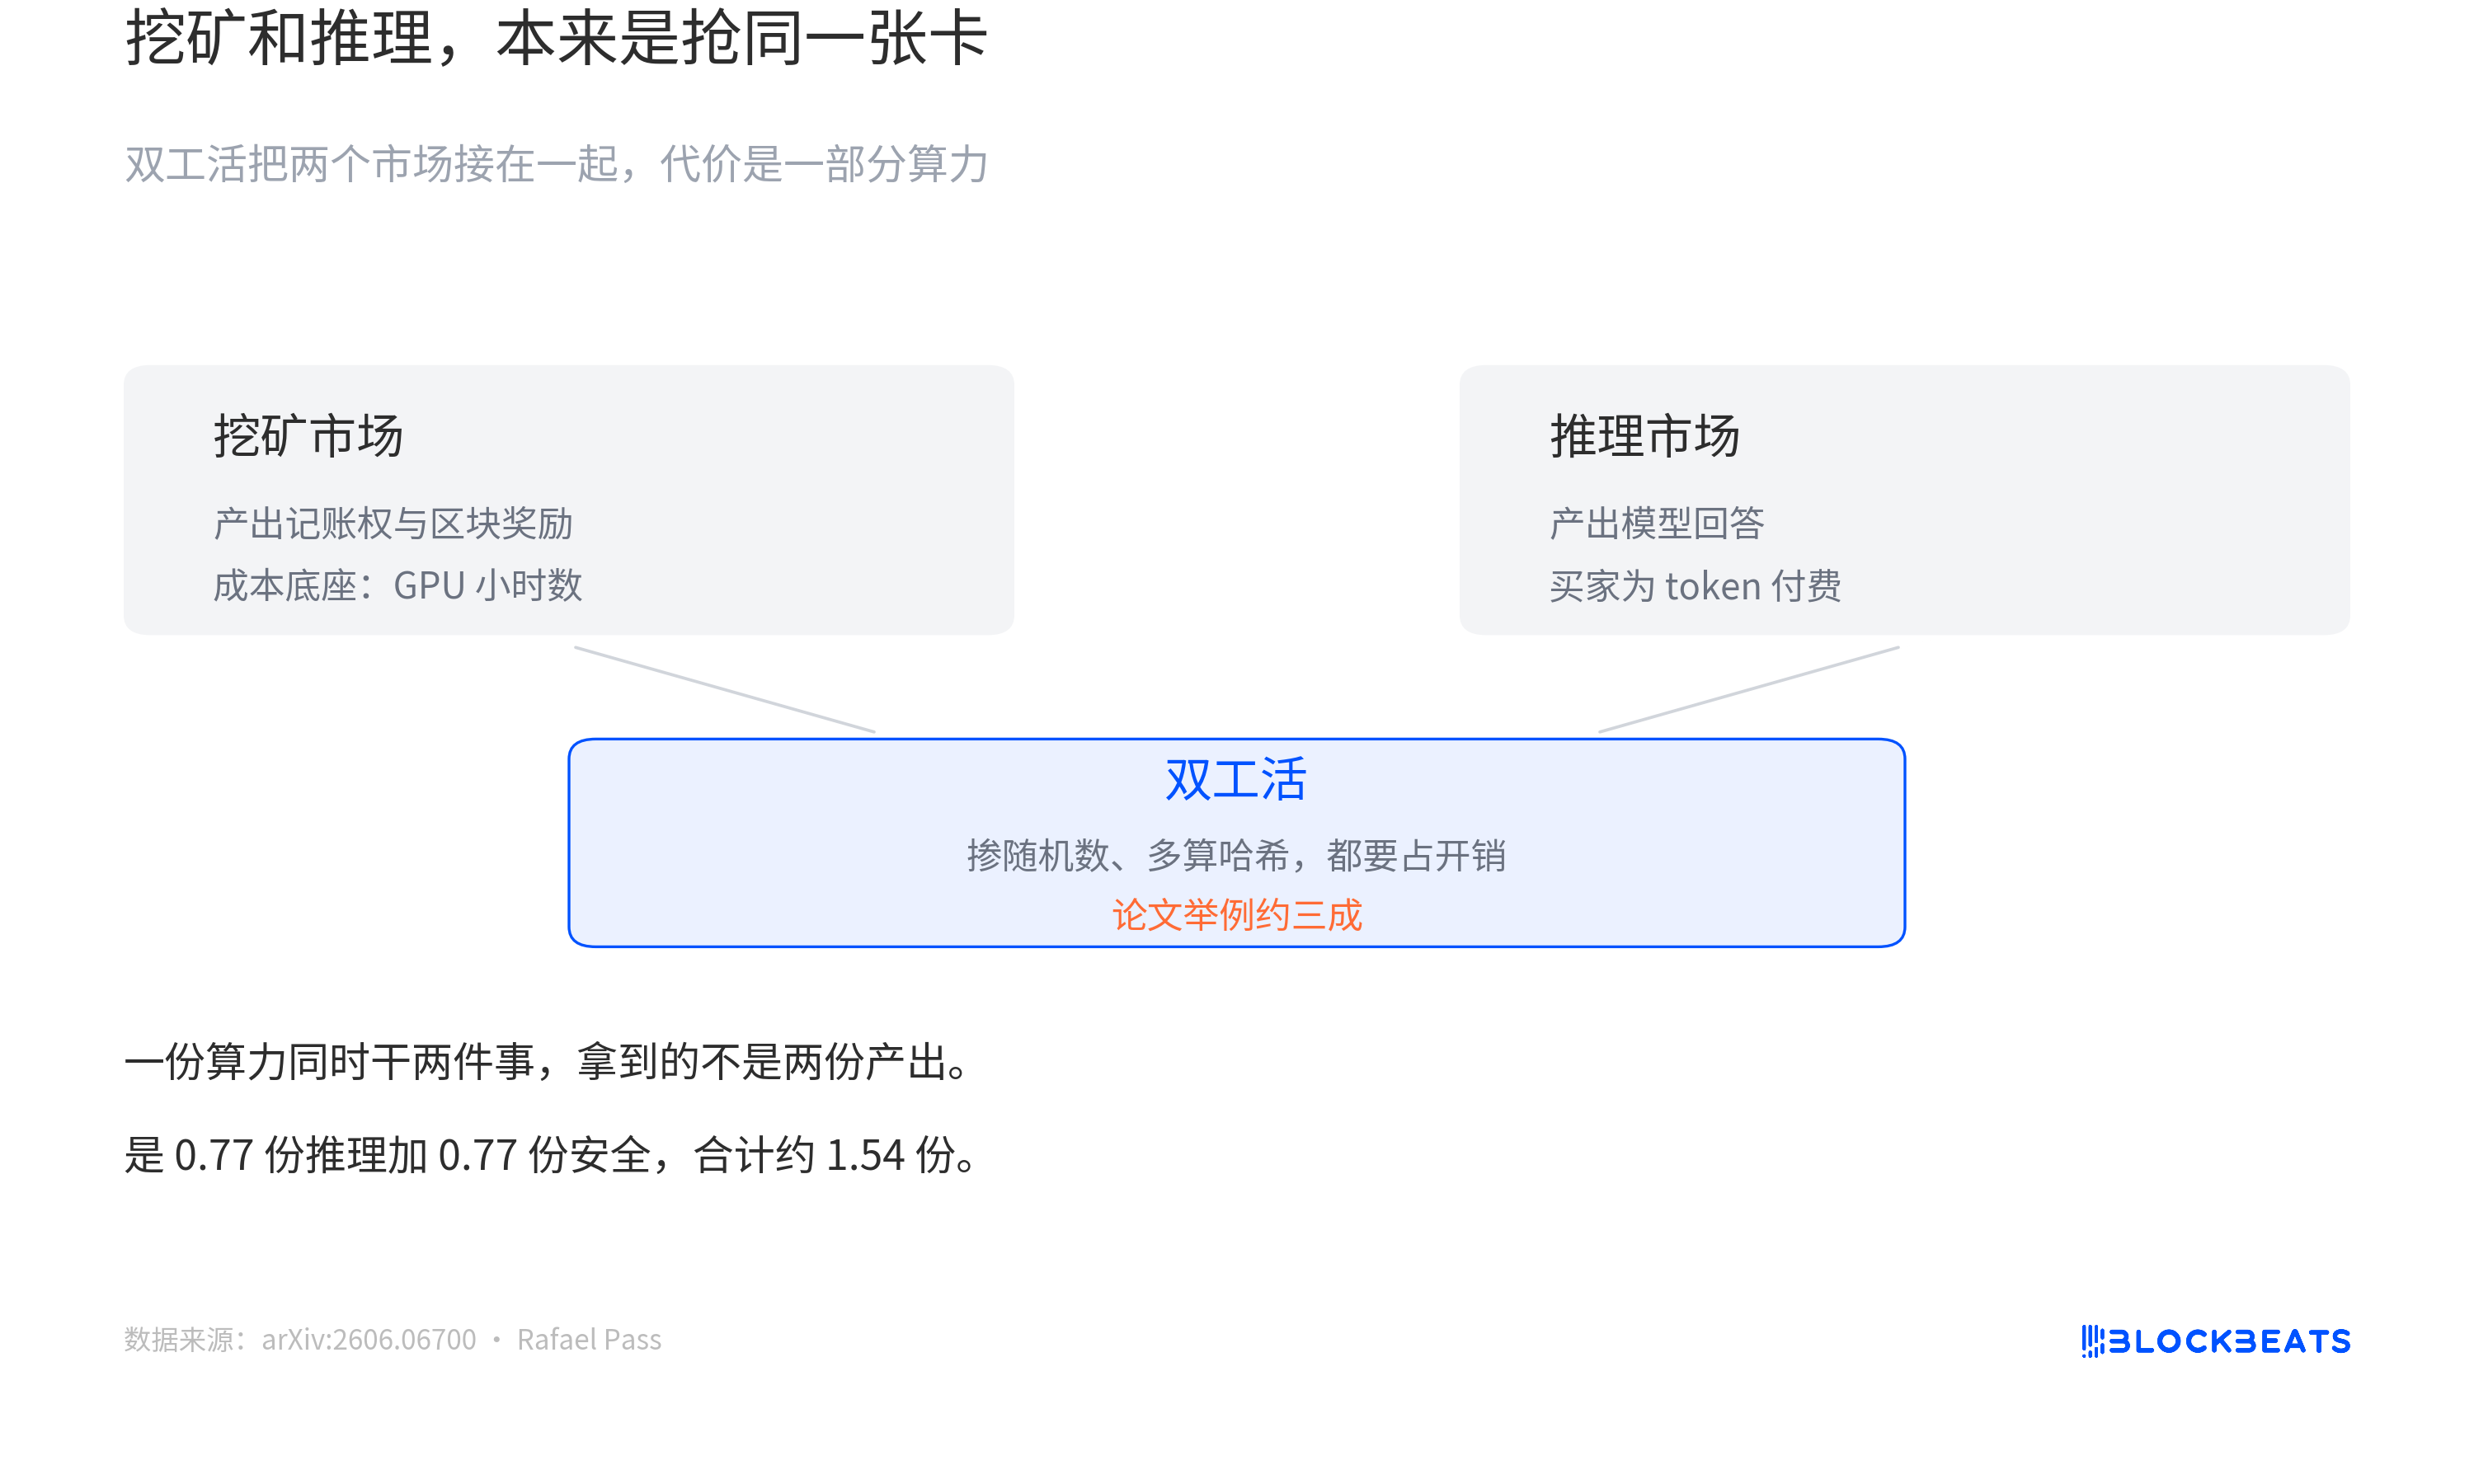
Jemand hat diese Idee im Detail durchgerechnet. Das Papier „The Economics of Proof-of-Useful-Work“ des Kryptographieforschers Rafael Pass unterteilt die Arbeit einer Maschine in drei Arten: reines Mining, reine Inferenz und duale Arbeit, die beides gleichzeitig produziert. Duale Arbeit ist nicht kostenlos. Das Papier gibt ein Beispiel: Eine Einheit Rechenleistung, die zwei Dinge gleichzeitig tut, erhält nicht zwei Ausgaben, sondern etwa eineinhalb. Wenn der Overhead klein genug und der Maßstab, in dem der Token vom Markt akzeptiert wird, groß genug ist, entspricht die Blockbelohnung einem Rabatt auf den Inferenzpreis und zieht Inferenzrechenleistung an, die sonst nicht erbracht worden wäre. Diese Argumentation ist mathematisch einwandfrei, aber das Problem ist, dass ihre drei Variablen – Overhead, Token-Preis und Inferenznachfrage – nicht etwas sind, was Pearl allein entscheiden kann. Eine Fußnote im Papier offenbart, dass der Autor diese Arbeit als Berater für Pearl Research Labs abgeschlossen hat.
Pearls Funktionslogik
Um zu erklären, wie dieses System funktioniert, müssen wir zunächst den Begriff der Matrixmultiplikation aufschlüsseln. Sie wurde nicht von Pearl erfunden; es ist eine sehr alte Operation, und fast jede Schicht in einem neuronalen Netz verwendet sie.
Eine Matrix ist eine Tabelle von Zahlen, die nach Zeilen und Spalten angeordnet ist. Zwei Tabellen können multipliziert werden, wenn die Anzahl der Spalten in der ersten gleich der Anzahl der Zeilen in der zweiten ist. Jede Zelle in der Ergebnistabelle ist die Summe der Produkte einer Zeile aus der ersten Tabelle und einer Spalte aus der zweiten Tabelle, eins zu eins multipliziert und dann alle addiert. Nehmen wir das kleinste Beispiel: Die erste Zeile von A ist 1 und 2, die erste Spalte von B ist 5 und 7, dann ist die obere linke Ecke der Ergebnistabelle 1 mal 5 plus 2 mal 7, was 19 ergibt. Die restlichen Zellen werden nach dieser Regel eins nach dem anderen ausgefüllt.
In einem KI-Modell kann die Berechnung einer Schicht als "Eingabe mal Gewichte" geschrieben werden. Der Satz eines Benutzers wird in Vektoren zerlegt, mit der Gewichtstabelle dieser Schicht multipliziert, um ein Ergebnis zu erhalten, dann durch eine nichtlineare Funktion geleitet und an die nächste Schicht weitergegeben. Je größer das Modell, desto größer die Tabellen, und die Anzahl der Multiplikationen und Additionen in einem Durchgang kann in die Billionen gehen. GPUs sind für diese Art von ordentlicher Multiplikation und Addition gebaut, weshalb Mining-Karten und KI-Karten derselbe Chiptyp sind.
Im Idealfall funktioniert es so. Jemand stellt einem Chatbot online eine Frage, und die Grafikkarte auf dem Server beginnt, das Modell auszuführen, und führt Matrixmultiplikationen Schicht für Schicht durch. Wenn diese Maschine mit Pearls Plugin installiert ist und sein zertifiziertes Open-Source-Modell ausführt, dann werden diese Multiplikationen, während sie eine Antwort erzeugen, auch verwendet, um ihr Glück zu versuchen. Nachdem jeder kleine Block berechnet wurde, wird einmal ein Fingerabdruck gerieben. Wenn der Fingerabdruck klein genug ist, wird ein Lotterielos gewonnen, und der Gewinn bringt die Blockbelohnung. Der Benutzer sieht keinen Unterschied, bekommt immer noch die Antwort, und der Preis könnte sogar etwas billiger sein. Dieselbe Charge von Multiplikationen und Additionen wird auf der einen Seite zu Token und auf der anderen Seite zu Münzen.

Damit dieses System funktioniert, muss es zuerst Betrug lösen. Der Miner hat nur zwei Tabellen in der Hand, und er muss zuerst die Tabellen zu einem Fingerabdruck reiben und ihn einreichen. Sogenanntes Reiben eines Fingerabdrucks bedeutet, alle Zahlen in dieser Tabelle zu nehmen und zusammen einen Hash zu berechnen, der zu einem sehr kurzen Segment komprimiert wird. Erst nachdem die Chain diesen Fingerabdruck gesehen hat, wird sie ihm sagen, welche Zufallszahlen in die Tabellen gemischt werden sollen. Die Reihenfolge ist gesperrt, und es ist zu spät für ihn, die Tabellen zu ändern. Der offizielle Begriff für diese Aktion ist Rauschen hinzufügen. In einfachen Worten bedeutet es, eine Reihe von Zufallszahlen in die beiden Tabellen zu mischen. Wie viel gemischt wird und wo, wird durch diesen Fingerabdruck bestimmt, und der Miner kann es nicht selbst wählen.
Ohne Mischen gibt es eine Abkürzung. Zwischen sauberem A mal B und dem Produkt nach dem Mischen von Zufallszahlen gibt es nur einen Unterschied von drei Korrekturtermen. Diese drei Terme sind in ihrer Größenordnung nicht klein, aber sie sind billig zu berechnen. Der Miner hat bereits sauberes A und B in der Hand, also könnte er vollständig zuerst die saubere Antwort berechnen und dann diese billigen Korrekturterme hinzufügen, um die Antwort mit eingemischten Zufallszahlen zu erzeugen, ohne diese große Multiplikation überhaupt durchzuführen. Es ist wie eine Prüfungsfrage, die nach 3987 mal 2913 fragt, aber der Schüler hat die Antwort bereits auswendig gelernt und setzt ein paar kleine Zahlen zusammen, damit es aussieht, als hätte er ernsthaft gerechnet.
Das Protokoll verlangt also nicht, dass der Miner das berechnete Ergebnis übergibt, sondern nur die Zeilen der Eingabe, die er verwendet hat, plus einen Beweis. Der Verifizierer nimmt diesen Teil, mischt dieselben Zufallszahlen ein, berechnet nur diesen kleinen Block neu und prüft, ob der Fingerabdruck korrekt ist. Die Neuberechnung eines kleinen Blocks ist billig und ausreichend, um zu bestätigen, dass er nicht betrogen hat. Wenn diese Tabellen Firmengewichte oder Benutzerdaten betreffen, kann eine zusätzliche Ebene von Zero-Knowledge-Beweis hinzugefügt werden, um zu beweisen, dass die Berechnung tatsächlich durchgeführt wurde, ohne preiszugeben, welche zwei Tabellen verwendet wurden.

Welchen Schritt hat es jetzt erreicht
Gehen Sie zu Hugging Face und schauen Sie nach; unter der Organisation pearl-ai gibt es vier zertifizierte Modelle: Llama 3.3 70B, Llama 3.1 8B, Qwen3 30B und Gemma 4 31B. Offiziell werden sie „zertifizierte Varianten“ genannt; der Ansatz ist nicht das Neutraining, sondern das erneute Komprimieren desselben Gewichtssatzes in Pearls Quantisierungsformat, damit sie während des Minings im Plugin Inferenz durchführen können. Der Präzisionsverlust ist sehr gering; Gemma 4 31B's MMLU fiel von 90,93 auf 90,56. Stand 9. Oktober 2026 reichten die Downloads dieser vier Modelle in den letzten dreißig Tagen von 195 bis 6.424, und ihre Likes waren 0, 3, 5 bzw. 6.
Es gibt auch einen kommerziellen Auslass. Im Mai 2026 ging Pearl eine Partnerschaft mit Together AI ein, um eine Schnittstelle zum Betrieb des Gemma-Modells zu starten. Laut Together's Ankündigung ist der Aufrufpreis 25 % günstiger als bei gewöhnlichen Schnittstellen, wobei die Differenz durch den zukünftigen Wert der Token ausgeglichen wird.
Die Modelle sind veröffentlicht, der Code ist Open Source, und dann gibt es nichts mehr. Im Juni 2026 testete der Forscher Abhinaba Basu dies in „The Usefulness Gap in Proof-of-Useful-Work“. Laut der Rechenleistung des Netzwerks zu diesem Zeitpunkt von etwa 24 EH/s, entsprechend etwa 320.000 Karten der RTX 3090-Klasse, geschätzter Stromverbrauch von 112 Megawatt, und die nützliche KI-Rechenleistung war null.
Der Autor beprobte 8.012 Miner-Arbeitseinheiten; die gesamte Hardware hatte Inferenzfähigkeit, aber in der Haupt-Mining-Software gab es 4.803 Zeichenketten im Zusammenhang mit Matrixmultiplikation und 0 im Zusammenhang mit Machine-Learning-Frameworks. Er schrieb auch selbst ein Mining-Programm, füllte Tabellen mit Zufallszahlen und führte es erfolgreich auf Nvidia-, AMD-, CPU- und Apple-Chips aus, wobei er vom Mining-Pool anerkannte Shares erhielt, insgesamt 44. Eine Person, die Daten bereitstellt und das Modell das Ergebnis berechnen lässt, und dieselbe Karte zum Mining von Coins verwendet, kann im Design kombiniert werden, aber im tatsächlichen Betrieb sind sie getrennt.
Also, was läuft tatsächlich im Netzwerk. Laut der Seite des Mining-Pools Kryptex ist die Rechenleistung des Netzwerks auf 46,37 EH/s gestiegen, die Schwierigkeit 2,26 TH, die Blockzeit etwa 203 Sekunden, die Blockbelohnung 2.271,03 PRL, die tägliche Ausgabe etwa 966.000 Coins und der Coin-Preis etwa 1,30 $. In sechs Monaten hat sich die Rechenleistung fast verdoppelt, und die überwiegende Mehrheit dieses Anstiegs füllt immer noch Zufallszahlen ein. Was derzeit auf dem Markt gemacht wird, ist hauptsächlich nur diese eine Sache: Karten kaufen, einstecken, Zufallszahlen eingeben, auf die Abrechnung warten.
Welche Probleme gibt es
Stellen wir uns vor, die Cafeteria hängt eine Mitteilung aus: Wer genug hundert Jin Gemüse hackt, kann einen Lohn erhalten. Der Akt des Gemüsehackens selbst ist real; Messerfertigkeiten, Kraft und Zeit müssen alle aufgewendet werden. Aber die Mitteilung prüft nur, ob Sie genug hundert Jin gehackt haben, nicht welches Gemüse Sie gehackt haben. Also bringt jemand einen Wagen voller fauler Gemüseblätter, hackt genug hundert Jin und nimmt den Lohn. Er hat Gemüse gehackt, und er hat wirklich Kraft aufgewendet, es ist nur so, dass die Küche diesen Haufen Blätter nicht verwenden kann.
Pearl steckt jetzt hier fest. Das Protokoll prüft, ob der Fingerabdruck der Tabelle übereinstimmt, ob das Ergebnis wirklich gleich der Multiplikation zweier Tabellen ist, ob die Arbeitslast für die Schwierigkeit ausreicht; im formalen Design gibt es auch ein statistisches Gate, das speziell Eingaben blockiert, die auf einen Blick als manipuliert erkennbar sind. Es prüft all dies. Was es nicht prüft, ist, woher diese beiden Tabellen stammen. Also können Miner vollständig selbst zwei Tabellen mit Zufallszahlen erstellen; die Multiplikation ist genauso schwer, der Fingerabdruck erfüllt genauso den Standard, und sie können genauso gewinnen, außer dass niemand das berechnete Ergebnis verwenden will. Das Protokoll erkennt nur die Multiplikationsbeziehung an, nicht die Semantik; „nützlich“ ist hier eine kommerzielle Frage, keine kryptografische Garantie.
Das ist keine Vermutung. Laut dem zuvor erwähnten Bericht konnten alle beprobten Maschinen Modelle ausführen, dennoch gab es nicht eine einzige Zeile Inferenzcode in der Mining-Software, und die Tabellen, die der Autor selbst mit Zufallszahlen füllte, erhielten ebenfalls vom Mining-Pool anerkannte Shares. Derzeit liegt die Rechenleistung des Netzwerks bei etwa 45 EH/s, und die überwiegende Mehrheit füllt immer noch Zufallszahlen ein.
Die Lücke im Maßstab lässt sich auch so sehen. Das Papier gab ein kontrafaktisches Szenario an: Wenn dieses Design wirklich wie beworben funktionierte, dann hätte das damalige 24 EH/s-Netzwerk etwa 7,7 Millionen GPU-Stunden nützlicher KI-Rechenleistung pro Tag produzieren sollen. Das Papier erwähnte auch einen Indikator namens Wertzerstörungsverhältnis; Pearls gemessener Wert ist 1,0, auf Augenhöhe mit Bitcoin, während Filecoins etwa 0,64 beträgt.
Miner nehmen keine Inferenzaufträge an, nicht weil sie es nicht verstehen, sondern weil sie gerechnet haben. Das Papier schätzt, dass die Kopplung der Inferenz-Engine mit dem Mining etwa 10 % bis 30 % der effektiven Rechenleistung verlieren würde. Das heißt, echte Inferenz anzunehmen erfordert nicht nur eine Änderung der Software und die Anpassung an den Rhythmus der Anfragen, sondern auch den vorherigen Verlust dieses Teils der Rechenleistung. In Jahren, in denen der Coin-Preis nicht hoch ist, wird diese Rechnung leicht negativ.
Wie könnte dies also gelöst werden? Das Papier listet mehrere Wege auf. Einer besteht darin, die Quelle der Tabellen zu verwalten und Miner zu verpflichten, Tabellen zu verwenden, die von externen Kunden eingereicht wurden. Das Plugin und die zertifizierten Modelle, die Pearl offiziell anbietet, gehen derzeit in diese Richtung: Man übergibt das Modell und das Plugin an Miner; man verwendet das echte Modell, um Inferenz auszuführen, und diese Multiplikation schürft bequem auch den Coin. Die Schwierigkeit besteht darin, dass es freiwillig ist; ob man es annimmt, liegt immer noch bei den Minern, die ihre eigene wirtschaftliche Rechnung aufstellen müssen.
Ein anderer Weg besteht darin, zu prüfen, ob die Tabellen wie echte aussehen. Die Gewichte echter Modelle und willkürlich eingefügter Zufallszahlen unterscheiden sich in ihren statistischen Eigenschaften. Aber das Papier selbst lehnte diesen Weg ab: Miner müssen nur die Verteilung anpassen, um die Prüfung zu täuschen, zu nahezu null Kosten. Es gibt auch mehrere weiter entfernte Wege, die noch nicht umgesetzt wurden. Die Modellquelle zu einer verifizierbaren Signatur zu machen, erfordert zuerst ein Public-Key-System für die Modellseite. Vertrauenswürdige Hardware zu verwenden, um die Datenherkunft zu beweisen, erfordert zusätzliches Vertrauen in Chip-Hersteller und wird auch die Dinge verlangsamen. Belohnungen zu differenzieren, etwas mehr für die Verwendung echter Daten zu geben, erfordert zuerst eine Gruppe von Kunden, die wirklich bereit sind zu zahlen.
Pearls Entwickler ist Pearl Research Labs. Omri Weinstein ist Mitbegründer und CEO; dieser Titel stammt aus der Ankündigung der Together AI-Partnerschaft. Er ist Forscher in der Komplexitätstheorie, hat eine Fakultätsposition an der Hebräischen Universität und ist einer der Autoren jenes grundlegenden Papiers.
Ein weiterer Autor, Ilan Komargodski, steht ebenfalls auf der Mitgliederliste der Hugging Face-Organisation; ob seine spezifische Identität Angestellter oder Berater ist, lässt sich aus öffentlichen Quellen nicht belegen. Ein weiterer Name, der zugeordnet werden kann, ist Erez Badash, Erstautor des Hawkeye-Papiers über bitweise Reproduktion auf GPUs.
Bei Bittensor bewerten Validatoren die von Minern eingereichten Modellausgaben, wobei die Bewertung durch einen Konsens namens Yuma bestimmt wird. io mietet GPUs bei Bedarf für Machine-Learning-Aufgaben. Pearl setzt auf eine engere Annahme: Die für die Blockgenerierung verwendete Multiplikation selbst könnte von jemandem gebraucht werden.
Es wird darauf gewettet, dass die Inferenznachfrage groß genug wachsen wird, um die Rechenleistung zur Blockgenerierung zu verbrauchen. Zu diesem Zeitpunkt werden die Miner selbst klar berechnen, dass die Annahme echter Aufträge kosteneffizienter ist als das Einfügen von Zufallszahlen. Wenn dieser Punkt nicht erreicht werden kann, dann ist es nur eine Grafikkarten-Mining-Kette mit geänderter Mathematik; das Berechnete ist homolog zu KI und steht in keinem Zusammenhang mit den Erwartungen eines bestimmten Nutzers.