À dix heures le soir du 13 août, la voiture de la ligne 10 du métro transportait encore la foule persistante de l'heure de pointe du soir. Lin Wei s'accrochait à la poignée suspendue, baissait la tête et faisait défiler son téléphone. Une notification push du monde de la tech attira son attention.
Le titre disait : «
DeepSeek
V4-Pro version officielle publiée, capacités Agent grandement améliorées, prix trois fois celui de la version Flash. » Elle fit glisser le bout de son doigt un peu plus bas. Également publiées le même jour, les mises à jour de Grok 4.6 et
Tongyi Qianwen
Qwen3.8-Max.
« Paramètres, Agent, poids... Je connais chaque mot individuellement, mais quand ils sont mis bout à bout, je n'ai aucune idée de ce qu'ils disent. » Lin Wei a déclaré à l'Institut de recherche Phoenix AI.
Son téléphone a
Doubao
et
DeepSeek
installés, généralement utilisés pour rédiger des rapports hebdomadaires et des comptes rendus de réunion. « Mais ce que ces nouvelles versions ont exactement amélioré, et quel impact elles ont sur moi, je ne peux pas du tout le dire. »
Ce qui la troublait encore plus, c'était une autre nouvelle. Le 17 août,
DeepSeek
les ajustements de prix de l'API sont officiellement entrés en vigueur, introduisant pour la première fois une « tarification heures pleines/heures creuses », avec certaines interfaces connaissant des augmentations allant jusqu'à 1100 % pendant les heures pleines. L'annonce officielle ajoutait spécifiquement une phrase : Cet ajustement ne s'applique qu'aux appels d'interface API ; l'utilisation quotidienne par les utilisateurs ordinaires du web et de l'App reste gratuite.
« Pourquoi l'API est-elle payante, mais l'App est encore gratuite ? » dit Lin Wei. Elle a demandé à quelques amis autour d'elle, et pas un seul n'a pu répondre.
Si nous remontons le temps de trente ans, nous constatons que presque exactement le même scénario se rejoue, sauf que les termes déroutants à l'époque étaient TCP/IP, modems et bande passante.
01 Il y a trente-six ans, Internet était aussi un « livre céleste »
L'Internet du début des années 1990 était un monde appartenant aux geeks, aux universitaires et aux ingénieurs.
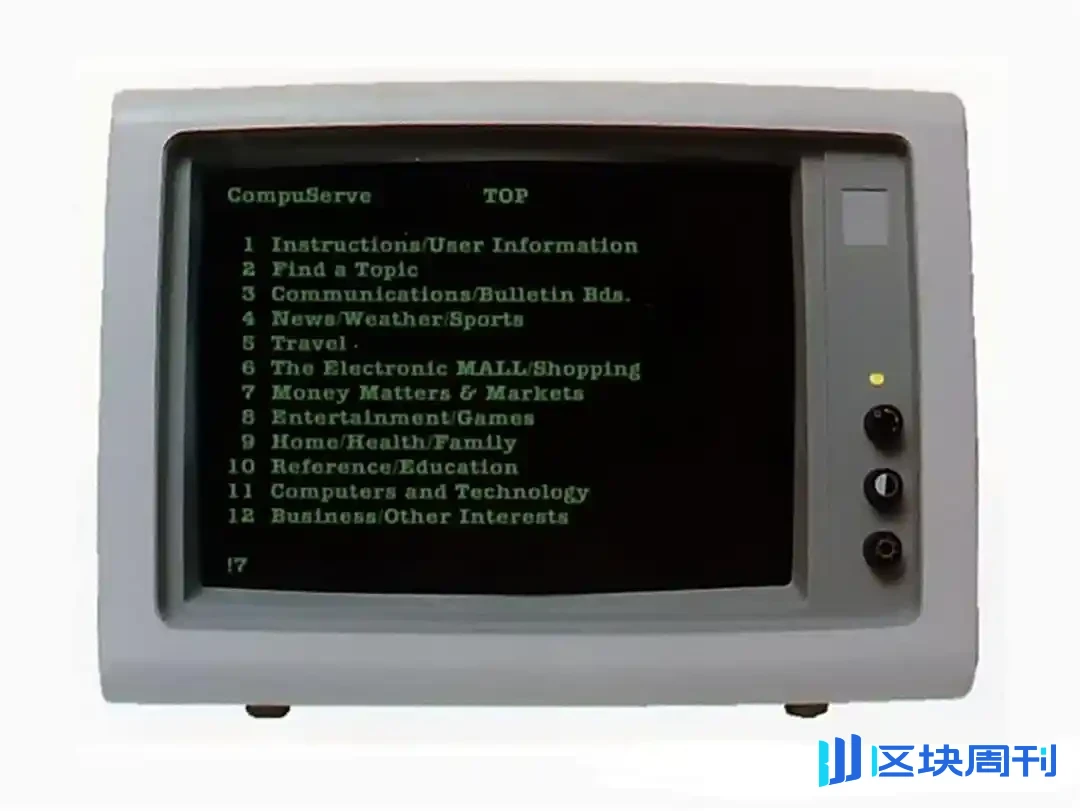
Pour que les gens ordinaires puissent se connecter, ils devaient d'abord comprendre ce qu'était le protocole TCP/IP, savoir comment se connecter par ligne téléphonique, et faire face à une interface en ligne de commande avec des caractères verts sur fond noir.
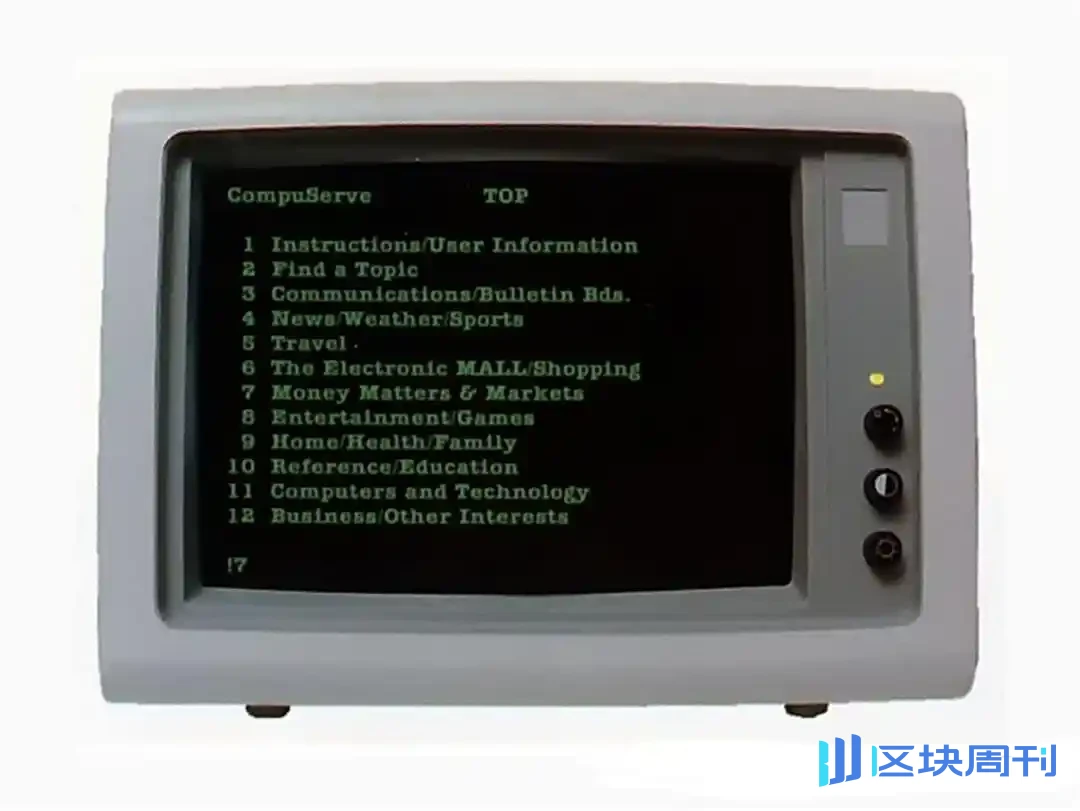
L'image montre l'interface du menu principal en caractères de CompuServe. Source : documents historiques officiels de CompuServe
À cette époque, les services en ligne les plus courants étaient CompuServe et Prodigy. Les interfaces étaient rudimentaires et les opérations fastidieuses. Les utilisateurs devaient se souvenir d'une longue série de commandes pour envoyer et recevoir un e-mail.
Encore plus décourageant était le vocabulaire. Les mots que nous tenons pour acquis aujourd'hui étaient tous un livre céleste pour les gens ordinaires à l'époque.
La bande passante était à l'origine un terme météorologique de 1885, utilisé pour mesurer les ceintures de pluie ; Firewall existait dès 1578, désignant un mur littéral qui bloque le feu ; Online était à l'origine un terme ferroviaire, signifiant « le long de la ligne de chemin de fer ».
Ces mots ont été dépouillés de leurs champs natifs respectifs et ont reçu de force des significations techniques, ce qui, pour les gens ordinaires, ne différait pas d'une autre langue.
Juste à ce moment-là, un jeune homme né à Hawaï est apparu.
Steve Case, qui était impatient avec les cours d'informatique de son école au collège. À ses yeux, « composants, circuits, langage d'assemblage — qu'est-ce que ces choses ont à voir avec moi ? » Ainsi, en 1985, lui et un partenaire ont fondé une société de services en ligne, qui a été officiellement renommée « America Online » (AOL) en 1989.
Case n'a inventé aucune technologie Internet sous-jacente. Il n'a fait qu'une seule chose : empaqueter Internet en un produit que les gens ordinaires pouvaient utiliser.

L'image montre Steve Case. Source : site officiel d'AOL
Son approche semblait presque folle à l'époque. L'ancienne directrice marketing Jan Brandt a rappelé plus tard que ce « tapis de bombes » est passé par deux étapes.

L'image montre une disquette de 3,5 pouces distribuée par AOL. Source : site officiel d'AOL
Lors de la période d'essai de 1993, AOL utilisait encore des disquettes de 3,5 pouces, et le premier lot à lui seul a envoyé plus de 200 000 exemplaires, avec un coût unitaire atteignant 1,19 $.
À mesure que les lecteurs optiques sont devenus standard sur les ordinateurs personnels, AOL est rapidement passé à des CD moins coûteux et de plus grande capacité, et l'échelle de distribution a commencé à croître de façon exponentielle. Des sièges du public du Super Bowl aux emballages de steaks surgelés, chaque coin de la vie nord-américaine pouvait voir ce CD imprimé avec le logo AOL : « Insérez-le dans votre ordinateur et essayez le vrai America Online. »
Plus tard, Brandt a estimé qu'AOL avait cumulativement envoyé plus d'un milliard de disques, et à son apogée, la moitié de tous les disques produits dans le monde portaient le logo AOL.
En termes de coût, AOL dépensait en moyenne 35 $ pour acquérir chaque utilisateur enregistré. Mais cela s'est avéré être une très bonne affaire : la valeur moyenne à vie d'un utilisateur d'AOL atteignait 350 $, exactement dix fois le coût d'acquisition client.
Les disques n'étaient que le point d'entrée ; ce qui retenait vraiment les gens, c'était l'obsession de Case pour une expérience infaillible. AOL a remplacé la ligne de commande par une interface graphique, et a remplacé les configurations de protocole abstraites par des canaux concrets comme « salons de discussion, e-mail, groupes de discussion ». Les utilisateurs n'avaient pas besoin de savoir ce qu'était SMTP — un clic sur [Écrire] et ils pouvaient envoyer un e-mail ; ils n'avaient pas besoin de comprendre ce qu'était IRC — un clic sur [Discuter] et ils pouvaient entrer dans un salon de discussion.
Ce modèle, plus tard appelé le « jardin clos », cachait essentiellement toute la technologie Internet complexe en arrière-plan, ne laissant aux utilisateurs qu'un monde qu'ils pouvaient entrer en double-cliquant.
L'effet de commercialisation a été immédiat. Lorsqu'AOL est entré en bourse en 1992, il ne comptait que 200 000 utilisateurs ; en 1997, il a franchi la barre des 10 millions. À son apogée en 1999, AOL comptait plus de 35 millions d'utilisateurs payants, ce qui signifie que près de la moitié de tous les internautes américains accédaient à Internet via AOL.

L'image montre l'enseigne de la marque devant le siège d'America Online. Source : capture d'écran des médias sociaux
Le chiffre d'affaires d'AOL en 1999 a atteint 4,8 milliards de dollars, avec un bénéfice net de 762 millions de dollars, et sa capitalisation boursière a grimpé jusqu'à 164 milliards de dollars, plus de deux fois la capitalisation boursière d'IBM à l'époque. La même année, AOL est entré pour la première fois dans le Fortune 500, se classant 337e, et était la seule entreprise Internet sur la liste.
En regardant cette histoire, la contribution la plus essentielle d'AOL n'a jamais été d'inventer une technologie Internet particulière, mais d'avoir réalisé une « réduction de dimension cognitive ».
AOL n'a pas essayé d'apprendre aux gens ordinaires ce qu'était TCP/IP ou ce qu'était un modem ; il a simplement permis aux gens de discuter, d'envoyer des e-mails et de jouer à des jeux, et au cours de leur utilisation, ils ont naturellement construit une compréhension d'Internet. Les utilisateurs ont progressivement appris ce que signifiaient « une vitesse Internet lente, une déconnexion, des virus ».
02
L'été après la « frénésie d'acquisition d'utilisateurs » de l'IA en Chine
Plus de trente ans plus tard, les géants chinois d'Internet ont fait quelque chose de similaire au bombardement de disques d'AOL : ils ont utilisé de l'argent réel pour aplatir la barrière à l'entrée, attirant d'abord les utilisateurs à l'intérieur et s'inquiétant du reste plus tard.
Le Festival du Printemps 2026 peut être qualifié de campagne d'éveil à l'IA la plus « gourmande en argent » de l'histoire d'Internet en Chine.

L'image montre
Tencent Yuanbao
Page d'activité du Festival du Printemps. Source : capture d'écran des médias sociaux
Le 25 janvier,
Tencent Yuanbao
a été le premier à annoncer qu'il dépenserait 1 milliard de yuans en enveloppes rouges en espèces, d'une valeur allant jusqu'à dix mille yuans chacune ; Baidu Wenxin a suivi de près avec une campagne d'enveloppes rouges de 500 millions de yuans d'une durée d'un mois et demi ; le 2 février, Alibaba
Qwen
a directement lancé un « plan de régal du Festival du Printemps » de 3 milliards de yuans, avec 2 milliards de yuans en coupons de commande gratuite plus 1 milliard de yuans en espèces, le plus grand investissement dans une campagne du Festival du Printemps de l'histoire d'Alibaba ; ByteDance
Doubao
a simplement intégré l'IA dans le Gala du Festival du Printemps.
Quatre géants, près de 5 milliards de yuans en argent réel, avec un seul objectif : amener plus de gens à ouvrir l'IA et à l'utiliser.
Les données d'acquisition d'utilisateurs étaient suffisamment impressionnantes. Pendant le Festival du Printemps,
Qwen
la fonction « Aide-moi » a été appelée plus de 5 milliards de fois au total, et la participation à la loterie nationale de Yuanbao a atteint 3,6 milliards de fois. Ma Huateng a déclaré sans détour lors d'une réunion interne des employés : il espérait que ce geste pourrait recréer le moment des enveloppes rouges WeChat d'il y a 11 ans.
Un grand nombre d'utilisateurs qui n'avaient jamais utilisé l'IA auparavant ont parlé avec l'IA sur leur téléphone pour la première fois.
Mais après que l'excitation se soit estompée, une réalité gênante a refait surface : beaucoup de gens, après avoir attrapé des enveloppes rouges et utilisé une conversation IA une fois, se sont tournés vers des mots comme « API, GLM, Token, RAG, Agent » et étaient encore complètement perdus.
Ce sentiment de fragmentation — « facile à commencer, difficile à progresser » — a été amplifié à l'extrême dans la compétition mondiale des versions de grands modèles en août 2026.
Le 13 août,
DeepSeek
V4-Pro version officielle lancée, donnant le coup d'envoi de cette vague de mises à jour denses. Dans l'annonce officielle, les points clés de l'amélioration étaient également pleins de divers termes : les capacités d'agent intelligent Agent considérablement renforcées, dépassant de loin la version préliminaire sur les benchmarks d'appel d'outils tels que Terminal Bench et Cybergym ; la profondeur de raisonnement améliorée, prenant en charge la décomposition de problèmes complexes à chaîne plus longue ; le prix de l'API a également augmenté, le prix d'entrée de la version Pro étant 3 fois celui de la version Flash et la sortie 2,5 fois, et pendant les heures de pointe, une tarification heures pleines/heures creuses avec une augmentation maximale de 1100 % serait mise en œuvre.
Presque le même jour, Grok 4.6 de Musk et
Tongyi Qianwen
Qwen3.8Max d'Alibaba ont été publiés et mis à jour l'un après l'autre. Au cours des vingt jours suivants, 11 grands modèles de pointe dans le monde, y compris ClaudeSonnet5 d'Anthropic, GLM-5.3 de Zhipu et Llama4Scout de Meta, ont été officiellement annoncés de manière密集, avec de nouvelles versions déferlant sur les écrans presque tous les un ou deux jours.
Dans les gros titres des médias spécialisés, des expressions comme « nouveau sommet de référence », « saut de capacité » et « innovation de paradigme » sont apparues les unes après les autres, et toute la filière était immergée dans l'excitation d'une avancée technologique rapide.
Mais du point de vue d'un utilisateur ordinaire, cette vigoureuse compétition de versions ressemble davantage à un « carnaval derrière une vitre ».

L'image montre
DeepSeek
-V4-Pro annonce de lancement de la version officielle. Source de l'image :
DeepSeek
compte officiel
Les capacités essentielles de ces mises à niveau sont presque toutes concentrées dans des dimensions que les utilisateurs ordinaires ne peuvent pas percevoir.
DeepSeek
Les principales fonctionnalités de V4-Pro — invocation d'outils Agent, exécution de code et raisonnement multi-étapes — sont principalement diffusées auprès des développeurs et des clients entreprises via des interfaces API. Du côté de l'application pour les utilisateurs ordinaires, il n'y a qu'une amélioration limitée de l'expérience dans le mode « réflexion profonde », et la différence perçue dans les conversations quotidiennes ou la rédaction de rapports hebdomadaires est minime.
Même la capacité « Computer Use » renforcée dans ClaudeSonnet5, qui permet à l'IA d'exploiter directement des logiciels informatiques et d'exécuter des tâches inter-applications, est également prioritairement destinée aux appelants d'API. Le point d'entrée du côté utilisateur individuel est caché dans un menu de troisième niveau, et la grande majorité des gens ne savent même pas qu'il existe.
En d'autres termes, les capacités essentielles que l'industrie s'efforce d'itérer sont pour la plupart enfouies « sous la boîte de dialogue », cachées dans les interfaces API, les outils de développement et les solutions d'entreprise.

L'image montre des commentaires de internautes. Source de l'image : capture d'écran de médias sociaux
Sur les plateformes sociales, cette anxiété de « la technologie qui court en avant tandis que les gens la poursuivent » est partout. Certains internautes ont commenté avec émotion : « De nouveaux modèles d'outils d'IA sortent chaque jour, et je suis tellement anxieux que je ne peux pas les apprendre à temps » ; un internaute de 35 ans a même déclaré sans détour : « Époque, cours plus lentement et emmène-moi avec toi. »

L'image montre du contenu de vulgarisation scientifique lié au « jargon de l'IA ». Source de l'image : capture d'écran de médias sociaux
Lorsqu'on recherche « jargon de l'IA » sur les plateformes sociales, des centaines ou des milliers de publications de vulgarisation scientifique ciblées apparaissent : « Maîtrisez rapidement le jargon de l'IA en cinq minutes », « Expliquez Agent, Skill, Token en langage simple », « Comprenez 15 concepts d'IA en une seule image ». De LLM, MCP, Harness à RAG, Workflow, derrière presque chaque terme à la mode de l'industrie se tient tout un groupe de créateurs qui font de la « traduction terminologique ».
L'existence de la niche de la « vulgarisation du jargon de l'IA » reflète que le seuil terminologique n'a pas été éliminé par les produits, mais déplacé vers les utilisateurs.

L'image montre le « Manuel pratique pour les opérations sur Internet par ordinateur » publié en 2004. Source de l'image : Baidu Baike
Tout comme dans les années 1990, si tout le monde pouvait facilement accéder à Internet, les kiosques à livres ne seraient pas remplis de « Introduction à la connexion Internet par modem » et de « Manuels pratiques d'Internet ». Lorsqu'un domaine technique a besoin d'une grande quantité de vulgarisation scientifique tierce pour combler le fossé cognitif, cela montre précisément que son encapsulation produit est encore loin du seuil de passage pour les gens ordinaires.
03 Le gros livret terminologique a déjà commencé à laisser passer la lumière
Mais en septembre 2026, lorsque OpenAI a publié GPT-6Astra, il a diffusé une vidéo promotionnelle qui a permis à beaucoup de gens d'entrevoir une autre possibilité.

L'image montre une scène de la vidéo promotionnelle de GPT-6 Astra. Source de l'image : site officiel d'OpenAI
Dans la vidéo, une personne dit à l'ordinateur : « Transforme ce cercle jaune en fusée, puis fais-en un jeu 3D. » Quelques minutes plus tard, un jeu 3D qui peut être déplacé avec les touches fléchées, accéléré avec la barre d'espace et qui esquive des astéroïdes apparaît à l'écran.
Ensuite, il dit : « J'ai un peu faim. Peux-tu m'aider à commander le riz au bœuf de cet endroit de la semaine dernière ? » L'IA ouvre directement l'application de livraison de repas et finalise la commande.
La raison pour laquelle cette vidéo a suscité des discussions animées sur tout Internet n'est pas principalement que l'IA peut écrire du code, mais qu'elle démontre un tout nouveau paradigme d'interaction : vous n'avez pas besoin de savoir ce qu'est un moteur de jeu, ce qu'est un appel API, ce que sont le frontend et le backend, ni même le terme « Agent ». Vous avez seulement besoin de décrire ce que vous voulez en langage naturel, et l'IA accomplit tout le reste en arrière-plan.
Le mur terminologique qui se dressait autrefois entre les gens ordinaires et les capacités avancées a été complètement aplati ici.
Ce n'est pas une exploration propre aux marchés étrangers. Sur le plan national, les mêmes tentatives de productisation ont déjà discrètement commencé au-delà de la boîte de dialogue, et les fissures s'étendent lentement le long des bords de l'« encapsulation des capacités ».

L'image montre
Kimi
Image du programme Global Ambassador Source :
Kimi
site officiel
En juillet 2026, Moonshot a lancé le «
Kimi
Programme des ambassadeurs mondiaux », allant à l'encontre de la convention du secteur qui consiste à « d'abord ouvrir les API et tester avec les développeurs », et recrutant plutôt des responsables d'expérience parmi les utilisateurs ordinaires du monde entier, en donnant la priorité à la validation des expériences de tâches de bout en bout.
Tongyi Qianwen
L'entrée intelligente « Aidez-moi » mise à niveau en 2026 encapsule entièrement la planification multi-plugins et les opérations inter-applications derrière la conversation. Les utilisateurs peuvent accomplir l'organisation des e-mails, la synchronisation des calendriers et la rédaction de rapports hebdomadaires avec une seule instruction, tandis que l'orchestration des flux de travail sous-jacents et l'authentification API restent totalement invisibles pour les utilisateurs.
ByteDance
Doubao
L'assistant de programmation itéré en 2026 encapsule la génération de code, le traitement par lots Excel et la création simple de pages web—qui nécessitaient à l'origine un environnement de développement—dans des outils pouvant être invoqués en langage naturel, permettant aux employés de bureau ordinaires de s'y mettre sans aucune expérience en programmation.
Ces tentatives restent limitées à des scénarios spécifiques et sont loin d'atteindre une encapsulation infaillible de toutes les capacités, mais le signal est déjà suffisamment clair : une véritable adoption de masse ne consiste pas seulement à rendre la couche de la boîte de dialogue conviviale, mais aussi à encapsuler le épais livre de terminologie au-delà de la boîte de dialogue, couche par couche.
Cette voie a été maintes fois vérifiée dans l'histoire de la technologie.

L'image montre les icônes de l'Apple Macintosh Source de l'image : Exposition Susan Kare
En 1984, l'Apple Macintosh a encapsulé la ligne de commande DOS dans un bureau et des icônes. Les icônes en pixels conçues par la designer Susan Kare—telles que les dossiers, les corbeilles et les montres—permettaient aux utilisateurs non techniques de deviner les fonctions visuellement : cliquez sur un dossier pour ouvrir un fichier, faites-le glisser vers la corbeille pour le supprimer.
En 1998, Google a encapsulé la théorie complexe de la recherche d'informations dans une boîte de recherche vide. Les utilisateurs n'avaient pas besoin de comprendre la syntaxe de requête booléenne ni de savoir ce qu'était l'algorithme PageRank ; saisir des mots-clés donnait des réponses triées. Les robots d'exploration, l'indexation, le classement et les clusters de serveurs étaient tous cachés derrière cette boîte.
En 2007, l'iPhone a encapsulé tout le système d'exploitation dans une pièce de verre. Les utilisateurs n'avaient pas besoin de savoir ce qu'était un système de fichiers ou la gestion des processus ; en tapant, glissant et pinçant avec un doigt, ils pouvaient utiliser toutes les fonctions. Les claviers, les stylets et les hiérarchies de menus ont tous disparu.
Chaque fois, c'était une entreprise qui simplifiait activement la technologie, plutôt que d'attendre que les utilisateurs deviennent plus intelligents.
Dans trois à cinq ans, lorsque nous regarderons aujourd'hui en arrière, l'expression « appeler une API » pourrait être remplacée par « connecter un port », aussi naturel que de dire aujourd'hui « se connecter au Wi-Fi, charger ».
Des termes comme « Agent, RAG, Token » pourraient rejoindre « Internet commuté, modem » en tant que vocabulaire archaïque n'apparaissant que dans les publications nostalgiques.
D'ici là, personne ne demandera « Que faire si je ne comprends pas l'IA ? » car l'IA sera déjà comme l'électricité—vous n'avez pas besoin de comprendre comment fonctionne un générateur ; appuyez sur l'interrupteur et la lumière s'allume.
Cet article provient du compte public WeChat « Phoenix Finance », auteur : Phoenix AI Research Institute