W skrócie
- Anthropic wypuścił Claude Sonnet 5.5 w poniedziałek w cenie 2 dolarów za milion tokenów wejściowych i 10 dolarów za milion tokenów wyjściowych — bez zmian względem Sonnet 5 i o połowę taniej niż Opus 5.5.
- Sonnet 5.5 uzyskał 70,6% w Terminal-Bench 4.0 w porównaniu do 66,4% dla Opus 5.5, według Anthropic; niezależny tester Artificial Analysis również umieszcza go z przodu, 63,6% do 59,6%.
- Artificial Analysis klasyfikuje go na drugim miejscu za Opus 5.5, ale twierdzi, że zużył więcej tokenów na zadanie niż jakikolwiek testowany przez niego model.
Anthropic wypuścił Claude Sonnet 5.5 w poniedziałek, aktualizację do Sonnet 5 z czerwca. Anthropic twierdzi, że ten model średniego poziomu działa ponad 30% szybciej niż jego poprzednik.
„Sonnet 5.5 jest najsilniejszy w dobrze określonych codziennych zadaniach, naprawianiu błędów i tworzeniu dopracowanych dokumentów, slajdów i arkuszy kalkulacyjnych. Ma także bystre oko do designu” — napisał Anthropic.
Cena pozostaje na poziomie 2 dolarów za milion tokenów wejściowych i 10 dolarów za milion tokenów wyjściowych. Tokeny to fragmenty tekstu, które AI czyta i zapisuje, nieco krótsze niż słowo, a firmy rozliczają się za milion. To połowa tego, co pobiera Opus 5.5. Jednak zużywa prawie o jedną trzecią mniej tokenów na zadanie, co oznacza, że ostatecznie jest tańszy w eksploatacji niż Sonnet 5.
To powiedziawszy, ten model błyszczy w kodowaniu. W Terminal-Bench 4.0 — teście sprawdzającym, czy agent AI potrafi samodzielnie ukończyć złożone zadania zawodowe, wpisując polecenia, ocenianym jako odsetek ukończonych zadań — Sonnet 5.5 osiągnął 70,6%. Opus 5.5 uzyskał 66,4%, a Sonnet 5 zdołał osiągnąć 10,3%.
Mówiąc wprost, tańszy model ukończył więcej zadań. Artificial Analysis, niezależna firma testująca, przeprowadziła własną wersję i się zgadza: 63,6% dla Sonnet 5.5, 59,6% dla Opus 5.5 i 59,1% dla GPT-6 Astra od OpenAI.
Claude Sonnet 5.5 (max) robi duże postępy w Terminal-Bench, plasując się wśród najlepszych modeli zarówno w Terminal-Bench 4.0, jak i Terminal-Bench-Science. W Terminal-Bench 4.0 uzyskuje 64%, co stanowi wzrost o 50 punktów w porównaniu z Claude Sonnet 5 (max) i nieco powyżej 60% dla Opus 5.5 i GPT-6… pic.twitter.com/7CPrhgmfxe
— Artificial Analysis (@ArtificialAnlys) 28 września 2026
Wyniki zależą również od ustawienia wysiłku, pokrętła, które sprawia, że model myśli dłużej, aby uzyskać lepszą odpowiedź i większy rachunek. Anthropic twierdzi, że Sonnet 5.5 przy wysokim wysiłku dorównuje GPT-6 Sol na FrontierCode za około jedną piątą kosztu na zadanie.
W GDPval-AA, który ocenia rzeczywistą pracę zawodową w 44 zawodach za pomocą Elo—systemu w stylu szachowym, który szereguje względne umiejętności—Sonnet 5.5 uzyskał 1844 punkty, a Opus 5.5 1846, co w praktyce oznacza remis. GPT-6 Sol uzyskał 1487.
Rywale dorównują cenie. OpenAI obniżył cenę GPT-6 Sol do 2 i 10 dolarów w zeszłym tygodniu, a GPT-5.6 Terra, jego model średniej klasy, jest wyceniony na 2 i 12 dolarów. Anthropic nie opublikował żadnych benchmarków Terra.
Haczyk
Sonnet 5.5 jest bardzo gadatliwy. Przy maksymalnym wysiłku napisał około 193 000 tokenów na zadanie testowe, najwięcej, ile zmierzył Artificial Analysis, i około 60% więcej niż Opus 5.5. Dało to 7,60 dolara na zadanie, około 50% więcej niż Sonnet 5, co przeczy twierdzeniu Anthropic o oszczędnościach do 30%.
Oszczędności Anthropic pochodzą z niższych ustawień: przy średnim wysiłku, domyślnym w jego aplikacjach, twierdzi, że Sonnet 5.5 bije najlepszy wynik kodowania Sonnet 5 za mniej niż jedną dziesiątą kosztu. Artificial Analysis twierdzi, że wysoki wysiłek to najlepszy stosunek jakości do ceny. Dla codziennych użytkowników oznacza to kodowanie niemal flagowe za ułamek ceny, o ile pokrętło pozostaje nisko.
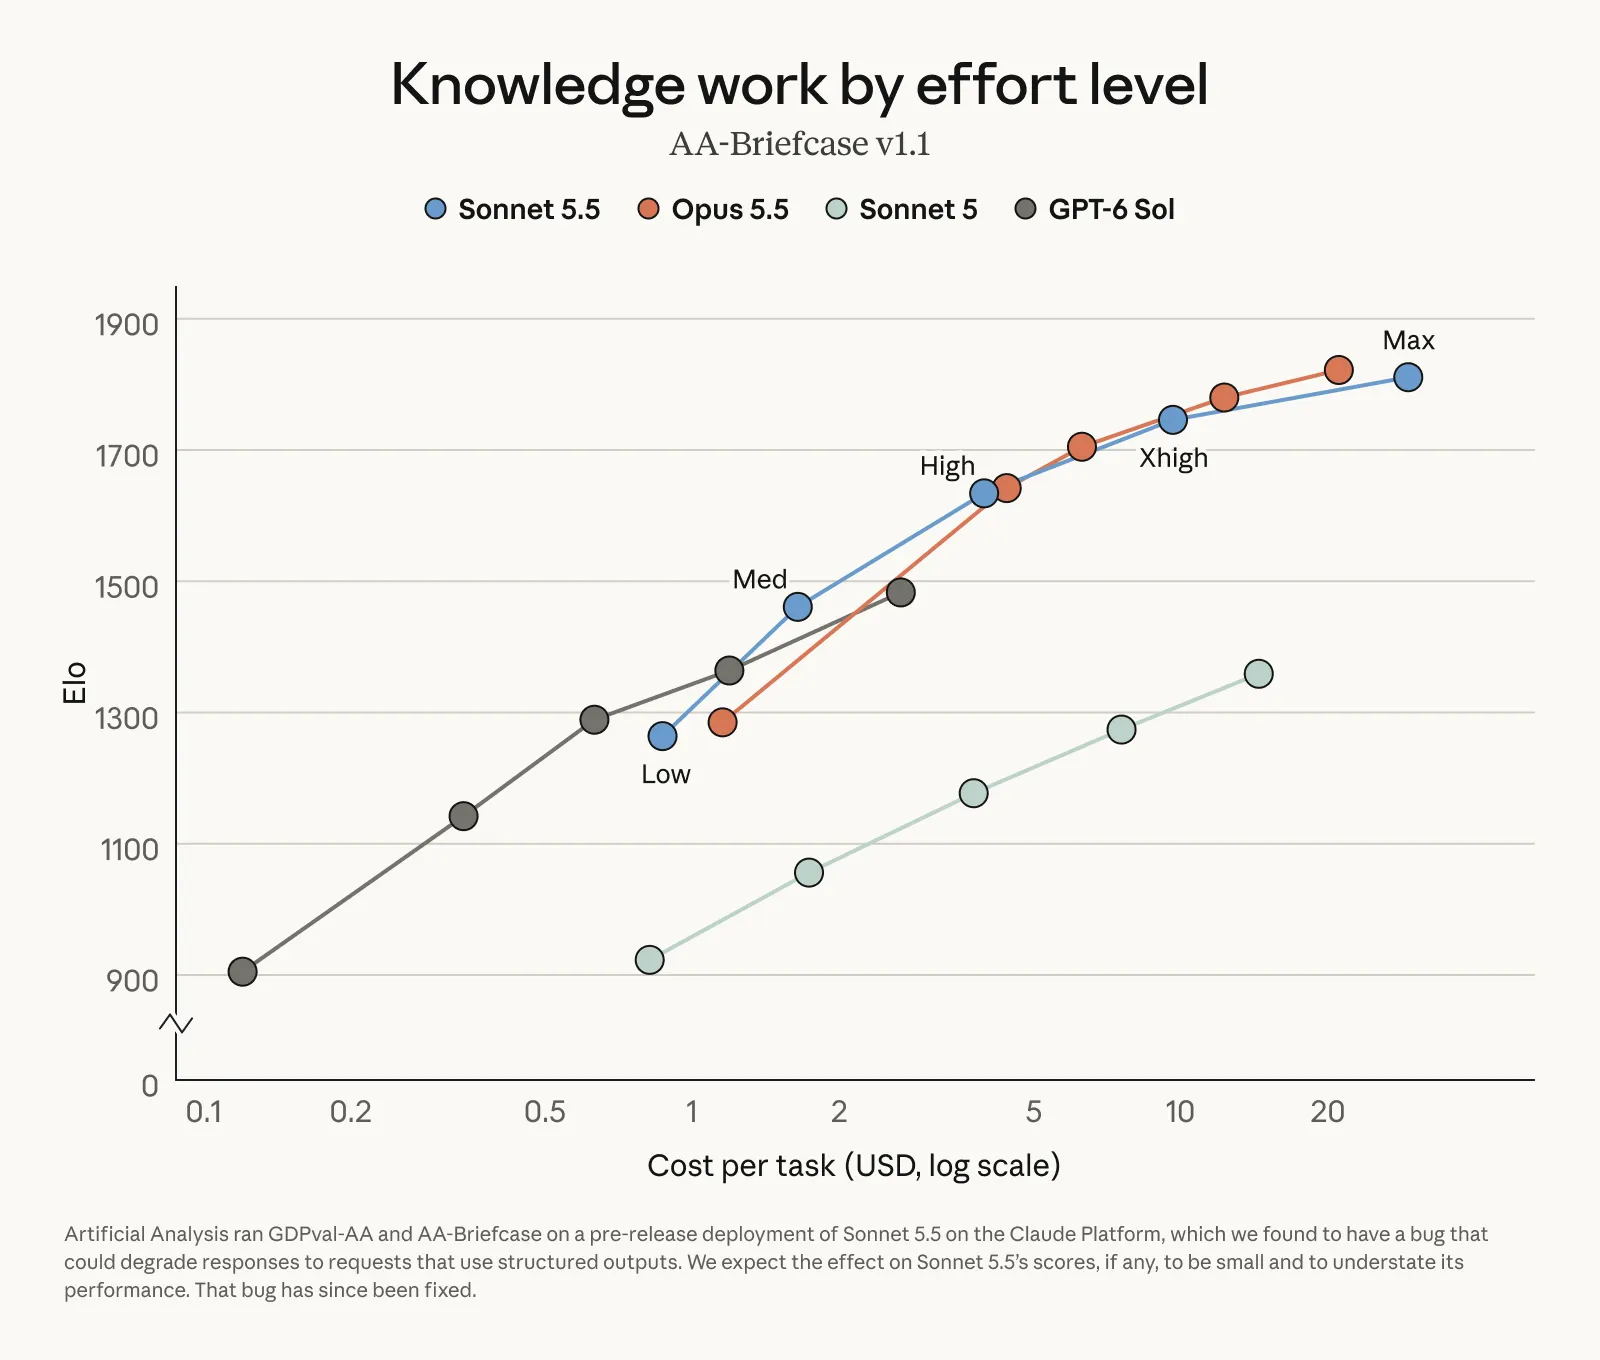
Tabela Anthropic jest oparta na własnych deklaracjach, a Artificial Analysis przetestowało wersję przedpremierową z błędem, który według Anthropic zmienił wyniki w niewielkim stopniu lub nieco je zaniżył. Anthropic twierdzi, że Opus 5.5 pozostaje wyraźnie silniejszy w złożonej pracy wymagającej trwałego osądu.
Claude Haiku 5.5, stworzony do zastosowań o dużej skali i wrażliwych na koszty, ma pojawić się w nadchodzących tygodniach.