ИИ-математика пересекает очень тонкую разделительную линию.
Раньше мы спрашивали: может ли большая модель решить сложную задачу? Может ли она написать строгое доказательство? Может ли она найти контрпример, который люди не обнаруживали десятилетиями?
Теперь возник вопрос, больше похожий на «само исследование»: после того как маршрут доказательства терпит неудачу, знает ли ИИ, что делать дальше? Должен ли он продолжать вычисления, переключить маршрут, сузить утверждение или просто предложить новую, опровержимую математическую гипотезу?
AI Has Taste, созданный исследователем Зенгом Цзыцзянем из UCSI University, пытается превратить этот вопрос в устойчивую исследовательскую систему.
В публичном репозитории проекта в настоящее время зафиксировано 453 математических исследовательских рукописи и 2312 страниц контента, из которых 6 явно классифицированы как «гипотезы, предложенные ИИ».
Позиционирование, указанное на главной странице репозитория, ещё более прямое: от генерации ответов к генерации исследовательских повесток — от генерации ответов к генерации исследовательских повесток.
ИИ опроверг гипотезу в статье, и оригинальный автор подтвердил это ответом
AI Has Taste возник не из убеждения, что «ИИ обязательно должен быть хорош в математике». Зенг Цзыцзянь вспоминает, что в начале проекта он не был уверен, смогут ли большие модели действительно продвинуть математические исследования. Случайный тест стал поворотным моментом: он напрямую передал гипотезу из статьи ИИ, изначально просто желая посмотреть, как далеко может зайти модель. В результате ИИ не продолжил «доказывать» в соответствии со статьёй, а построил контрпример, который напрямую опроверг гипотезу.
Его первой реакцией было не волнение, а недоверие. Поэтому он организовал контрпример и вывод и написал автору оригинальной статьи для проверки. Полученный впоследствии ответ подтвердил: этот контрпример верен. Соответствующее исследование позже было включено в число текущих более чем 450 математических рукописей.
«Сначала я не верил в силу ИИ в математике. Пока я не ввёл гипотезу из статьи, и ИИ сразу дал контрпример, чтобы опровергнуть её; я немедленно написал оригинальному автору, и другая сторона ответила, подтвердив, что это правильно. После этого я действительно отпустил и пошёл ва-банк». — Зенг Цзыцзянь
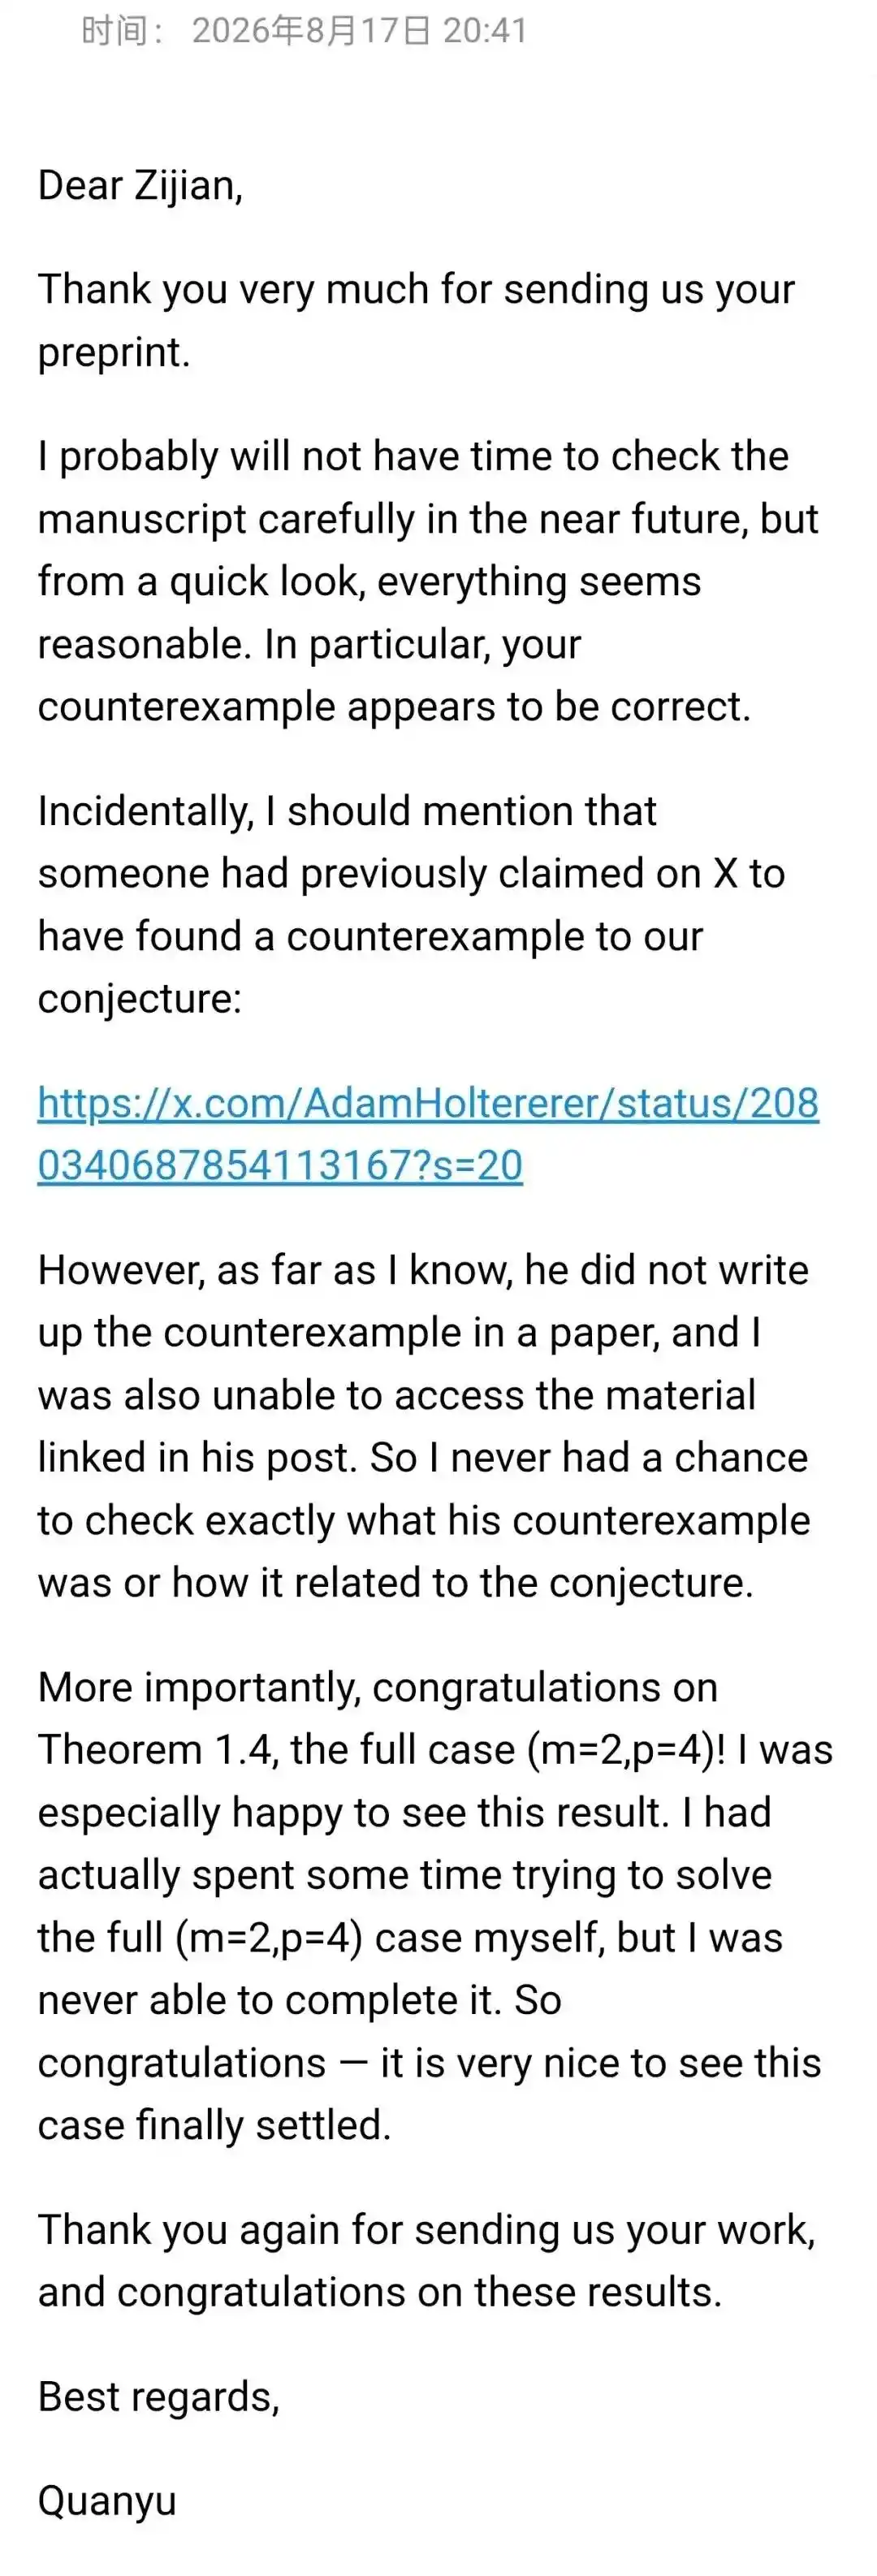
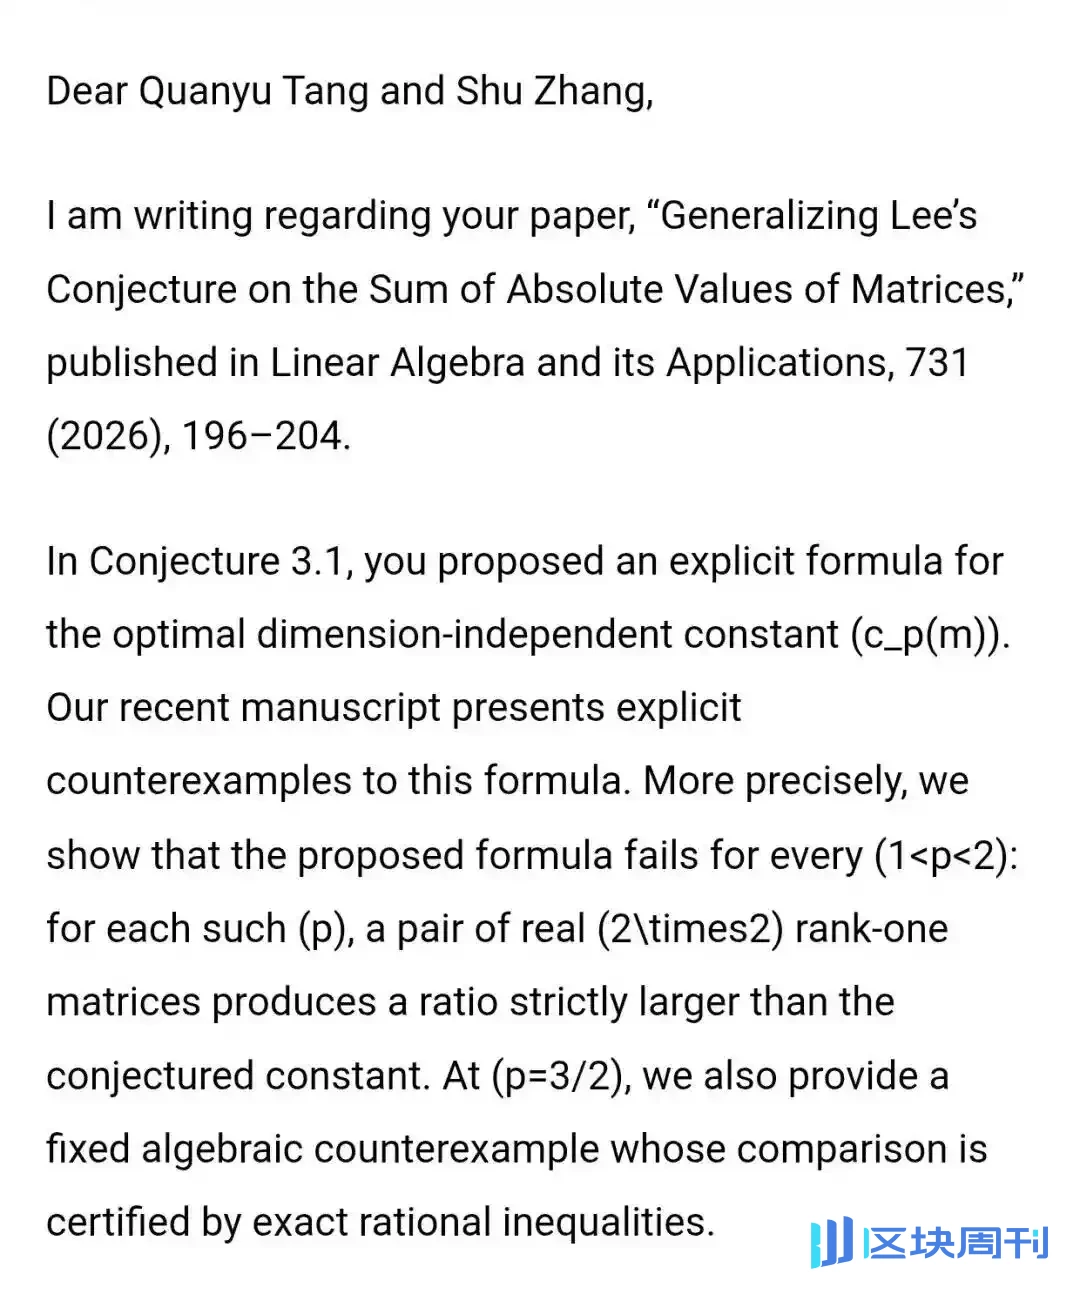
Это письмо изменило не отдельную гипотезу, а масштаб проекта. Если ИИ может не только пересказывать известные знания и генерировать текст, похожий на доказательство, но и активно атаковать новые гипотезы в статьях и находить контрпример, подтверждённый оригинальным автором, то у него есть шанс действительно войти в «исследовательский цикл». После этого Зенг Цзыцзянь начал постепенно агентифицировать выбор темы, доказательство, поиск контрпримеров, управление неудачами, независимую проверку и написание, и позволил разным машинам работать параллельно в долгосрочной перспективе.
Настоящее изменение — не «сколько статей было написано»
Если смотреть только на количество, 453 рукописи уже достаточно привлекают внимание. Но если понимать этот проект только как «ИИ пишет математические статьи партиями», то упускается самая примечательная часть.
Сам проект неоднократно подчёркивает: 453 — это количество «исследовательских рукописей», что не равно решению всех 453 исходных открытых задач. Результаты включают полные доказательства, контрпримеры, частичные результаты, сертификаты конечных вычислений, структурированные сведения и статьи, предлагающие новые гипотезы. Внутренняя проверка ИИ также не равна внешнему рецензированию.
Настоящее изменение происходит в исследовательской цепочке. Традиционные бенчмарки ИИ часто исходят из того, что «задача уже дана»: человек выбирает тему, ИИ решает её, и в конце есть успех или неудача. AI Has Taste расширяет процесс как вперёд, так и назад — ИИ может отбирать задачи-кандидаты, сравнивать маршруты и активно искать контрпримеры; после неудачи маршрута он также может проанализировать структуру неудачи, изменить утверждение и передать новые математические объекты другому независимому агенту для продолжения атаки.

Ключ AI Has Taste не в «большем количестве подсказок», а в превращении неудачи во входные данные для следующего раунда исследований.
Агенты выбора темы, доказательства, поиска ошибок и написания
Эта система — не «одна модель, которая спрашивает и отвечает сама себе в одном диалоговом окне». Публичный README разделяет роли агентов на четыре уровня:
Supervisor / Screener отвечает за отбор кандидатов, сравнение близких результатов и поиск самого дешёвого решающего эксперимента;
Researcher отвечает за доказательства, контрпримеры и точные вычисления;
Fresh-context Reviewer специально атакует замороженные утверждения, ключевые леммы и сертификаты в новом контексте;
Writer / Release Checker отвечает за чёткое написание окончательно принятой области и проверку цитирований, сборок и материалов выпуска.
Цзэн Цзыцзянь далее развернул рабочий процесс как много машинное сотрудничество: разные машины могут отдельно продвигать доказательства, искать контрпримеры, выполнять точные вычисления и проводить независимую проверку. Общими являются замороженные утверждения, записи экспериментов, причины неудач, код и доказательства, а не позволение одному агенту генерировать результаты и самому ставить печать одобрения.

Ядро дизайна мультиагентности: разделение ролей + общие доказательства + проверка в свежем контексте.
В репозитории есть фраза, которая очень хорошо подытоживает этот дизайн: Критика — это часть двигателя, а не послесловие. Критика — это не процедура, добавленная после написания статьи, а часть исследовательского двигателя.
Математики, робототехники и специалисты по автоматизации входят в цепочку проверки
По мере того как исследовательские рукописи выросли с десятков до сотен, другой вопрос стал острее: кто судит, что эти выходные данные агентов не являются систематическими галлюцинациями?
AI Has Taste внутренне использует Fresh-context Reviewer, чтобы разделить «исследование» и «поиск ошибок», но проект не рассматривает самопроверку ИИ как конечную точку.
По мере продвижения работы Цзэнцзайцзянь также начал приглашать реальных учёных из разных областей участвовать в проверке, рецензировании и академическом обсуждении некоторых результатов.
По словам команды проекта, сотрудники и рецензенты, участвующие в части работы, включают: Онг Сенг Хуат, член Академии наук Малайзии и почётный профессор Института математических наук Университета Малайи; Курунатан Ратнавелу, член Академии наук Малайзии и почётный профессор Института математических наук Университета Малайи; и профессор Сюн Юнхуа из Школы искусственного интеллекта и автоматизации Китайского университета геонаук (Ухань).
Здесь необходимо различать «участие в проверке» и «одобрение всех результатов»: вышеупомянутые учёные не подписывались под всеми 453 рукописями по отдельности, а скорее проверяли, рецензировали или обсуждали некоторые проблемы, доказательства, вычислительные результаты или направления исследований.
Для высокоавтоматизированной системы научных исследований такое сочетание «внутренней машинной red team + выборочных проверок/рецензирования человеческими экспертами», напротив, более критично, чем передача всего рецензирования одному и тому же набору агентов.
ИИ отвечает за доведение скорости исследований до предела; человеческие эксперты отвечают за то, чтобы на ключевых узлах вернуть «выглядит корректным» к «заслуживает доверия».
После неудачи был выбран лучший вопрос
Случай в проекте, который лучше всего воплощает «исследовательский вкус», — это как раз не красивый успех, а неудача.
В задаче о дробном гауссовом следе система изначально попробовала маршруты монотонности и одностороннего спаривания, но точные контрпримеры продолжали появляться. Обычный бенчмарк обычно оставил бы здесь только одну метку: FAILED.
Но этот рабочий процесс не остановился. Агент продолжал спрашивать: что именно сломал контрпример? Имеет ли неудача устойчивую структуру? В конце концов исследование переключило внимание на фиксированный отрицательный дефект, построило структуру поправки из десяти членов и предложило новую унифицированную гипотезу ограниченности. Что ещё важнее, новая гипотеза затем была по очереди атакована ещё одним раундом точных вычислений и независимого рецензирования. Публичное сканирование архива достигло индекса 1004; эта унифицированная граница до сих пор не доказана.
Значение этого дела не в том, что «ИИ доказал ещё одну большую теорему» — на самом деле, нет. Значение в том, что: исходная проблема не была решена, но неудачный маршрут был сжат в новое утверждение, которое яснее, более фальсифицируемо и, если оно выполняется, может снова соединиться с исходной проблемой. Исследование не прекратилось на неудаче, а вырастило следующую проблему из неудачи.
Раньше: люди ставили задачи, ИИ отвечал на них. Теперь: ИИ отвечает на задачи и также начинает участвовать в решении «какой будет следующая задача».
6 новых гипотез ИИ
По состоянию на текущий публичный снимок репозиторий отдельно классифицирует 6 статей в разделе «Гипотезы, предложенные ИИ». Эти работы охватывают комбинаторику, теорию графов, теорию чисел и задачи аналитического типа, включая невырожденность бесконечных бинарно-ядерных матриц для трёх подпоследовательностей A182510, CDS-раскрашиваемость диаграмм Юнга, разложение свободных от треугольников графов с максимальной степенью не более 6, формулы унарно-тета сравнений для 18-цветных обобщённых разбиений Фробениуса, неотрицательность коэффициентов Ньютона для знаменателей обратных подсумм на диадических этапах и вышеупомянутую гипотезу фиксированного дефекта для дробного гауссова следа.
Что действительно заслуживает внимания, так это не то, может ли ИИ «набросать гипотезу». Случайно угадать одно предложение нетрудно. Трудно записать гипотезу в точное определение, объяснить, откуда она берётся, какие свидетельства её поддерживают, какие контрпримеры могли бы её опровергнуть, к каким результатам она приведёт, если выполняется, и оставить вычисления и исходный код для последующего рецензирования.
Именно поэтому проект рассматривает «предложение гипотез» как исследовательское действие более высокого уровня, чем «генерация ответов»: доказательства отвечают на существующие вопросы, тогда как гипотезы меняют то, куда направляются последующие исследовательские ресурсы.
За 453 рукописями стоит прототип «научных исследований масштаба агентов»
AI Has Taste в настоящее время публично выпустил 453 исследовательские рукописи общим объёмом 2312 страниц; среди них только рабочий процесс BigWIN2 соответствует 223 рукописям и предоставляет для этих 223 работ парные пакеты материалов LaTeX/воспроизведения.
Самое противоречащее интуиции в этом масштабе не то, что «ИИ быстро печатает». Что действительно дорого в математических исследованиях — это переключение контекста: эта задача требует теории графов, следующая — теории чисел, а следующая может потребовать SAT, полного перебора, точной рациональной арифметики или матричных вычислений. Человеческий исследователь не может одновременно поддерживать сотни совершенно разных линий мысли, но агентная система может разделить их на независимые задачи и сохранить неудачные маршруты, локальные теоремы и воспроизводимые эксперименты.
Таким образом, роль отдельного исследователя меняется: не выводить лично каждый шаг, а скорее быть похожим на PI — устанавливать границы исследований, выбирать пул задач, решать, какие результаты стоит продолжать финансировать, когда остановиться и какие выводы достойны публикации.
Почему это называется «У ИИ есть вкус»?
«У ИИ есть вкус» звучит очень антропоморфно, но README проекта намеренно устанавливает границу: вкус здесь — это не сознание или субъективный опыт, а «математическое суждение, выраженное через исследовательские решения».
Например: если обе задачи можно решить, какую из них выбрать первой? У маршрута уже есть локальный прогресс, но предельная отдача становится всё ниже и ниже — стоит ли останавливаться? Является ли контрпример смертным приговором для утверждения или он показывает, что настоящую теорему следует сформулировать иначе? Достаточно ли малого результата, чтобы он мог существовать как отдельная статья? Эти решения обычно были неявными в опыте исследователей в прошлом и с трудом поддавались измерению стандартными бенчмарками.
AI Has Taste пытается оставить проверяемый след этих решений: какая задача была выбрана, почему маршрут был изменён, какую структуру оставил после себя провал, откуда взялось следующее утверждение и как новый вывод снова был атакован независимым контекстом.
Насколько это далеко от «автономного математика»?
Место, где этот проект легче всего преувеличить, также нужно прояснить. 453 рукописи — это не 453 журнальные статьи, прошедшие формальное рецензирование; внутреннее рецензирование агентом не эквивалентно независимому рецензированию математическим сообществом; и охват, покрываемый конечными вычислениями, не может автоматически обобщаться на бесконечный случай. Сам репозиторий явно указывает эти ограничения.
Но если игнорировать его способ организации исследований только потому, что эти результаты не все прошли внешнюю проверку, можно также упустить ещё одно изменение: граница возможностей ИИ смещается от «выполнения заданной задачи» к «участию в проектировании следующей задачи».
По-настоящему дефицитными ресурсами в математических исследованиях никогда не были только вычислительная мощность и длина рассуждений, но также: какие задачи стоит тратить время, какие неудачи стоит сохранять и когда следует сменить тему.
Когда ИИ начинает входить в эти звенья, конкуренция в «AI for Math» перестаёт быть просто «кто лучше доказывает», а постепенно становится: у кого лучше исследовательский цикл и кто может из большого числа неудач извлечь направления, которые стоит продолжать преследовать.
Ещё одна вещь
Прежний нарратив об ИИ в научных исследованиях был очень похож на суперстудента: учитель ставит задачи, а он отвечает за их решение.
То, что хочет делать AI Has Taste, больше похоже на исследовательскую группу: люди задают границы и ценностные суждения, а агенты находят проблемы, проверяют проблемы, ошибаются, опровергают себя, оставляют локальные результаты и затем предлагают следующую проблему.
Если этот маршрут продолжит работать, важнейшее разделение труда между человеком и машиной в будущих фундаментальных исследованиях может измениться с «люди отвечают за мышление, ИИ отвечает за вычисления» на более сложную структуру: люди отвечают за цели, ценности и конечную ответственность; ИИ берёт на себя крупномасштабный поиск, проверку, управление неудачами и генерацию кандидатных исследовательских направлений; формальные инструменты и публичные доказательства отвечают за то, чтобы результаты можно было проверять.
После того как ИИ сможет решать проблемы, следующим препятствием, возможно, действительно станет: сможет ли ИИ выбирать проблемы?
Эта статья взята из публичного аккаунта WeChat «Xin Zhi Yuan», автор: Xin Zhi Yuan