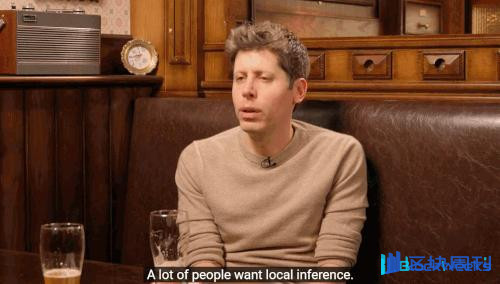
«С точки зрения глобального распределения ресурсов, ситуация, когда каждый хранит дефицитную DRAM в своём собственном компьютере, простаивающую большую часть времени, — это „весьма ужасное“ решение; память должна быть сосредоточена в облачных центрах обработки данных».

Он действительно зашёл так далеко.
В этот четверг в интервью для YouTube-канала Cheeky Pint генеральный директор OpenAI Сэм Альтман всё время пил пиво, в непринуждённой атмосфере беседуя о локальном инференсе больших ИИ-моделей и возникшей в связи с этим проблеме нехватки памяти в домашних компьютерах, и невзначай выдал сенсационное заявление.
Как известно, скачок цен на память, вызванный текущей глобальной волной ИИ, уже привёл к резкому росту цен на ПК и смартфоны, сделав их недоступными для отдельных потребителей. В то же время расширение мощностей крупными производителями памяти займёт некоторое время. Как раз в тот момент, когда передовые ИИ-компании забирают львиную долю памяти, они уже начали обсуждать, полностью ли используется память в персональных компьютерах.
Альтман упомянул гипотетический сценарий, в котором люди могли бы запускать локальный ИИ на своих собственных компьютерах — компьютерах, которые у них, возможно, уже есть, или которые они хотят собрать из-за подъёма технологии больших ИИ-моделей. Он считает, что это плохая идея.
«С точки зрения глобального распределения ресурсов, ситуация, когда каждый оставляет ограниченную мировую DRAM простаивающей в своём собственном компьютере с загрузкой всего 5%, на самом деле довольно ужасна», — сказал Альтман. «Если вы хотите работать в условиях, когда предложение этого ресурса крайне ограничено, то в облаке вы должны максимизировать использование ресурсов. Но по какой-то причине интуиция многих людей прямо противоположна».
Сегодня основной бизнес OpenAI основан на закрытых моделях, работающих в крупномасштабных центрах обработки данных, и его защита бизнес-модели своей компании вызвала дискуссию во всём ИИ-сообществе.
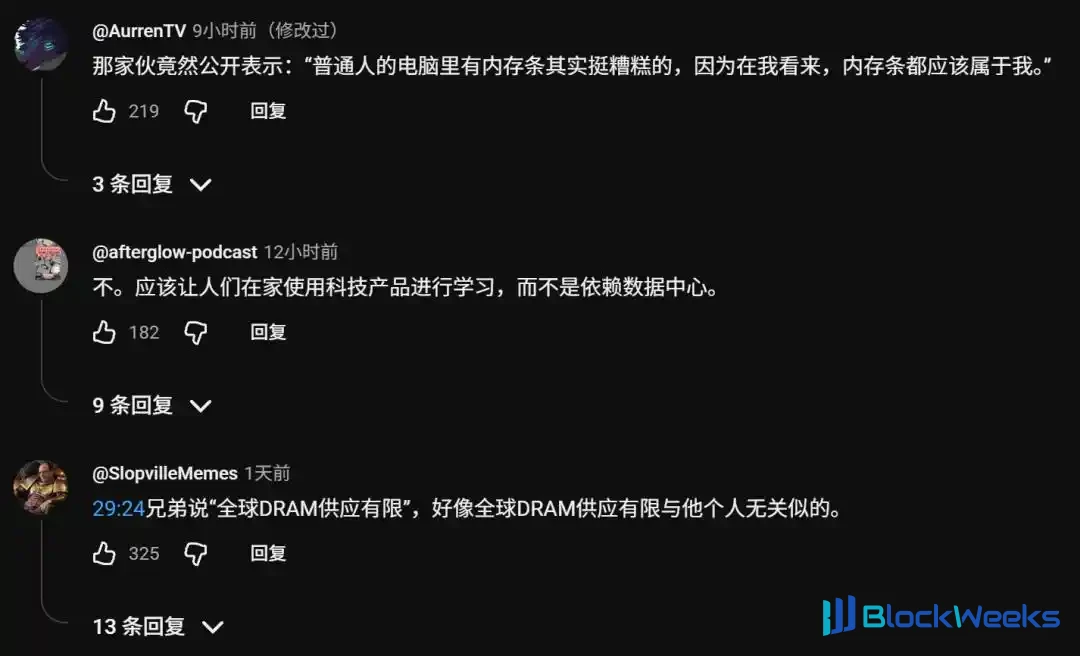
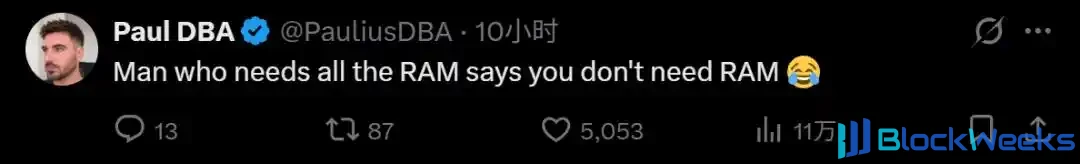
Это также вызвало обеспокоенность у многих: в будущем нам может стать ещё труднее владеть собственным оборудованием или программным обеспечением, и мы, возможно, сможем рассматривать только аренду облачных агентов и компьютеров.
Хотя память, используемая в обычных ПК, смартфонах и картах ИИ-ускорителей, не одинакова, их производство конкурирует за часть мощностей по выпуску пластин на вышестоящем уровне. Альтман рассуждает о распределении глобальных ресурсов DRAM, и когда речь заходит о том, кто имеет право решать, где используется память, в большинстве случаев это, естественно, клиент, размещающий более крупный заказ.
Некоторые взгляды Альтмана основаны на предположении, что строительство центров обработки данных не замедлится. Он также предполагает, что память, используемая круглосуточно для ИИ-центров обработки данных, ценнее, чем память, используемая для электронных таблиц, просмотра веб-страниц, игр или даже occasional локального ИИ.
На самом деле это интервью было очень долгим, и Альтман также говорил об уязвимости PHP, вызвавшей глобальную панику за последние две недели, о песочницах для обучения моделей и об ИИ-исследованиях в математике.
Давайте посмотрим, что он в основном сказал:
ИИ запускает волну уязвимостей
Что касается огромной уязвимости в PHP, суждение Альтмана таково: способность больших моделей обнаруживать уязвимости продолжает быстро расти, а поверхность кода в интернете чрезвычайно обширна. Когда люди начнут систематически использовать ИИ для сканирования всего кода, «мы окажемся в мире, где серьёзных уязвимостей гораздо больше, чем ожидалось». Он считает, что одного лишь исправления недостаточно и что архитектуры необходимо перестраивать — маршрутизаторы, операционные системы и прикладной уровень — всё нужно перепроектировать для мира, где «уязвимости станут всё более интеллектуальными». Два года назад «переписать весь технологический стек» всё ещё звучало безумно; теперь уже появились стартапы, стремящиеся построить совершенно новые стеки.
Он редко предлагал самокритику отрасли: «Я не думаю, что мы хорошо объяснили людям, почему все потенциальные риски этой технологии того стоят». Он сказал, что нарратив ИИ-индустрии — это плохая продажа: с одной стороны, обещание вылечить рак и снизить издержки, а с другой — изображение будущего безработицы, потери контроля и необходимости жёсткого регулирования. Он повторил, что OpenAI настаивает на итеративном развёртывании и противостоянии избытку возможностей, потому что «несколько квадратных миль людей в Сан-Франциско» не должны принимать все решения.
На вопрос, можно ли построить для моделей «тюрьму максимальной безопасности», Альтман дал пессимистичный ответ: песочницы эффективны лишь до определённой степени, а мониторинг (включая проверку цепочек рассуждений и мониторинг активаций) может пойти дальше, но в конечном итоге должно быть высокое доверие к выравниванию.Он задал встречный вопрос: когда вы сталкиваетесь с моделью в миллионы раз умнее самого умного исследователя безопасности, способной открывать новую науку, которую люди ещё не понимают, неужели вы действительно осмелитесь доверять этой песочнице?
Он прямо сказал, что ненавидит термин «рои агентов», потому что рой вызывает ассоциации с саранчой, и настаивал на том, чтобы называть их командами агентов. Он считает, что взаимные сдержки и противовесы между командами точно соответствуют механизму достижения устойчивости через плюрализм, и что это направление безопасности, заслуживающее pursuit.
Взрыв интеллекта и цена научных открытий
Альтман обрисовал кривую: в эпоху GPT-4 было трудно эффективно потратить даже 1 доллар вычислений на одну задачу; цепочка рассуждений позволила моделям «усердно думать», и теперь мы можем запускать целую команду агентов параллельно десятки тысяч раз. Разрыв в использовании между обычными пользователями и самыми продвинутыми пользователями постоянно растёт.
О том, как OpenAI распределяет вычисления внутри компании, он сказал, что сотрудники пользуются большой свободой, но высокое потребление токенов никогда не вознаграждается: «Быть высоко в таблице лидеров по токенам на самом деле немного неловко; это уж точно не причина для повышения». Он привёл в пример доказательство уравнений Навье — Стокса: одно доказательство стоило около 10 миллионов долларов, и в тот период всё «вышло из-под контроля на неделю», потому что тогда никто ничего не знал о законах масштабирования команд агентов. Но он ожидает, что через год, с более умными моделями и методами, это можно будет повторить за 1/100 стоимости.
Он также редко проявлял эмоции: ситуация в то время была поистине невероятной. В выходные, когда внутри компании запускалась некая новая модель, все бросали в модель всевозможные самые трудные задачи, и она действительно решала их одну за другой. Люди вовсе не ожидали, что модель способна на такие вещи. Вместе они стали свидетелями того, как многие из самых трудных научных проблем в академических карьерах людей решались одна за другой этой моделью, охватывая несколько разных областей, и зрелище было просто поразительным.
«Две ночи я почти не спал, потому что был так взволнован, что просто не мог уснуть. Многие из результатов, которые мы позже опубликовали, на самом деле были теми задачами, решёнными тогда».
В то время Альтман чувствовал чрезвычайное воодушевление и радость, одновременно испытывая неожиданную грусть, меланхолию и ощущение «эпоха подходит к концу». Это была не просто ностальгия, но и сопереживание духу человеческих учёных «услышать Дао утром — и умереть довольным вечером». Он настаивает, что человечество заслуживает доступа к базовым знаниям, но отрасль обязана предложить решение практикам в этих областях.
Хотя говорить о сверхинтеллекте ещё слишком рано, Альтман считает, что триллион слегка сверхчеловеческих ИИ лучше, чем один с триллионом IQ:
«Я гораздо охотнее интуитивно предпочёл бы, чтобы в общество влился триллион ИИ со слегка сверхчеловеческим интеллектом, чем один ИИ с триллионом IQ, присоединившийся к обществу».
"Интуитивно я предпочёл бы, чтобы в общество влился триллион ИИ со слегка сверхчеловеческим интеллектом, чем один ИИ с IQ в триллион."
Его аргумент таков: сильная устойчивость общества проистекает из того, что большое число членов проверяют, уравновешивают и сотрудничают друг с другом; мир "единого мозга" не обладает такой устойчивостью. Но он подчёркивает, что это не произойдёт автоматически и должно активно продвигаться.
Рыночная корректировка больше не работает в эпоху ИИ?
Касаясь глобальной нехватки памяти, Альтман рассказал о планах OpenAI: собственные чипы (повышение производительности интеллекта на ватт), собственные дата-центры, робототехнические проекты и ещё более смелая концепция — "самовоспроизводящиеся дата-центры", которые использовали бы ИИ для управления роботами для эксплуатации фабрик, строительства турбин и солнечных панелей и возведения дата-центров. Он заявил, что "это уже в пределах нашей досягаемости".
На вопрос, почему "рынок сам себя регулирует" так медленно материализуется, он сказал, что текущий прогресс довольно плох, и привёл поведенческую логику производителей памяти: эта отрасль долгое время была тяжёлым бизнесом — инвестировать 20 миллиардов долларов в капзатраты, чтобы заработать 1,9 миллиарда, и исторически гиганты неоднократно оказывались на грани банкротства из-за перепроизводства заводов. Сегодня каждая компания может зарабатывать около 100 миллиардов долларов свободного денежного потока в год, но болезненные воспоминания делают их крайне консервативными в расширении производства. Поэтому он утверждал, что "невидимая рука сейчас терпит неудачу".
Он различил два типа возможностей в чиповой индустрии: для литографии "кажется, только одна компания на Земле знает, как это делать", но проектирование чипов (файлы, которые в конечном итоге отправляются на фабрику) уже является отличным случаем применения ИИ.
Говоря о реальном уровне рекурсивного самоулучшения (RSI), Альтман сказал, что модели теперь могут выполнять такие задачи, как "поиск 5% улучшения вычислительной эффективности", но никто пока не знает, как заставить ИИ открыть новую архитектуру уровня трансформера; не хватает более умных моделей. Он даже предсказал, что обществу, возможно, потребуется на некоторое время договориться об ограничении IQ отдельной модели, "и если будущий прогресс окажется недостаточным, это будет следствием этого решения, а не способности ИИ проводить исследования".
Он изложил свою дефляционную веру: текущая пятилетняя совокупная стоимость владения каждым ГВт передовых ИИ-вычислений составляет около 70 миллиардов долларов, и было бы ещё лучше, если бы её удалось снизить до 20 миллиардов, при этом модели всё ещё должны улучшать производительность ещё в 10 раз каждый год. Путь к достижению этого — сделать энергию дешевле и сжать накопленные наценки между "от песка до выходных токенов".
Что касается беспокойства предприятий по поводу бюджетов на токены, он считает, что сегодня более распространённая проблема — не слишком частое использование ИИ, а недостаточное.
Как следует устанавливать цены на персональных агентов?
Что касается недавно популярных продуктов персональных агентов (таких как Muse), текущее суждение Альтмана таково: "момент Macintosh ещё не наступил". Людям нравятся эти продукты, но они ещё не достигли точки "я не могу представить жизнь без этого". Победная форма будет напоминать текущие продукты, но "это просто будет работать", надёжно и способно справляться с более сложными задачами. Что касается игры в кошки-мышки вокруг computer use, он считает, что в конечном итоге всё сойдётся к тому, что "у вас есть право позволить ИИ управлять вашим собственным компьютером от вашего имени".
Что касается коммерциализации агентов, Альтман считает, что предприятия держатся за ИИ-всплывающие окна и HTML внутри своих продуктов, опасаясь потери отношений с клиентами, но потребители хотят, чтобы ИИ делал всё от их имени внутри их основного чат-приложения. Он считает, что настоящий ров происходит от бренда, выбора продукта и сетей фулфилмента, а не от HTML. Он добровольно заявил, что выбирает Amazon Pay 10 раз из 10, даже по более высокой цене, и похвалил сеть фулфилмента Amazon, признав при этом, что партнёрские платформы внутри ChatGPT недостаточно хороши. Он также назвал все веб-формы "фальшивой работой" и сравнил настоящее с эпохой App Store того времени.
Именно по этой причине при разработке ценообразования OpenAI почти последовала AWS в выставлении счетов по задачам и полностью отказалась от оплаты на основе токенов, но столкнулась с сильным сопротивлением клиентов: "Мне нужно знать, за что я плачу", даже если они платят больше, они хотят понятную единицу — токены.
Справочные материалы:
https://www.tomshardware.com/tech-industry/data-centers/openai-ceo-says-its-quite-terrible-for-your-pc-to-have-ram-sam-altman-says-data-centers-offer-better-utilization
https://www.youtube.com/watch?v=iMsUcCYNKqY
Эта статья взята из официального аккаунта WeChat "Machine Heart" (ID: almosthuman2014), автор: Zenan