Коротко
- Anthropic випустила Claude Sonnet 5.5 у понеділок за ціною 2 долари за мільйон вхідних токенів і 10 доларів за мільйон вихідних токенів — без змін порівняно з Sonnet 5 і вдвічі дешевше за Opus 5.5.
- Sonnet 5.5 набрав 70,6% на Terminal-Bench 4.0 проти 66,4% в Opus 5.5, за даними Anthropic; незалежний тестувальник Artificial Analysis також ставить його попереду — 63,6% проти 59,6%.
- Artificial Analysis ставить його на друге місце після Opus 5.5, але зазначає, що він використовував більше токенів на завдання, ніж будь-яка модель, яку вони тестували.
Anthropic випустила Claude Sonnet 5.5 у понеділок — оновлення до Sonnet 5 з червня. Anthropic стверджує, що ця модель середнього рівня працює більш ніж на 30% швидше за свою попередницю.
«Sonnet 5.5 найсильніший у чітко окреслених повсякденних завданнях, виправленні помилок і створенні відшліфованих документів, слайдів і електронних таблиць. Він також має гостре око на дизайн», — написала Anthropic.
Ціна залишається на рівні $2 за мільйон вхідних токенів і $10 за мільйон вихідних токенів. Токени — це фрагменти тексту, які ШІ читає та записує, трохи коротші за слово, і компанії виставляють рахунки за мільйони. Це половина того, що стягує Opus 5.5. Однак він використовує майже на третину менше токенів на завдання, що означає, що в результаті його запуск дешевший, ніж Sonnet 5.
Втім, ця модель сяє в програмуванні. На Terminal-Bench 4.0 — тесті на те, чи може ШІ-агент самостійно виконати складні професійні завдання, вводячи команди, з оцінкою як частка виконаних завдань — Sonnet 5.5 досяг 70,6%. Opus 5.5 набрав 66,4%, а Sonnet 5 — 10,3%.
Простіше кажучи, дешевша модель виконала більше завдань. Artificial Analysis, незалежна тестувальна фірма, провела власну версію та погоджується: 63,6% для Sonnet 5.5, 59,6% для Opus 5.5 і 59,1% для GPT-6 Astra від OpenAI.
Claude Sonnet 5.5 (max) робить великі кроки на Terminal-Bench, перебуваючи серед найкращих моделей як для Terminal-Bench 4.0, так і для Terminal-Bench-Science. У Terminal-Bench 4.0 він набирає 64%, що на 50 пунктів більше, ніж Claude Sonnet 5 (max), і трохи вище 60% для Opus 5.5 та GPT-6… pic.twitter.com/7CPrhgmfxe
— Artificial Analysis (@ArtificialAnlys) 28 вересня 2026 року
Оцінки також залежать від налаштування зусилля — регулятора, який змушує модель думати довше для кращої відповіді та більшого рахунку. Anthropic стверджує, що Sonnet 5.5 на високому рівні зусилля зрівнюється з GPT-6 Sol на FrontierCode приблизно за п'яту частину вартості за завдання.
На GDPval-AA, який оцінює реальну професійну роботу в 44 професіях за допомогою Elo — шахової системи, що ранжує відносну майстерність — Sonnet 5.5 набрав 1844 проти 1846 в Opus 5.5, що фактично є нічиєю. GPT-6 Sol набрав 1487.
Конкуренти відповідають на ціну. OpenAI знизив ціну GPT-6 Sol до $2 і $10 минулого тижня, а GPT-5.6 Terra, його модель середнього рівня, коштує $2 і $12. Anthropic не опублікував жодних бенчмарків Terra.
Підступ
Sonnet 5.5 — великий балакун. На максимальному зусиллі він написав близько 193 000 токенів на тестове завдання — найбільше, що вимірював Artificial Analysis, і приблизно на 60% більше, ніж Opus 5.5. Це склало $7.60 за завдання, приблизно на 50% більше, ніж Sonnet 5, що суперечить заяві Anthropic про економію до 30%.
Економія Anthropic походить від нижчих налаштувань: на середньому зусиллі, яке є типовим у його застосунках, він стверджує, що Sonnet 5.5 перевершує найкращий результат Sonnet 5 у програмуванні менш ніж за десяту частину вартості. Artificial Analysis каже, що високе зусилля — найкраще співвідношення ціни та якості. Для звичайних користувачів це означає програмування майже флагманського рівня за частку ціни, якщо регулятор залишається низьким.
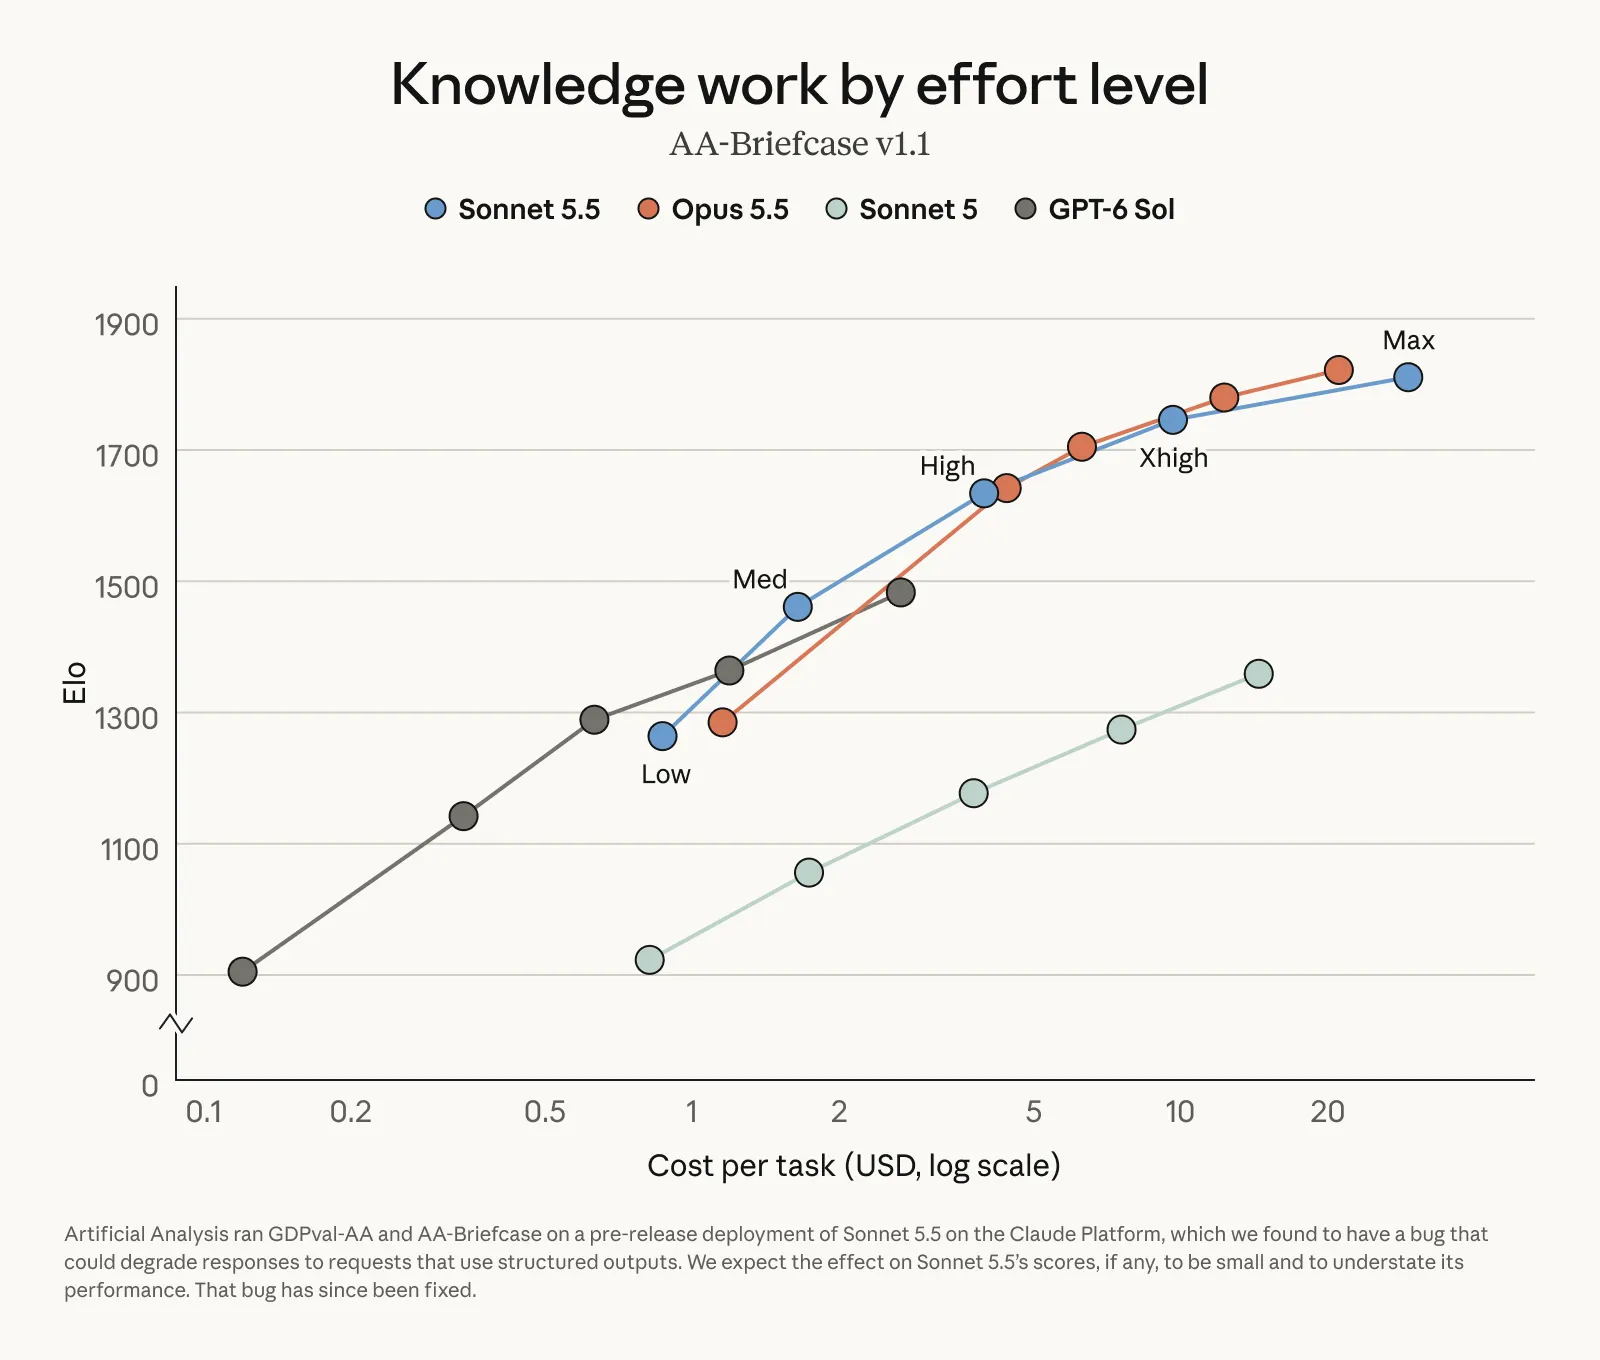
Таблиця Anthropic є самостійно задекларованою, і Artificial Analysis тестувала передрелізну збірку з помилкою, яка, за очікуваннями Anthropic, мало або дещо занизила її оцінки. Anthropic стверджує, що Opus 5.5 залишається явно сильнішим у складній роботі, яка потребує тривалого судження.
Claude Haiku 5.5, створений для високооб'ємних, чутливих до витрат застосунків, очікується найближчими тижнями.