KI-Mathematik überschreitet eine sehr subtile Trennlinie.
In der Vergangenheit fragten wir: Kann ein großes Modell ein schwieriges Problem lösen? Kann es einen rigorosen Beweis schreiben? Kann es ein Gegenbeispiel finden, das Menschen seit Jahrzehnten nicht entdeckt haben?
Jetzt ist eine Frage aufgetaucht, die eher der „Forschung selbst“ ähnelt: Wenn ein Beweisweg fehlschlägt, weiß die KI, was als Nächstes zu tun ist? Sollte sie weiter rechnen, den Weg wechseln, die Aussage einschränken oder einfach eine neue, falsifizierbare mathematische Vermutung vorschlagen?
AI Has Taste, entwickelt vom Forscher Zeng Zijian von der UCSI University, versucht, diese Frage in ein nachhaltiges Forschungssystem zu verwandeln.
Das öffentliche Repository des Projekts verzeichnet derzeit 453 mathematische Forschungsmanuskripte und 2.312 Seiten Inhalt, von denen 6 ausdrücklich als „AI-Proposed Conjectures“ klassifiziert sind.
Die auf der Startseite des Repositorys angegebene Positionierung ist noch direkter: From Answer Generation to Research-Agenda Generation – von der Generierung von Antworten zur Generierung von Forschungsagenden.
KI widerlegte eine Vermutung in einer Arbeit, und der Originalautor bestätigte dies per Antwort
AI Has Taste begann nicht mit der Überzeugung, dass „KI gut in Mathematik sein muss“. Zeng Zijian erinnerte sich, dass er zu Beginn des Projekts nicht sicher war, ob große Modelle die mathematische Forschung wirklich voranbringen könnten. Ein zufälliger Test wurde zum Wendepunkt: Er übergab der KI direkt eine Vermutung aus einer Arbeit, ursprünglich nur, um zu sehen, wie weit das Modell gehen würde. Infolgedessen fuhr die KI nicht fort, entlang der Arbeit zu „beweisen“, sondern konstruierte ein Gegenbeispiel, das die Vermutung direkt widerlegte.
Seine erste Reaktion war nicht Aufregung, sondern Unglaube. Also organisierte er das Gegenbeispiel und die Herleitung und schrieb dem Autor der Originalarbeit, um es zu verifizieren. Die daraufhin erhaltene Antwort bestätigte: Dieses Gegenbeispiel ist gültig. Die entsprechende Forschung wurde später in die aktuellen mehr als 450 mathematischen Manuskripte aufgenommen.
„Zuerst glaubte ich nicht an die Macht der KI in der Mathematik. Bis ich eine Vermutung aus einer Arbeit eingab und die KI direkt ein Gegenbeispiel lieferte, um sie zu widerlegen; ich schrieb sofort dem Originalautor, und die andere Seite antwortete und bestätigte, dass es korrekt war. Danach ließ ich wirklich los und ging all in.“ — Zeng Zijian
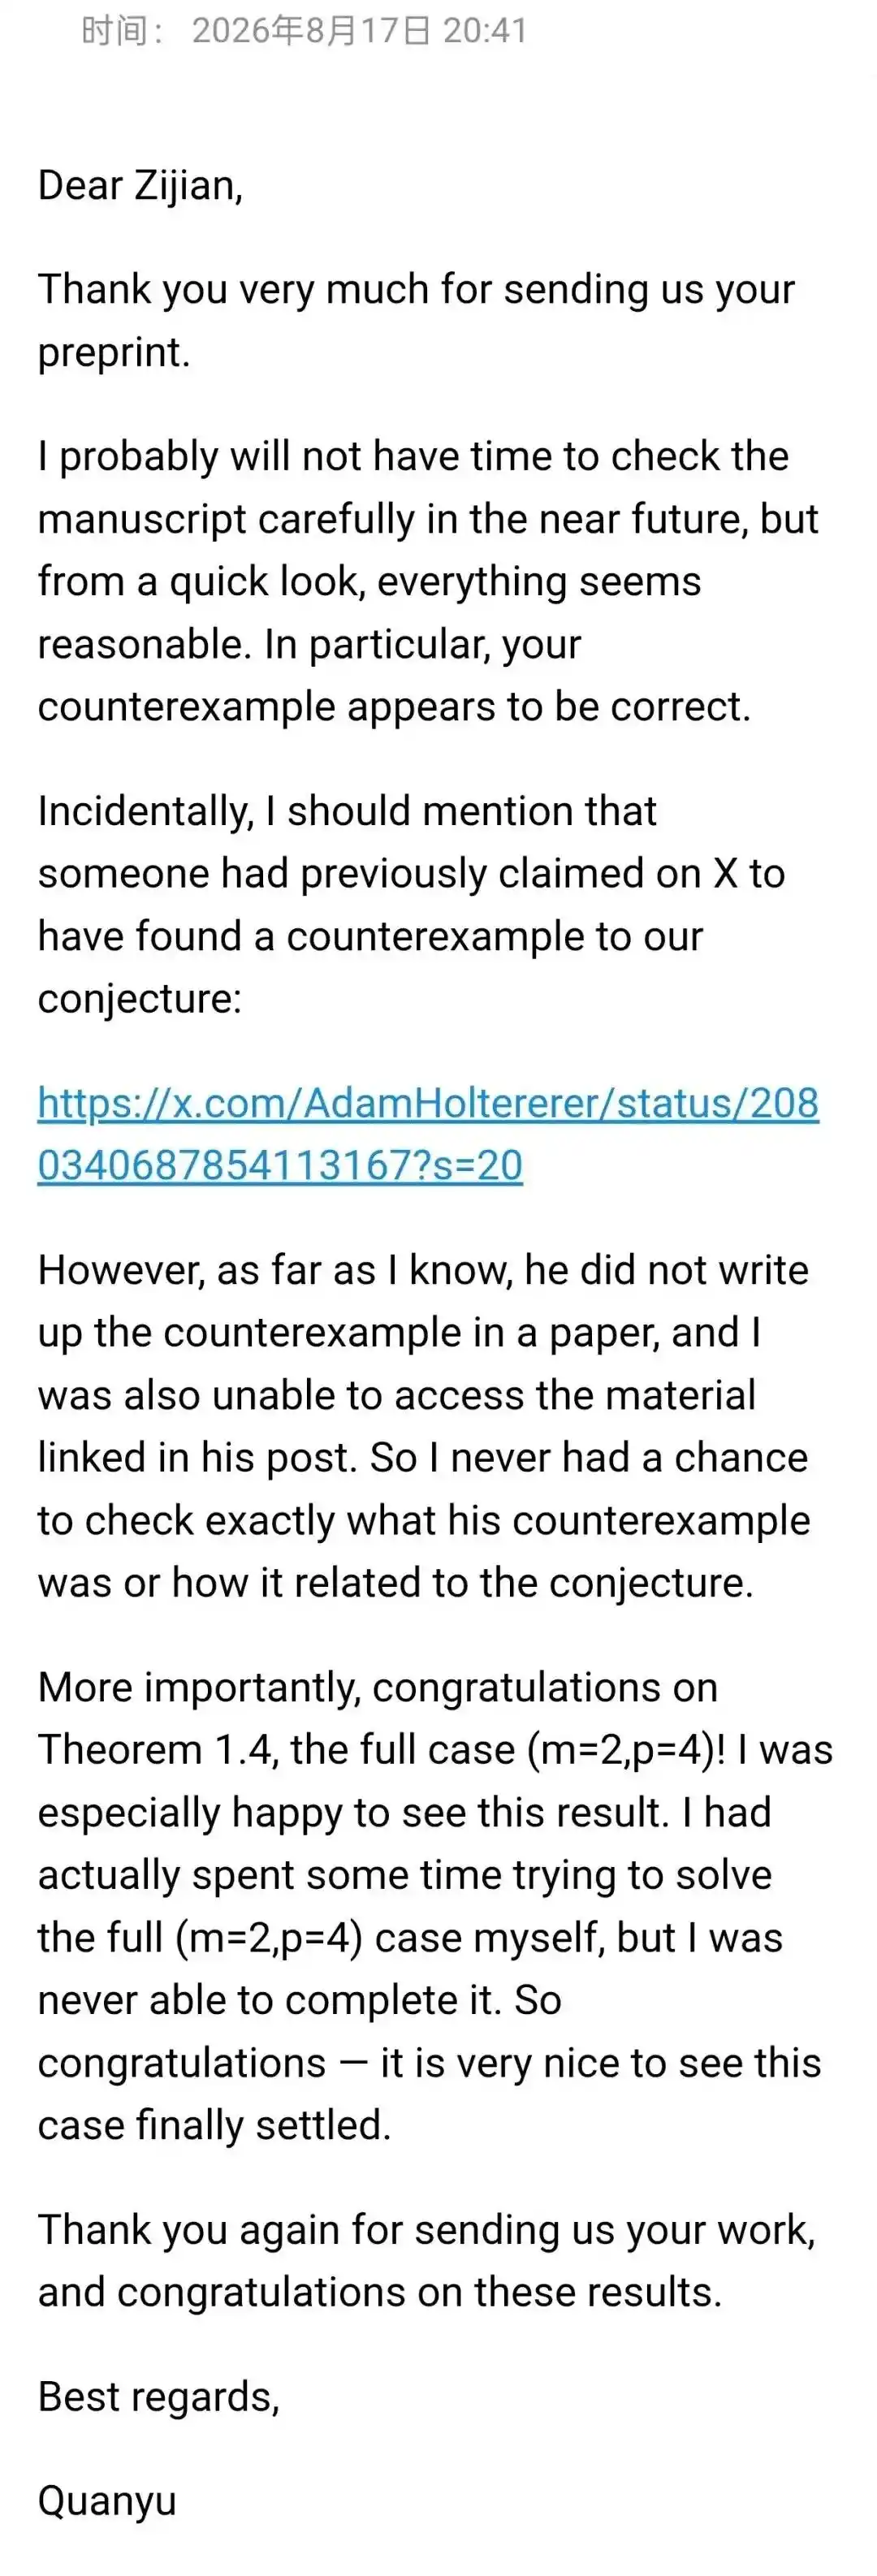
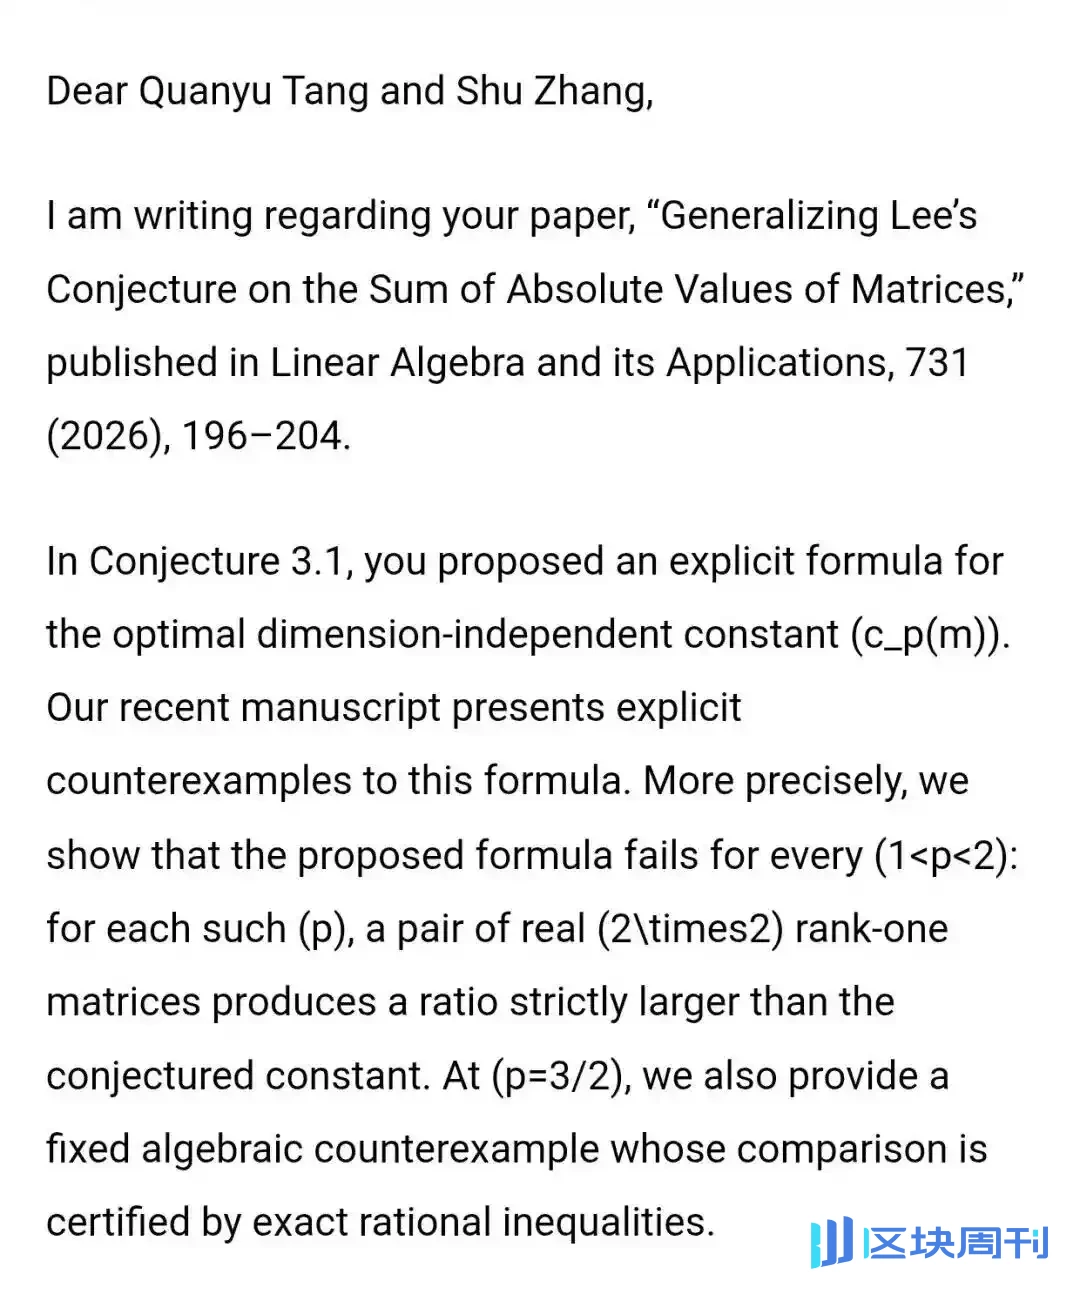
Was diese E-Mail änderte, war nicht eine einzelne Vermutung, sondern der Maßstab des Projekts. Wenn die KI nicht nur bekanntes Wissen wiedergeben und Text generieren kann, der wie ein Beweis aussieht, sondern auch aktiv neue Vermutungen in Arbeiten angreifen und ein vom Originalautor bestätigtes Gegenbeispiel finden kann, dann hat sie die Chance, wirklich in den „Forschungskreislauf“ einzutreten. Danach begann Zeng Zijian, Themenauswahl, Beweis, Gegenbeispielsuche, Fehlermanagement, unabhängige Überprüfung und Schreiben schrittweise zu agentifizieren und verschiedene Maschinen langfristig parallel laufen zu lassen.
Die wahre Veränderung ist nicht „wie viele Arbeiten geschrieben wurden“
Allein von der Menge her sind 453 Manuskripte bereits auffällig genug. Aber wenn dieses Projekt nur als „KI schreibt mathematische Arbeiten in Stapeln“ verstanden wird, dann verpasst man den bemerkenswertesten Teil.
Das Projekt selbst betont wiederholt: 453 ist die Anzahl der „Forschungsmanuskripte“, was nicht bedeutet, dass alle 453 ursprünglichen offenen Probleme gelöst wurden. Die Ergebnisse umfassen vollständige Beweise, Gegenbeispiele, Teilergebnisse, Zertifikate endlicher Berechnungen, strukturierte Reduktionen und Arbeiten, die neue Vermutungen vorschlagen. Die interne KI-Überprüfung ist auch nicht gleichbedeutend mit einer externen Peer-Review.
Die eigentliche Veränderung findet in der Forschungskette statt. Traditionelle KI-Benchmarks beginnen oft bei „das Problem ist bereits gegeben“: Menschen wählen das Thema, die KI löst es, und am Ende steht Erfolg oder Misserfolg. AI Has Taste erweitert den Prozess sowohl nach vorne als auch nach hinten – die KI kann Kandidatenprobleme filtern, Routen vergleichen und aktiv nach Gegenbeispielen suchen; wenn eine Route scheitert, kann sie auch die Struktur des Scheiterns analysieren, die Aussage modifizieren und neue mathematische Objekte an einen anderen unabhängigen Agenten weitergeben, der den Angriff fortsetzt.

Der Schlüssel zu AI Has Taste ist nicht „mehr Prompts“, sondern das Scheitern in Input für die nächste Forschungsrunde zu verwandeln.
Themenauswahl-, Beweis-, Fehlerfindungs- und Schreib-Agenten
Dieses System ist nicht „ein Modell, das sich in einem einzigen Dialogfeld selbst Fragen stellt und beantwortet“. Die öffentliche README teilt die Agentenrollen in vier Ebenen auf:
Supervisor / Screener ist für die Auswahl von Kandidaten, den Vergleich nahegelegener Ergebnisse und das Finden des kostengünstigsten entscheidenden Experiments verantwortlich;
Researcher ist für Beweise, Gegenbeispiele und exakte Berechnungen verantwortlich;
Fresh-context Reviewer greift gezielt eingefrorene Aussagen, Schlüssellemmata und Zertifikate in einem neuen Kontext an;
Writer / Release Checker ist dafür verantwortlich, den endgültig akzeptierten Umfang klar zu formulieren und Zitate, Builds und Veröffentlichungsmaterialien zu prüfen.
Zeng Zijian setzte den Workflow darüber hinaus als Multi-Maschinen-Zusammenarbeit um: Verschiedene Maschinen können getrennt voneinander Beweise vorantreiben, nach Gegenbeispielen suchen, exakte Berechnungen durchführen und unabhängige Überprüfungen vornehmen. Geteilt werden eingefrorene Aussagen, Experimentaufzeichnungen, Fehlergründe, Code und Belege, anstatt einen Agenten Ergebnisse generieren und diese selbst absegnen zu lassen.

Das Kerndesign von Multi-Agent: Rollentrennung + gemeinsame Belege + Fresh-context-Review.
Es gibt einen Satz im Repository, der dieses Design sehr gut zusammenfasst: Kritik ist Teil des Motors, nicht ein Nachwort. Kritik ist kein Verfahren, das nach dem Schreiben der Arbeit hinzugefügt wird, sondern ein Teil des Forschungsmotors.
Mathematiker, Robotiker und Automatisierungswissenschaftler treten in die Verifikationskette ein
Als die Forschungsmanuskripte von Dutzenden auf Hunderte anwuchsen, wurde eine weitere Frage schärfer: Wer beurteilt, dass diese Agentenausgaben keine systematischen Halluzinationen sind?
AI Has Taste verwendet intern einen Fresh-context Reviewer, um „Forschung“ und „Fehlerfindung“ zu trennen, aber das Projekt betrachtet die KI-Selbstüberprüfung nicht als Endpunkt.
Im weiteren Verlauf der Arbeit begann Zengzaijian auch, echte Wissenschaftler aus verschiedenen Bereichen einzuladen, sich an der Verifikation, Überprüfung und akademischen Diskussion einiger Ergebnisse zu beteiligen.
Nach Angaben des Projektteams umfassen die an einem Teil der Arbeit beteiligten Mitarbeiter und Gutachter: Ong Seng Huat, Fellow der Akademie der Wissenschaften Malaysia und Honorarprofessor am Institut für Mathematische Wissenschaften der Universität Malaya; Kurunathan Ratnavelu, Fellow der Akademie der Wissenschaften Malaysia und Honorarprofessor am Institut für Mathematische Wissenschaften der Universität Malaya; und Professor Xiong Yonghua von der School of Artificial Intelligence and Automation, China University of Geosciences (Wuhan).
Hier ist es notwendig, zwischen „an der Verifikation teilnehmen“ und „alle Ergebnisse befürworten“ zu unterscheiden: Die oben genannten Wissenschaftler haben nicht alle 453 Manuskripte einzeln abgesegnet, sondern einige der Probleme, Beweise, Berechnungsergebnisse oder Forschungsrichtungen verifiziert, überprüft oder diskutiert.
Für ein hochgradig automatisiertes wissenschaftliches Forschungssystem ist diese Kombination aus „internem maschinellem Red Team + stichprobenartiger Überprüfung/Review durch menschliche Experten“ im Gegenteil entscheidender, als die gesamte Überprüfung an denselben Satz von Agenten zu übergeben.
KI ist dafür verantwortlich, die Forschungsgeschwindigkeit an die Grenze zu treiben; menschliche Experten sind dafür verantwortlich, „scheint gültig“ an Schlüsselknotenpunkten zurück zu „glaubwürdig“ zu ziehen.
Nach dem Scheitern wurde eine bessere Frage gewählt
Der Fall im Projekt, der „Forschungsgeschmack“ am besten verkörpert, ist gerade kein schöner Erfolg, sondern ein Misserfolg.
Beim Problem der fraktionalen Gaußschen Spur versuchte das System zunächst Monotonie- und einseitige Paarungsrouten, aber es tauchten immer wieder exakte Gegenbeispiele auf. Ein gewöhnlicher Benchmark würde hier normalerweise nur ein Label hinterlassen: FAILED.
Aber dieser Workflow hörte nicht auf. Der Agent fragte weiter: Was genau hat das Gegenbeispiel durchbrochen? Hat das Scheitern eine stabile Struktur? Am Ende verlagerte die Forschung die Aufmerksamkeit auf einen festen negativen Defekt, konstruierte eine zehngliedrige Korrekturstruktur und schlug eine neue einheitliche Beschränktheitsvermutung vor. Noch entscheidender ist, dass die neue Vermutung dann wiederum durch eine weitere Runde exakter Berechnung und unabhängiger Überprüfung angegriffen wurde. Der öffentliche Archivscan erreichte Index 1004; diese einheitliche Schranke ist bis heute nicht bewiesen.
Die Bedeutung dieser Sache ist nicht, dass „KI ein weiteres großes Theorem bewiesen hat“ – tatsächlich hat sie das nicht. Die Bedeutung ist: Das ursprüngliche Problem wurde nicht gelöst, aber die gescheiterte Route wurde zu einer neuen Aussage komprimiert, die klarer, besser falsifizierbar ist und, sobald sie gilt, wieder an das ursprüngliche Problem anknüpfen kann. Die Forschung endete nicht beim Scheitern, sondern ließ aus dem Scheitern das nächste Problem wachsen.
Früher: Menschen stellten die Probleme, KI beantwortete sie. Jetzt: KI beantwortet Probleme und beginnt auch, daran mitzuwirken, zu entscheiden, „was das nächste Problem ist“.
6 neue KI-Vermutungen
Nach dem aktuellen öffentlichen Snapshot klassifiziert das Repository 6 Arbeiten separat unter „AI-Proposed Conjectures“. Diese Arbeiten erstrecken sich über Kombinatorik, Graphentheorie, Zahlentheorie und analytische Probleme, darunter die Nichtsingularität unendlicher Binärkernmatrizen für drei Teilfolgen von A182510, CDS-Färbbarkeit von Young-Diagrammen, Zerlegung dreiecksfreier Graphen mit Maximalgrad höchstens 6, unäre Theta-Kongruenzformeln für 18-farbige verallgemeinerte Frobenius-Partitionen, Nichtnegativität der Newton-Koeffizienten für reziprok-subsummierte Nenner über dyadische Stufen und die bereits erwähnte Festdefekt-Vermutung für die fraktionale Gaußsche Spur.
Was wirklich Beachtung verdient, ist nicht, ob KI eine Vermutung „durch Brainstorming erzeugen“ kann. Mal eben einen Satz zu raten, ist nicht schwer. Schwer ist, die Vermutung in eine präzise Definition zu fassen, zu erklären, woher sie kommt, welche Evidenz sie stützt, welche Gegenbeispiele sie umstoßen könnten, zu welchen Ergebnissen sie führen würde, falls sie gilt, und die Berechnung sowie den Quellcode für die spätere Überprüfung zu hinterlassen.
Das ist auch der Grund, warum das Projekt „Vermutungen vorzuschlagen“ als eine höherstufige Forschungsaktion ansieht als „Antworten zu erzeugen“: Beweise beantworten bestehende Fragen, während Vermutungen verändern, wohin die nachfolgenden Forschungsressourcen fließen.
Hinter 453 Manuskripten steht der Prototyp „agentenmaßstäblicher wissenschaftlicher Forschung“
AI Has Taste hat derzeit 453 Forschungsmanuskripte mit insgesamt 2312 Seiten öffentlich veröffentlicht; darunter entspricht allein der BigWIN2-Workflow 223 Manuskripten und stellt für diese 223 Arbeiten gepaarte LaTeX-/Reproduktionsmaterialpakete bereit.
Das Kontraintuitivste an diesem Umfang ist nicht, dass „KI schnell tippt“. Was in der mathematischen Forschung wirklich teuer ist, ist der Kontextwechsel: Dieses Problem erfordert Graphentheorie, das nächste Zahlentheorie, und das übernächste vielleicht SAT, erschöpfende Suche, exakte rationale Arithmetik oder Matrixberechnung. Ein menschlicher Forscher kann nicht gleichzeitig Hunderte völlig unterschiedlicher Gedankengänge aufrechterhalten, aber ein Agentensystem kann sie in unabhängige Aufgaben aufteilen und gescheiterte Routen, lokale Theoreme und reproduzierbare Experimente bewahren.
Somit verändert sich die Rolle des einzelnen Forschers: nicht jeden Schritt selbst herzuleiten, sondern eher wie ein PI – Forschungsgrenzen zu setzen, den Problempool auszuwählen, zu entscheiden, welche Ergebnisse es wert sind, weiter investiert zu werden, wann aufzuhören ist und welche Schlussfolgerungen es verdienen, öffentlich gemacht zu werden.
Warum heißt es "AI Has Taste"?
"AI has taste" klingt sehr anthropomorph, aber die README des Projekts zieht bewusst eine Grenze: Geschmack bedeutet hier nicht Bewusstsein oder subjektive Erfahrung, sondern "mathematisches Urteilsvermögen, das sich durch Forschungsentscheidungen ausdrückt".
Zum Beispiel: Wenn beide Probleme bearbeitet werden können, welches zuerst? Eine Route hat bereits lokale Fortschritte erzielt, aber die Grenzerträge werden immer geringer – sollte man aufhören? Ist ein Gegenbeispiel ein Todesurteil für die Aussage, oder zeigt es, dass das eigentliche Theorem anders formuliert werden sollte? Reicht ein kleines Ergebnis aus, um als eigenständige Arbeit zu bestehen? Diese Entscheidungen waren früher meist implizit in der Erfahrung der Forscher enthalten und ließen sich mit standardisierten Benchmarks kaum messen.
AI Has Taste versucht, eine überprüfbare Spur dieser Entscheidungen zu hinterlassen: welches Problem gewählt wurde, warum die Route geändert wurde, welche Struktur das Scheitern hinterlassen hat, woher die nächste Aussage kam und wie die neue Schlussfolgerung erneut durch einen unabhängigen Kontext angegriffen wurde.
Wie weit ist es von einem "autonomen Mathematiker" entfernt?
Die Stelle, an der dieses Projekt am leichtesten übertrieben wird, muss ebenfalls klargestellt werden. 453 Manuskripte sind nicht 453 Zeitschriftenartikel, die ein formelles Peer-Review durchlaufen haben; ein internes Agenten-Review ist nicht gleichbedeutend mit einer unabhängigen Überprüfung durch die mathematische Gemeinschaft; und der von endlicher Berechnung abgedeckte Bereich kann nicht automatisch auf den unendlichen Fall verallgemeinert werden. Das Repository selbst nennt diese Einschränkungen ausdrücklich.
Aber wenn man seine Art der Forschungsorganisation ignoriert, nur weil diese Ergebnisse nicht alle eine externe Verifizierung abgeschlossen haben, würde man auch eine weitere Veränderung verpassen: Die Grenze der KI-Fähigkeiten verschiebt sich von "eine gegebene Aufgabe ausführen" zu "an der Gestaltung der nächsten Aufgabe teilnehmen".
Die wirklich knappen Ressourcen in der mathematischen Forschung waren nie nur Rechenleistung und Argumentationslänge, sondern auch: Welche Probleme sind es wert, Zeit in sie zu investieren, welche Fehlschläge sind es wert, bewahrt zu werden, und wann sollte das Thema gewechselt werden.
Wenn die KI beginnt, in diese Bereiche einzutreten, geht es im Wettbewerb um "AI for Math" nicht mehr nur darum, "wer besser beweisen kann", sondern wird sich allmählich zu der Frage wandeln: Wer hat einen besseren Forschungszyklus, und wer kann aus einer großen Zahl von Fehlschlägen die Richtungen destillieren, die es eher wert sind, weiter verfolgt zu werden.
One More Thing
Die bisherige Erzählung von KI in der wissenschaftlichen Forschung glich sehr einem Superstudenten: Der Lehrer stellt die Aufgaben, und er ist dafür verantwortlich, sie zu lösen.
Was AI Has Taste tun möchte, gleicht eher einer Forschungsgruppe: Menschen liefern Grenzen und Werturteile, und Agenten finden Probleme, testen Probleme, machen Fehler, widerlegen sich selbst, hinterlassen lokale Ergebnisse und schlagen dann das nächste Problem vor.
Wenn diese Route weiter Bestand hat, könnte sich die wichtigste Mensch-Maschine-Arbeitsteilung in der künftigen Grundlagenforschung von "Menschen sind für das Denken zuständig, KI für das Rechnen" zu einer komplexeren Struktur wandeln: Menschen sind für Ziele, Werte und letztendliche Verantwortung zuständig; KI übernimmt groß angelegte Suche, Verifizierung, Fehlermanagement und die Generierung möglicher Forschungsrichtungen; formale Werkzeuge und öffentliche Belege sind dafür verantwortlich, Ergebnisse überprüfbar zu machen.
Nachdem KI Probleme lösen kann, könnte die nächste Hürde wirklich sein: Kann KI Probleme auswählen?
Dieser Artikel stammt vom WeChat-öffentlichen Account "Xin Zhi Yuan", Autor: Xin Zhi Yuan